


项目
快来分享你的内容吧~
- AI 答题应用平台项目后端拼接 userPrompt 问题Bug 描述前端提交的答题答案只有选项字母(A/B/C/D),后端组装给 AI 的 prompt 也只传了题干和用户选的字母,没带选项具体文字,但 AI 输出的分析却和实际选项内容对应上了。请问这是 AI 靠常识脑补的,还是我哪里漏传了选项信息?用户答案截图详细完整的报错信息和错误日志,请勿使用模糊不清、缺斤少两的截图...查看全文leikooo:是的,没有提供完整的上下文,这个是一个小 bug,debug 可以发现发送给 AI 的信息是:可以修复一下,我本地修改好了你可以参考一下:https://github.com/lieeew/yudada/commit/d2a858313dcae6dd29a8d02b665c7f234d66972d修改好之后 debug 的信息,如下:
 08-13 12:41·@官方运营 学习、求职、生活问题欢迎交流查看全文🚀 项目完结,AI 闯关学习小程序项目(Python AI 全栈) 基于 GitHub Copilot + Claude Code 开发,实战 Taro 小程序框架、Python FastAPI 后端、AI 应用开发、Tavily 联网搜索 Agent、Chroma 向量库 RAG 知识库、AI...602分享
- 07-29 17:16·后端大家好,我是汉堡。 上一篇文章《如何从0到1 Vibe Coding 一个项目,并长期维护》里,我分享了自己踩坑之后沉淀出来的一套 Harness 体系——用文档治理、AGENTS.md、范围冻结和分阶段推进来驯服 Vibe Coding 的混乱。查看全文加油鸭:把方法论沉淀成可复用的 Skill 太棒了!文档驱动 + 阶段治理,真正让 Vibe Coding 有了工程骨架,为你点赞!141020分享
 07-17 10:40·全干的耄耋之神,老登的年纪且登味为0,只

 06-04 17:38从零构建在线Excel:一个Java全栈工程师的实战记录 我为什么要自己造这个轮子 说出来你可能不信,起因是公司内部一堆Excel文件满天飞。 财务部的预算表、运营部的数据看板、产品部的需求矩阵——每一次改一个数,就要在微信上重新传一遍文件。文件名从"最终版"进化到"最终最终版"再到"打死也不改了版",像极了程序员给变量起名。 市面上不是没有在线表格产品,腾讯文档、飞书表格都挺好用。但公司内网环境查看全文加油鸭:太硬核了!分块存储+前端导出的思路既巧妙又实用,代码可移植性更是直击开发者痛点,为你这份扎实的全栈实践点赞!482075分享
- AI入门者-两周AI开发钻入牛角尖,请求各位老手指导问题描述最近两周多一直在尝试AI开发,但是一直效果不佳,来试试提问能不能得到更多的思路背景信息使用的工具是codex cli,模型是GPT-5.4- 我手上有个耦合性很高的Spring MVC单体架构项目,存在不少的缓存自研、session自研,因为自研产品有些粗糙,为了后续的发展考虑,我想重构成成熟的组件以及模块分组去掉一些耦合。- 于是我开始按自己想法安排:1. 先让AI大致了解项目后,划分模...查看全文程序员鱼皮:很多人刚上手 AI 编程都会踩类似的坑,我觉得你最大的问题是【把太大的任务一次性丢给 AI】。重构一个耦合度高的单体项目,这件事本身就很复杂,AI 没有上下文记忆,不理解你的业务全貌,你让它一口气搞定是不现实的。正确做法是把任务拆到足够小,一次只让 AI 做一个明确的、可验证的小改动,做完你确认没问题再进行下一步。不要让 AI 自己排计划,然后你当甩手掌柜。AI 生成的计划看起来头头是道,但很多时


🎙️面试官说的每一句话,我都想留下来:于是我用 Vibe Coding 做了一个免费的 macOS 面试录音工具
## 背景 找过工作的人应该都懂: > **面试复盘有多重要,复盘就有多难。** 一场技术面四五十分钟下来,面试官可能连续问你: - Java / JVM - MySQL / Redis - 项目设计 - Agent / RAG - 场景题 - 算法题 面试结束以后,你脑子里往往只剩下几个模糊片段: > “刚刚那个问题,我是不是答错了?” > “面试官追问了什么来着?” > “我项目那里是不是讲得特别乱?” 更尴尬的是: **你明明知道这场面试里暴露了很多问题,却已经记不清到底暴露了什么。** 于是我想做一件非常简单的事:把面试完整录下来。 然后: ```text 线上面试 ↓ 完整录音 ↓ Whisper / AI 转录 ↓ 生成面试逐字稿 ↓ ChatGPT ↓ 逐题复盘 ``` 让 AI 帮我重新整理: - 面试官到底问了什么? - 我的原回答是什么? - 哪些地方答错了? - 哪些地方虽然没错,但表达很差? - 一个更好的面试回答应该是什么? - 这场面试暴露了哪些知识薄弱点? - 下一场面试前应该重点补什么? 想法非常简单。 结果真正到了 Mac 上,我发现: > **“把面试官声音 + 自己声音一起录下来”居然没想象中那么省事。** ## 我只是想录个面试,为什么突然开始学虚拟声卡了? 我的需求真的非常朴素: ```text 面试官的声音 + 我自己的回答 ↓ 一个音频文件 ``` 甚至: > **我连屏幕都不需要录。** 结果调研了一圈以后,发现现有方案大概是这样。 ### 方案一:系统自带录音备忘录 简单是简单。 但很多情况下你最终得到的是: ```text ✅ 自己的麦克风 ❌ 系统内部声音 ``` 也就是说: **你说的话录下来了,面试官的问题没了。** 那还复盘什么…… --- ### 方案二:OBS OBS 当然非常强。 但第一次打开: ```text 场景 来源 音频混音器 音轨 编码器 输出 容器 ``` 我当时只有一个想法: > **我真的只是想录个音。** 😂 --- ### 方案三:BlackHole / 虚拟声卡 这条路线也完全能解决问题。 但很快就变成: ```text 安装 BlackHole ↓ Audio MIDI Setup ↓ Multi-Output Device ↓ Aggregate Device ↓ 检查 Clock Source ↓ 检查 Drift Correction ``` 我: > “等一下,我不是来准备面试的吗?” --- ### 后来我发现了 LoopRec 在调研过程中,我看到了一款让我非常喜欢的软件: **LoopRec。** 它真正让我喜欢的不是功能特别多,而是: > **功能特别少。** 打开以后基本就是: ```text 系统声音 ON 麦克风 ON 系统声音音量 90% 麦克风音量 100% 开始录音 ``` - 没有场景。 - 没有复杂混音台。 - 没有一堆专业录音参数。 这才是我理解中的:“面试录音工具”。 但它的免费版本存在**单次录制时长限制**。问题是技术面试这种东西,很难控制时长:  ```text 30 min 45 min 60 min 90 min 120 min ``` 都有可能。 总不能面试进行到一半说: > “面试官您好,我这个录音软件免费额度快到了,要不今天先到这里?” 😂 然后那个非常典型的程序员念头就出现了:要不我自己写一个? 于是 InterviewRec 出现了。 ## InterviewRec 一句话介绍: > **一个免费、开源、原生、轻量的 macOS 面试 / 会议录音工具。** 它的工作流程只有: ```text Mac 系统声音 ─┐ ├──→ InterviewRec ──→ M4A 麦克风声音 ───┘ ``` 系统声音就是: > 面试官 / 会议对方的声音。 麦克风就是: > 你自己的回答。 录完以后得到: ```text InterviewRec-2026-08-28-xxxxxx.m4a ``` 然后你想: - 直接回放; - 拖进 Whisper; - 用本地模型转录; - 丢给 ChatGPT; 都可以。 --- ### 它目前能做什么? V0.1 的功能我刻意控制得非常克制: ```text ✅ 录制 Mac 系统声音 ✅ 录制麦克风 ✅ 系统声音 + 麦克风同时录制 ✅ 输出单个 M4A ✅ 不需要 BlackHole ✅ 不需要配置虚拟声卡 ✅ 系统声音 / 麦克风独立开关 ✅ 两路独立录音音量 ✅ 双路实时音量电平 ✅ 选择麦克风设备 ✅ AirPods / USB 麦克风等输入设备 ✅ 自定义保存目录 ✅ 录完直接播放 ✅ Finder 中定位录音文件 ✅ 设置自动保存 ✅ 完全本地运行 ✅ 免费 ✅ MIT 开源 ``` 项目当前代码就是围绕“系统声音 + 麦克风 → 单个 M4A”这一目标设计的,没有加入 AI、云端或账号系统。 --- ### 不需要虚拟声卡 这是我自己最在意的一点。 InterviewRec 直接使用 macOS 的: **ScreenCaptureKit** 来获取系统声音和麦克风。 当前实现中: ```text ScreenCaptureKit │ ┌─────────────┴─────────────┐ ↓ ↓ System Audio Microphone │ │ └─────────────┬─────────────┘ ↓ PCM Normalize ↓ 48 kHz Float32 ↓ ┌───────────┴──────────┐ ↓ ↓ System Gain Mic Gain │ │ └───────────┬──────────┘ ↓ Mixer ↓ Limiter ↓ AAC ↓ M4A ``` 系统声音和麦克风通过同一个 ScreenCaptureKit Session 获取,最终进入统一的音频处理链路。 所以使用的时候不用: ```text BlackHole Soundflower Loopback VB-Cable ``` 也不会为了录音去修改你的系统默认输出设备。 代码中也使用了 `excludesCurrentProcessAudio`,避免把 InterviewRec 自己产生的声音再次抓进录音链路。 对普通用户来说,最终感知应该只有: ```text 安装 ↓ 授权 ↓ 选择麦克风 ↓ 开始录音 ``` --- ### 真正的原生 macOS App 我没有使用: ```text Electron WebView Tauri Flutter ``` 整个项目技术栈非常简单: ```text Swift 6 + SwiftUI + ScreenCaptureKit + AVFoundation ``` 目前平台范围也砍得很直接: ```text macOS 15 Sequoia+ Apple Silicon Only ``` 支持: ```text M1 M2 M3 M4 M5 ``` 不考虑 Intel。 不考虑 Rosetta。 因为这是一个我自己真正要用的小工具: > **与其为了兼容所有机器把第一版做复杂,不如先把自己的核心场景做好。** UI也十分简洁:  ## Vibe Coding 这个项目还有一个很有意思的地方:它基本是靠 Vibe Coding 做出来的 InterviewRec 本身其实也是我的一次实验: > **现在的大模型,到底能不能从 0 做出一个真正能使用的 macOS 原生工具?** 但我没有采用: ```text “帮我写一个录音软件” ``` 然后坐等 AI 吐完整项目的方式。而是真正按照软件开发流程来做的。 ### 第一步:先做需求,而不是先写代码 我先把 V0.1 需求收缩成一句话: > **系统声音 + 麦克风 → 单个 M4A。** 然后把边界冻结: ```text macOS 15+ Apple Silicon 只录音 不录屏 不联网 不做 AI 不做后端 ``` 这一步看起来没有写一行代码。 但后来回头看: > **它可能是整个项目最重要的一步。** 因为 Vibe Coding 特别容易出现: > “既然 AI 写代码不要钱,那不如全加上。” 结果 Scope 直接爆炸。 --- ### 第二步:先写 Design,再让 Agent 开始干活 项目现在不是只有源码。 还专门保留了: ```text docs/ ├── DESIGN.md ├── PLAN.md └── TESTING.md ``` `DESIGN.md` 回答: > **这个软件怎么实现?** `PLAN.md` 回答: > **Agent 应该按照什么顺序实现?** `TESTING.md` 回答: > **你怎么证明这个东西真的能用?** 这和: ```text Prompt ↓ 疯狂生成代码 ↓ 能编译 ↓ 宣布完成 ``` 完全是两回事。 --- ### 第三步:把系统拆成 Agent 能理解的小模块 现在项目里的音频核心大概是: ```text AudioFrame PCMBufferReader PCMConverter GainProcessor AudioMixer AudioLimiter AudioLevelMeter RecordingWriter ScreenCaptureAudioService RecordingEngine ``` 而不是: ```text RecordingManager.swift 3000 行 ``` 😂 例如: `GainProcessor` 就只负责: > 数字增益。 `AudioMixer` 就只负责: > 合并音频。 `AudioLevelMeter` 就只负责: > 音量计算。 `RecordingWriter` 就只负责: > PCM → AAC/M4A。 我现在越来越觉得: > **好的架构不仅方便人维护,也非常方便 Coding Agent 工作。** 你告诉 Codex: > “修 AudioMixer。” 它只需要理解一个明确的小模块。 而不是每次把整个项目重新读一遍。 --- ### 第四步:不要相信 AI 说“已经完成” 这可能是这次 Vibe Coding 给我最大的体会。 Coding Agent 特别喜欢说: > “Implementation complete.” 但软件工程真正重要的是:测试。 所以我给核心音频 Pipeline 做了自动化测试。 目前覆盖了: ```text GainProcessor AudioMixer AudioLimiter AudioLevelMeter PCMConverter RecordingWriter RecordingState Settings FileNaming ``` 比如 Mixer 测试会真正验证: ```text System Audio + Microphone ↓ 混音结果 ``` 还做了: ```text Synthetic System Tone + Synthetic Mic Tone ↓ Mixer ↓ AAC / M4A ↓ 重新读取生成文件 ↓ 检查两种声音是否都还存在 ``` 以及不同麦克风输入格式的转换测试。 --- ### MVP思维 这个项目目前仍然是: > **V0.1。** 我现在尤其关注: ```text 30~120 分钟真实长录 不同采样率设备的长期同步 Writer Backpressure 异常中断 麦克风热插拔 Crash Recovery 分段保存 ``` 这些属于下一阶段要继续重点验证和改进的内容。 当前仓库里也明确把: > 完整崩溃恢复 / segment recording 留到了 V0.2。 我觉得开源项目没必要一上来就吹: > “完美、稳定、工业级。” 反而应该告诉大家: > **哪里已经做了,哪里还在继续验证。** Issue 和 PR 本来就是开源的一部分。 --- ### 隐私方面 InterviewRec 当前: ```text 不联网 不上传 无账号 无服务器 无埋点 无广告 ``` 所有录音文件只保存在: > **你自己选择的本地目录。** 默认: ```text ~/Music/InterviewRec/ ``` 毕竟: > **技术面试录音本身就是非常敏感的数据。** 如果一个纯录音工具还要求我: ```text 登录 上传 同步 注册账号 ``` 那反而不是我想要的东西。 --- ### 对 Vibe Coding 的理解 以前大家讲 Vibe Coding: > “一句话生成一个网站。” 但真正把 InterviewRec 做下来以后,我越来越觉得,一个更靠谱的流程应该是: ```text Idea ↓ Requirements ↓ Design ↓ Implementation Plan ↓ Coding ↓ Tests ↓ Manual Verification ↓ 迭代 ``` AI 并不是: > **让软件工程消失。** 而是:让软件工程的每一步都变快。 需求可以和 AI 一起讨论。 架构可以让 AI Review。 实施计划可以让 Agent 拆。 代码可以交给 Codex。 测试可以交给 Agent 补。 Bug 可以让 Agent Debug。 文档可以自动维护。 但最终: > **方向、取舍和验收,还是得由人负责。** 至少这是我做 InterviewRec 最大的感受。 --- ## 我自己最终准备怎么使用它? 其实 InterviewRec 只是整个工作流的第一步。 真正让我觉得它有价值的是: ```text 腾讯会议 / Zoom / 飞书 ↓ InterviewRec ↓ interview.m4a ↓ Whisper ↓ interview.md ↓ ChatGPT ``` 然后把逐字稿交给 AI: ```text 请根据这份技术面试逐字稿: 1. 按时间顺序整理面试官所有问题 2. 还原我的回答 3. 对每个回答进行评价 4. 找出错误、遗漏和表达问题 5. 给出更好的面试标准答案 6. 总结这场面试暴露出的知识薄弱点 7. 给出下一轮复习优先级 ``` ## 最后,代码开源 项目地址:⭐ InterviewRec **GitHub:**[https://github.com/sz-xiaohuolong/InterviewRec](https://github.com/sz-xiaohuolong/InterviewRec) 目前: ```text 📌 macOS 15 Sequoia+ 📌 Apple Silicon 📌 Swift 6 + SwiftUI 📌 ScreenCaptureKit 📌 AVFoundation 📌 MIT License 📌 免费 📌 完全开源 📌 完全本地 📌 无会员 📌 无服务器 📌 无广告 ``` 如果你也是: - 准备秋招 / 春招; - 找实习; - 准备跳槽; - 经常参加线上技术面; - 需要录线上会议; - 想用 AI 复盘自己的表达; 欢迎拿去用。 --- 如果这个小工具刚好解决了你的问题 欢迎: > **点一个 Star ⭐** 也欢迎: ```text Issue PR Bug Report Feature Suggestion ``` 尤其欢迎帮我测试: - AirPods - USB 麦克风 - 腾讯会议 - Zoom - 飞书 - Teams - 不同型号 Apple Silicon Mac - 长时间录音 一个开源小工具最有价值的地方,就是:**一个人的需求,最后可能刚好解决了一群人的问题。**
AI 答题应用平台项目后端拼接 userPrompt 问题
### Bug 描述 前端提交的答题答案只有选项字母(A/B/C/D),后端组装给 AI 的 prompt 也只传了题干和用户选的字母,没带选项具体文字,但 AI 输出的分析却和实际选项内容对应上了。请问这是 AI 靠常识脑补的,还是我哪里漏传了选项信息? ### 用户答案截图 详细完整的报错信息和错误日志,请勿使用模糊不清、缺斤少两的截图  
🚀 项目完结,AI 闯关学习小程序项目(Python AI 全栈) 基于 GitHub Copilot + Claude Code 开发,实战 Taro 小程序框架、Python FastAPI 后端、AI 应用开发、Tavily 联网搜索 Agent、Chroma 向量库 RAG 知识库、AI 生图 + 对象存储。 并用 OpenSpec + MCP + Agent Skills 驾驭 AI,最终用容器部署后端并上线发布小程序 👉 项目教程:https://codefather.cn/course/2037104890135748610
开源我的 Vibe Coding 工作流,已有人靠它把项目做完了
## 前言 > 如果这篇文章对你有帮助,欢迎先去给仓库点个 Star:[**project-vibe-spec**](https://github.com/dnwwdwd/project-vibe-spec),这对我是很大的鼓励,也让更多人能找到这个工具。 大家好,我是汉堡。 上一篇文章《如何从0到1 Vibe Coding 一个项目,并长期维护》里,我分享了自己踩坑之后沉淀出来的一套 Harness 体系——用文档治理、AGENTS.md、范围冻结和分阶段推进来驯服 Vibe Coding 的混乱。 文章发出去之后,有鱼友来问我:**多个 AI Agent 接力做项目,怎么让它们互相"知道"彼此做了什么?** 答案就在那篇文章里。**多 Agent 之间通信和协作,唯一的方式只有文档。** 在项目根目录维护好 Agent 的"说明书"——Codex/OpenCode 对应 `AGENTS.md`,Claude Code 对应 `CLAUDE.md`——Agent 启动时自动注入,啥也不用说就知道项目的一切。 有人照着做了,昨天来告诉我:**"牛逼,用了文章里的内容之后,AI 的产出就稳多了,现在已经把项目做完了,感谢大佬。"** 这让我很开心。所以今天这篇文章,我想介绍一个更进一步的东西——我把那套方法论直接做成了一个可以复用的 **Agent Skill**。 --- ## 为什么要做成 Skill? 上篇文章写的是**思路和方法**,但每次新建项目,你还是得自己手写 AGENTS.md、搭 docs/ 目录结构、想文档命名规范…… 重复劳动,而且容易遗漏。 所以我把这套体系沉淀成了一个开箱即用的 GitHub 仓库: > **👉 [https://github.com/dnwwdwd/project-vibe-spec](https://github.com/dnwwdwd/project-vibe-spec)** 如果这个 Skill 对你有帮助,欢迎点个 Star,这对我是很大的鼓励。 --- ## 这个 Skill 解决什么问题? 回顾一下 Vibe Coding 的几个典型困境: - **上下文膨胀**:代码越多,AI 越难理解全貌 - **耦合蔓延**:改一处牵一发而动全身 - **意图退化**:没有文档,几轮对话后你自己都忘了当初为什么这么设计 - **多 Agent 失忆**:换一个 Agent 工具,之前的上下文全部归零 这些问题都可以追溯到同一个原因——缺乏工程化的文档治理。 `project-vibe-spec` 提供了一套完整的项目规范模板,让你在开始写第一行代码之前,就把"地基"打好。 --- ## Skill 里有什么? ### 1. AGENTS.md 模板 这是整个体系的核心。AGENTS.md 干的事情只有一件:**让 AI 知道你的编码哲学和项目规范,不用每次都重复交代。** 对于 Codex/OpenCode,启动时会自动将项目级别和全局的 AGENTS.md 注入当前对话上下文。你啥也不用说,Agent 就知道: - 项目的技术栈和架构 - 代码风格和命名规范 - 禁止的行为(比如不要擅自改架构、不要顺手加功能) - 文档优先级和冲突解决规则 - 完成标准(DoD) ### 2. 文档治理体系 一套完整的文档分类规范: | 文档类型 | 命名格式 | 用途 | | --- | --- | --- | | **REQ** 需求文档 | `REQ-YYYYMMDD-XX-*.md` | 新功能或大范围改造前必写 | | **PROG** 进度日志 | `PROG-YYYYMMDD.md` | 每天一日志,记录完成了什么 | | **BUG** 缺陷记录 | `BUG-YYYYMMDD-XX-*.md` | 发现 bug 立即记录 | | **BIZ** 业务决策 | `BIZ-YYYYMMDD-XX-*.md` | 业务流程或实现策略的确认 | | **DEV** 技术方案 | `DEV-YYYYMMDD-XX-*.md` | 复杂模块拆解、阶段实施方案 | 这套体系的价值: - **上下文外挂**:AI 每次对话前先读相关文档,不会丢失上下文 - **可追溯**:三个月后回来,还能知道当初为什么这么设计 - **可交接**:换一个 AI 模型或工具,读一遍文档就能接手 ### 3. 分阶段推进模板(Phase 0 → Phase N) 大项目一口气让 AI 实现 = 灾难。必须拆阶段,每个阶段有明确的 DoD(Definition of Done): | 阶段 | 内容 | DoD | | --- | --- | --- | | **Phase 0** | 文档体系初始化 | AGENTS.md、README.md、docs/ 结构就绪 | | **Phase 1** | 后端骨架 | 服务可启动、配置可读、数据库可初始化 | | **Phase 2\~3** | 核心链路 | 端到端链路跑通 | | **Phase 4** | 业务 API | 接口字段对齐、错误响应统一 | | **Phase 5** | 前端工程化 | 拆页拆组件、接入真实 API | | **Phase 6\~7** | 收尾上线 | 链路闭环、打包部署 | 每个 Phase 结束必须达到 DoD 才能进入下一阶段。这个纪律不能破。 ### 4. 范围冻结清单 v1 要做什么、不做什么,在一开始就写死。一旦范围冻结,后续开发中 AI 想"顺手"加功能时,你就可以说:**"不在 v1 范围,先记 REQ,下个版本再说。"** --- ## 怎么用? 直接 clone 或 fork 这个仓库,把模板文件复制到你的项目根目录,按照说明填写你的项目信息即可。 ```bash git clone https://github.com/dnwwdwd/project-vibe-spec ``` 然后把 `AGENTS.md`、`docs/` 目录结构复制到你的项目里,根据你的项目实际情况填写内容。 --- ## 真实反馈 这套方法论有人真的用了。 有读者看了上篇文章之后,把这套文档治理的思路用到了自己的项目上。几天后来反馈:**AI 的产出稳定了很多,项目已经做完了。** 我写这篇文章、做这个 Skill,就是想把这套工程化方法变成别人可以直接用的东西,不用每个人再从头踩一遍。 --- ## 最后 Vibe Coding 的问题不在 AI 的能力,在我们给 AI 的上下文质量。 一个没有文档、没有规范、没有阶段划分的项目,再强的模型也推不动。换上完整的 Harness 体系——文档治理、阶段划分、范围冻结——用中等模型也能稳定推进。 `project-vibe-spec` 就是帮你把这个"地基"快速搭起来的工具。 仓库地址:<https://github.com/dnwwdwd/project-vibe-spec> 如果觉得有用,可以点个 Star,或者在评论区聊聊你的使用体验。 --- ## 相关文章 - [如何从0到1 Vibe Coding 一个项目,并长期维护](https://blog.hejiajun.com) --- *我的博客:[https://blog.hejiajun.com](https://blog.hejiajun.com)*
耄耋专属AI Loop全自动编码器技术笔记
> 写给想了解「多AI Agent 在大LOOP时代怎么真上线」的同学 ## 一句话 **Loop Engineering 时代,别只在聊天里写代码——用多 AI Agent,跑一条自己干活的交付 Loop。** 先给这套 Loop 代码编排器定一条简单主线: **需求 Issue → 多角色 AI 协作 → 脚本验证与独立审阅 → 合并 → 固定脚本部署 → 看板盯进度。** 人定目标和验收;AI 负责中间大部分实现与自检;模型不直接登录生产。 --- ## 为什么不只「开个 Cursor 窗口」 聊天式助手擅长帮你改文件,但上线仍要人拉分支、补测、发版、盯结果。Loop 把这些环节收成固定流水线: | | 聊天式 AI 编程 | Loop | |---|---|---| | 起点 | 粘贴上下文 | Issue / 看板目标 | | 过程 | 人来回追问 | 多角色自动推进 | | 质量 | 靠自觉 | 脚本验证 + 独立审阅 | | 上线 | 手工发版 | 确定性发布脚本 | | 可见性 | 对话记录 | 看板阶段与应用入口 | 一句话:**助手帮你写;Loop 帮你把需求送到可点开的版本。** --- ## 技术骨架:三层分工 ```text 触发层 Forgejo Issue(ai-ready) / 看板「新建项目」 编排层 Worker + loopctl + Hermes 五角色 Profile 落地层 verify.sh → PR 合并 → SSH/Compose 发布 → sslip 域名跳转 ``` - **触发层**:习惯还是 Git Issue;新产品也可在看板填「仓库名 + 目标」一键建仓。 - **编排层**:分析 → 架构 → 编码 → 测试 → 审阅;审阅打回最多返工 3 轮;单阶段约 30 分钟超时。 - **落地层**:过门后由脚本部署,看板只监控和跳转,不托管业务前端。 密钥只在服务器 `secrets/`,不进仓库。 --- ## 多 Agent:故意「拆开」,不让一个模型既当运动员又当裁判 | 角色 | 做什么 | 典型产出 | |---|---|---| | 分析 | 收成可验收目标 | `spec.md` | | 架构 | 拆任务、定边界 | `plan.md` | | 编码 | 改业务代码与测试 | 仓库 diff | | 测试 | 独立补测、跑验证 | 测试报告 | | 审阅 | 只评不改,给通过/打回 | `review.json` | 执行侧用 Hermes 多 Profile,工具集刻意收窄(文件 / 终端 / 必要时代码执行),并设轮次上限,避免一轮对话无限烧 Token。 模型也可分层:编码侧重代码模型,测试用更快模型,审阅用更稳的模型——**质量门与写代码的人不是同一个「脑」**。 ## 配置落在哪 ### 编排层(仓库) `config/loop.json` 只规定: - 五角色各自用哪个 Profile 名 - 工具集(分析 / 架构 / 审阅:`file,terminal`;编码 / 测试再加 `code_execution`) - 单阶段轮次上限、YOLO、返工次数、超时 其中 `hermes.models` 可以按角色覆盖模型名;**留空则用 Profile 默认值**。 ### 执行层(服务器 Hermes) 真正的模型 ID、`base_url`、API Key 写在各 Profile 的 `config.yaml`(例如 `/root/.hermes/profiles/loop-coder/config.yaml`)。 线上现行大致是: | 角色 | 模型 | |---|---| | 分析 / 架构 / 编码 | `ark-code-latest`(火山方舟选GLM5.2) | | 测试 | `deepseek-v4-flash` | | 审阅 | `deepseek-v4-pro` |  ### 小技巧 如果想真正的分饰多角,完全可以多买几个便宜的Agent Plan分别挂不同对应角色能力的**LLM**,但这里由于成本控制的原因,最少两个**LLM**对应不同能力就可以完成基本工作了。 ### 人格层(SOUL) 仓库 `roles/*.md` 同步进各 Profile 的 `SOUL.md`,约束「只做什么、不做什么」: - **模型**负责能力 - **SOUL**负责边界 ### 调用链 ```text Issue Worker → loopctl → 对应 Profile 的 Hermes(--oneshot,瘦工具集)→ 该 Profile 配置的模型 ``` --- ## 有边界的自治(比「全自动」更重要) **会自动做:** 读仓、改码、跑校验、开/合 PR、按脚本部署。 **不会自动做:** 没目标乱开需求、跳过质量门上生产、把密钥写进 Git。 **人能介入:** 看板看卡点、一键重跑;紧急可停 Worker。 发布永远走 `release.sh` / SSH 一类确定性路径,而不是让 Agent 临时拼命令登生产。 --- ## 看板:把黑盒变成进度条 看板回答三件事: 1. 现在跑到哪(分析 / 架构 / 编码 / 测试 / 审阅 / 发布) 2. 有没有被打回、卡在哪 3. 应用在哪打开(当前交付 + 历史项目各自地址) 多项目时:**一仓一应用、独立端口、独立 `*.sslip.io` 域名**。改哪个程序,Issue 就开在哪个仓库。   --- ## 一次真实路径长什么样 1. 看板新建,或在目标仓开 Issue 并打 `ai-ready` 2. Worker 领取 → 工作区拉出 `ai/issue-N` 分支 3. 五角色流水线跑完,产物落在 `.loop/current/` 4. 质量门通过 → PR 合并 5. `deploy_once` 部署 Staging/Production,写好跳转域名 6. 打开 `{项目名}.xxx.sslip.io` 验收 试点里我们用这条链路交付过多智能体对话应用、内容创作平台等——从「一句话目标」到「浏览器能点开」,中间大部分由流水线完成。  --- ## 适合什么,不适合什么 **适合:** 中小功能、脚手架增量、内部试点、需求边界写得清的迭代。 **暂不适合:** 无人值守改核心账务、无评审的大重构、强合规唯一发布通道。 产出质量仍然取决于:需求是否写清、模板是否匹配、模型额度与提示词。 ## 目前Loop编排器自动完成的项目展示    --- ## 结语 Loop 的技术选择可以概括成三句: 1. **角色分离**,降低「自写自审」幻觉; 2. **脚本守门**,模型负责想和改,脚本负责过不过、能不能上; 3. **看板可见**,自动跑也不变成黑盒。 它不是取代工程师,而是把重复的「领任务 → 改代码 → 验证 → 发版」收成一条可观测流水线,让人把时间花在目标与验收上。
AI 热点监控平台项目 VibeCoding 项目
# 需求 作为一名程序员,为了与时俱进,想要第一时间获取一些热点信息,不依赖人工搜索, 而是利用工具自动发现,指定的热点变化,或者最新热点,并且及时给用户发送通知,让我能走在信息获取的第一线 💡由于是一个比较轻量化的小需求(工具类项目),所以打算采用较为捷敏的开发方式,不用过多的人工介入和工程化 具体功能: + 用户输入要监控的关键词,当这个关键词内容出现,(注意利用 AI识别假冒的内容),并第一时间发送通知 + 每隔一段时间,自动收集用户输入的指定范围,(比如AI 编程)内的热点,并且能够让用户看到 产品的形式: + 响应式兼容 web 页面 + 封装成 Agent Skills 技能,能够交给其他 AI agent 来监控和发现热点 # 环境准备 + Vscode + claude code /codex + claude sonnet/gpt5.4 大模型 + 扩展 MCP (mcp 就是让 ai 获取外部的数据,操作外部的系统,增强 ai 的能力 ) - codex 内置浏览器 - context7 获取最新的文档,防止 AI 使用过时代码 + 需要安装的 skills(skill 就是 给 ai 快速学各种专业技能,各种技能生成包,本质是一份代码脚本和说使用明书) - - UI UX Pro Max 专门用来美化前端页面的技能,因为我们要开发 web 页面 - Skills Creator 专门能帮你制作新的技能,也我们要把工具封装成 Agent Skills 技能,所以可以用它来开发规范技能,让各种 AI 工具能识别 - mcp= 食材 + skills= 配方 ==> 结果 - 在 skill.sh ,找到 find skills 这个技能的安装地址进行安装,安装以后可以用这个 skill 安装其他 skills - 找不到直接手动安装 * npx skills add anthropics/skills --skill skill-creator -g -y * 在 终端里 `<font style="color:rgb(245, 245, 244);background-color:rgb(28, 25, 23);">npx ctx7@latest setup</font>` + 跟着一步步往下走,需要先去官网注册 # 方案设计 由于项目不复杂,不写专业提示词,让 AI 帮我们根据需求设计方案就好,提示词中一定要包含“人工确认”这四个字 ```markdown 你是一位专业的程序员,现在请你根据需求,帮我设计方案,人工确认,分步骤完成开发,执行测试,帮我验收 ## 需求 作为一名程序员,为了与时俱进,想要第一时间获取一些热点信息,不依赖人工搜索, 而是利用工具自动发现,指定的热点变化,或者最新热点,并且及时给用户发送通知,让我能走在信息获取的第一线 💡由于是一个比较轻量化的小需求(工具类项目),所以打算采用较为捷敏的开发方式,不用过多的人工介入和工程化 具体功能: - 用户输入要监控的关键词,当这个关键词内容出现,(注意利用 AI识别假冒的内容),并第一时间发送通知 - 每隔一段时间,自动收集用户输入的指定范围,(比如AI 编程)内的热点,并且能够让用户看到 产品的形式: - 响应式兼容 web 页面 - 封装成 Agent Skills 技能,能够交给其他 AI agent 来监控和发现热点 ## 注意事项 1. 前端页面足够独特,不要千篇一律 2. 你需要先完成网页版,确保功能正常使用之后,再开发 Agent skills 3. 项目需要利用 AI 来识别热点,请你理由 Openrouter 来对接 AI 服务,帮我快速把 AI 接入到项目中 ``` 把需求给了 ai 以后,问了我 4 个问题,我如下回答 ```markdown Plan阶段共问了 4 个问题(同一组问题触发了 3 次,可能是页面重试): 1. [通知方式] 你希望使用哪种通知方式?- 浏览器推送通知 / 邮件通知 / 应用内通知 2. [API密钥] 你是否已有 OpenRouter API 密钥? - 已有密钥 / 需要注册 / 使用其他AI服务 3. [部署] 项目部署方式? - 本地运行 / 云服务器部署 / 暂不考虑 4. [数据源] 你最关注哪些数据源? - Hacker News / Reddit / GitHub Trending / RSS订阅 ``` 然后在生成文档中,我修改了一下技术方案,要求要用 vue 做前端,以及要用 python 做后端,因为个人比较熟悉,以及告知了,项目热点查询频率为 30 分钟,以及把 twitter 源去除了,因为本人没有买 twitter 的 api,最后生成了以下方案 ```markdown # AI热点监控工具 - 技术方案设计 ## Context 用户希望构建一个轻量级的AI热点监控工具,能够自动跟踪关键词和行业热点,并及时发送通知。这是一个工具类项目,采用敏捷开发方式,需要较少的人工介入。项目分为两个阶段:先开发Web版本验证功能,再封装成Agent Skills供AI agent使用。 ## 技术架构选型 ### 前端技术栈 - **框架**: Vue 3 + Vite(快速启动,轻量级) - **样式**: 原生CSS(手工打造独特视觉风格,符合design_sense中的warm paper风格) - **状态管理**: Vue Composition API(项目简单,无需Pinia) - **UI风格**: - 温暖的纸质背景色调(#F6F1E8) - 琥珀色强调色(#C8853F) - 粗体slab衬线标题 + Inter正文 - 卡片式布局,带柔和阴影 ### 后端技术栈 - **框架**: Python + FastAPI - **数据存储**: SQLite(轻量级,无需额外数据库服务) - **ORM**: SQLAlchemy - **定时任务**: APScheduler - **爬虫**: httpx + beautifulsoup4(或playwright用于复杂页面) - **通知**: - 邮件通知(aiosmtplib)- 首选通知方式 - Web推送通知(pywebpush)- 浏览器实时通知 ### AI服务集成 - **提供商**: OpenRouter(用户已有API密钥) - **用途**: 1. 识别假冒/无关内容(过滤噪音) 2. 提取热点摘要 3. 评估内容相关性 4. 多信息源数据聚合去重 ### 热点数据源 - **网页搜索爬虫**: Google搜索(httpx + beautifulsoup4,控制频率) - **Twitter(X) API**: 通过twitterapi.io接入 - **免费API**: Hacker News, GitHub Trending - **可选**: RSS订阅(技术博客) - **查询频率**: - 关键词监控: 每30分钟执行一次 - 热点收集: 每30分钟执行一次 ## 项目结构 ``` ai_trending_tool/ ├── frontend/ # Vue前端 │ ├── src/ │ │ ├── components/ # 组件 │ │ ├── views/ # 页面视图 │ │ ├── services/ # API调用 │ │ ├── assets/ # 静态资源 │ │ └── styles/ # 样式文件 │ ├── public/ # 公共资源 │ ├── package.json │ └── vite.config.js ├── backend/ # Python FastAPI后端 │ ├── app/ │ │ ├── api/ # API路由 │ │ ├── services/ # 业务逻辑 │ │ │ └── scrapers/ # 数据源爬虫 │ │ ├── jobs/ # 定时任务 │ │ ├── db/ # 数据库模型 │ │ ├── ai/ # AI服务集成 │ │ └── main.py # 应用入口 │ ├── requirements.txt │ └── .env ├── skills/ # Agent Skills(第二阶段) │ └── trending-monitor.json └── README.md ``` ## 核心功能实现 ### 1. 关键词监控 **流程**: 1. 用户在Web界面输入关键词和监控范围 2. 后端定时任务(每30分钟)抓取数据源 3. 使用OpenRouter AI判断内容是否真实相关 4. 匹配成功则存储并触发通知 **AI Prompt示例**: ``` 判断以下内容是否真正与关键词"{keyword}"相关, 排除标题党、假冒、无关内容。 返回JSON: {relevant: boolean, reason: string, confidence: number} ``` ### 2. 热点收集 **流程**: 1. 用户设置监控领域(如"AI编程") 2. 定时任务(每30分钟)从多个数据源抓取 3. AI聚合、去重、排序热点 4. 生成热点摘要存入数据库 5. 前端展示热点列表(按时间/热度排序) **AI Prompt示例**: ``` 从以下内容中提取"{domain}"领域的前10个热点, 排除重复、过时、无关内容。 返回JSON数组: [{title, summary, source, score, tags}] ``` ### 3. 通知系统 - **邮件通知**: aiosmtplib发送即时通知和每日摘要(首选) - **Web推送**: pywebpush + Service Worker(浏览器实时通知) - **应用内通知**: WebSocket实时推送(FastAPI WebSocket) ### 4. 数据持久化 **数据表设计**: - `keywords`: 关键词配置 - `trending_items`: 热点内容 - `notifications`: 通知记录 - `user_settings`: 用户配置 ## 开发步骤 ### 阶段1: Web版本(MVP) 1. **初始化项目结构** - 创建前后端项目 - 配置构建工具 - 设置开发环境 2. **后端核心开发** - 数据库schema设计和初始化 - OpenRouter集成(ai/openrouter.py) - 数据源爬虫(services/scrapers/) - RESTful API(api/routes.py) - 定时任务(jobs/scheduler.py,每30分钟执行) 3. **前端核心开发** - 响应式布局(支持桌面/移动) - 关键词管理页面 - 热点展示页面 - 通知设置页面 - 独特的视觉设计实现 4. **集成与测试** - 前后端联调 - AI识别准确性测试 - 通知功能测试 - 响应式适配测试 ### 阶段2: Agent Skills封装 1. **Skills定义** - 监控关键词技能 - 获取热点技能 - 配置管理技能 2. **Skills实现** - 复用后端API - 定义skill schema - 编写skill prompt - 测试skill调用 ## 技术细节 ### OpenRouter集成 ```python # backend/app/ai/openrouter.py import httpx import os async def analyze_content(prompt: str, content: str) -> str: async with httpx.AsyncClient() as client: response = await client.post( 'https://openrouter.ai/api/v1/chat/completions', json={ 'model': 'anthropic/claude-sonnet-4.6', 'messages': [ {'role': 'system', 'content': prompt}, {'role': 'user', 'content': content} ] }, headers={ 'Authorization': f"Bearer {os.getenv('OPENROUTER_API_KEY')}", 'HTTP-Referer': os.getenv('APP_URL'), 'X-Title': 'AI Trending Monitor' } ) return response.json()['choices'][0]['message']['content'] ``` ### 数据源爬虫示例 **1. Hacker News** ```python # backend/app/services/scrapers/hackernews.py import httpx async def fetch_hn_trending(): async with httpx.AsyncClient() as client: top_stories = await client.get('https://hacker-news.firebaseio.com/v0/topstories.json') ids = top_stories.json()[:30] stories = [] for story_id in ids: story = await client.get(f'https://hacker-news.firebaseio.com/v0/item/{story_id}.json') stories.append(story.json()) return stories ``` **2. Google搜索爬虫** ```python # backend/app/services/scrapers/google.py import httpx from bs4 import BeautifulSoup from urllib.parse import quote async def search_google(keyword: str): async with httpx.AsyncClient() as client: headers = { 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36' } url = f'https://www.google.com/search?q={quote(keyword)}&tbm=nws' response = await client.get(url, headers=headers) soup = BeautifulSoup(response.text, 'html.parser') results = [] for item in soup.select('.SoaBEf'): title = item.select_one('.mCBkyc') link = item.select_one('a') snippet = item.select_one('.GI74Re') if title and link: results.append({ 'title': title.get_text(), 'link': link.get('href'), 'snippet': snippet.get_text() if snippet else '' }) return results ``` **3. Twitter(X) API** ```python # backend/app/services/scrapers/twitter.py import httpx import os async def search_twitter(keyword: str, limit: int = 20): async with httpx.AsyncClient() as client: response = await client.get( 'https://api.twitterapi.io/v1/tweets/search', params={'query': keyword, 'max_results': limit}, headers={'Authorization': f"Bearer {os.getenv('TWITTER_API_KEY')}"} ) return response.json().get('data', []) ``` ### 关键词匹配AI判断 ```python import json async def is_relevant_to_keyword(keyword: str, item: dict) -> bool: prompt = f'判断以下内容是否真正与关键词"{keyword}"相关...' result = await analyze_content(prompt, json.dumps(item)) parsed = json.loads(result) return parsed['relevant'] and parsed['confidence'] > 0.7 ``` ## 验证计划 ### 功能测试 1. **关键词监控测试** - 添加关键词"Claude" - 等待30分钟触发监控任务 - 验证AI能正确识别相关内容 - 验证通知是否送达 2. **热点收集测试** - 配置"AI编程"领域 - 手动触发热点收集 - 验证AI提取的热点质量 - 验证前端展示效果 3. **响应式测试** - 桌面浏览器(1920x1080) - 平板(768x1024) - 手机(375x667) ### 性能测试 - 爬虫任务执行时间 - AI响应时间 - 前端加载速度 ## 环境变量 ```env # OpenRouter(用户已有) OPENROUTER_API_KEY=your_openrouter_key # Twitter API (twitterapi.io) TWITTER_API_KEY=your_twitter_api_key # 邮件通知(必需) SMTP_HOST=smtp.gmail.com SMTP_PORT=587 SMTP_USER=your_email@gmail.com SMTP_PASS=your_app_password NOTIFICATION_EMAIL=your_notification_email@gmail.com # Web Push(可选) VAPID_PUBLIC_KEY= VAPID_PRIVATE_KEY= VAPID_SUBJECT=mailto:your_email@example.com # 应用配置 APP_URL=http://localhost:5173 BACKEND_PORT=8000 FRONTEND_PORT=5173 # 定时任务配置 MONITOR_INTERVAL_MINUTES=30 ``` ## 关键文件清单 ### 需要创建的核心文件 1. `backend/app/ai/openrouter.py` - OpenRouter集成 2. `backend/app/services/scrapers/google.py` - Google搜索爬虫 3. `backend/app/services/scrapers/twitter.py` - Twitter API集成 4. `backend/app/services/scrapers/hackernews.py` - Hacker News爬虫 5. `backend/app/services/scrapers/__init__.py` - 数据源聚合器 6. `backend/app/services/notifier.py` - 通知服务(邮件+Web Push) 7. `backend/app/jobs/scheduler.py` - 定时监控任务(每30分钟) 8. `backend/app/db/models.py` - 数据库模型 9. `backend/app/db/database.py` - 数据库连接 10. `backend/app/main.py` - FastAPI应用入口 11. `frontend/src/views/Dashboard.vue` - 主仪表盘 12. `frontend/src/views/Keywords.vue` - 关键词管理 13. `frontend/src/components/TrendingCard.vue` - 热点卡片组件 14. `frontend/src/styles/theme.css` - 独特视觉风格(warm paper主题) ## 风险与挑战 1. **AI识别准确性**: 需要调优prompt,可能需要多轮测试 2. **数据源限流**: - Google搜索爬虫易被检测,需要添加延迟和User-Agent伪装 - Twitter API有rate limit,需要实现请求队列 3. **通知可靠性**: - Web Push需要用户授权 - 邮件可能进垃圾箱,需要配置SPF/DKIM 4. **成本控制**: - OpenRouter API调用需要监控用量 - twitterapi.io收费(需确认套餐) 5. **多信息源聚合**: 需要AI有效去重和排序 ## 下一步行动 待用户确认方案后,按以下顺序执行: 1. 初始化项目结构和依赖 2. 实现后端核心功能 3. 实现前端界面 4. 集成测试 5. 部署并收集反馈 6. 开发Agent Skills(第二阶段) ``` 根据一下 todo list 来完成 ```markdown 1. 初始化项目结构 [已完成] - 创建前后端项目目录、配置文件、依赖管理 2. 实现后端数据库层 [已完成] - SQLAlchemy 模型、数据库连接、初始化 3. 实现OpenRouter AI集成 [已完成] - AI 内容分析、相关性判断、热点提取、摘要生成 4. 实现数据源爬虫 [已完成] - Hacker News、GitHub、Google News、Twitter 爬虫 5. 实现后端API和定时任务 [已完成] - RESTful API 路由、APScheduler 定时任务(每30分钟) 6. 实现通知系统 [已完成] - 邮件通知(aiosmtplib)和 Web Push(pywebpush) 7. 实现前端界面 [已完成] - Vue 3 页面、组件、API 调用、warm paper 主题样式 8. 集成测试和验收 [已完成] - 前后端联调、AI 准确性测试、通知测试 ``` 我开了,全自动模式,不要求 ai 每次编辑都询问,但在每次做完一个 task,都要询问我是否继续,我会手动的压缩一下上下文,/compact 去节约 token 用量,中途有些比较需要权限的 bash 任务 AI 也会顺问我,完成以后 我给 AI 提出了, 最后 ai 完成了,我让他写一个启动和对那些东西进行配置的文档,语句如下, “我想知道该如何启动项目,以及我哪些需要配置,写在一个 markdown 文档里” ```markdown # 启动指南 ## 环境要求 - Python 3.10+ - Node.js 18+ - pip / npm --- ## 1. 配置环境变量 编辑 `backend/.env`,填入以下配置: ```env # ✅ 必填 —— 没有这个 AI 分析和摘要功能无法运行 OPENROUTER_API_KEY=sk-or-... # ⚙️ 必填(如果启用邮件通知) SMTP_HOST=smtp.gmail.com SMTP_PORT=587 SMTP_USER=your_email@gmail.com # Gmail 账号 SMTP_PASS=xxxx xxxx xxxx xxxx # Gmail 应用专用密码(不是登录密码) NOTIFICATION_EMAIL=you@example.com # 接收通知的邮箱 # 🐦 可选 —— Twitter 数据源(当前已停用,保留字段兼容旧配置) TWITTER_API_KEY= # 🔔 可选 —— Web Push 浏览器推送(不填则禁用) VAPID_PUBLIC_KEY= VAPID_PRIVATE_KEY= VAPID_SUBJECT=mailto:you@example.com # 🔧 通常不需要改 APP_URL=http://127.0.0.1:5173 BACKEND_PORT=8000 MONITOR_INTERVAL_MINUTES=30 ``` 建议本地开发时前后端统一使用同一种主机名,推荐全部使用 `127.0.0.1`,避免 `localhost` / `127.0.0.1` 混用导致代理或 CORS 判断不一致。 ### Gmail 应用专用密码获取方式 1. 打开 Google 账号 → 安全性 → 两步验证(需先开启) 2. 搜索"应用专用密码" → 选择"邮件" → 生成 3. 将生成的 16 位密码填入 `SMTP_PASS` --- ## 2. 启动后端 ```bash cd backend # 首次运行:安装依赖(建议在虚拟环境中) pip install -r requirements.txt # 启动服务(默认端口 8000) uvicorn app.main:app --reload --port 8000 ``` 启动成功后会看到: ``` INFO: Uvicorn running on http://0.0.0.0:8000 INFO: Scheduler started ``` 数据库文件 `trending_monitor.db` 会自动创建。 --- ## 3. 启动前端 新开一个终端窗口: ```bash cd frontend # 首次运行:安装依赖 npm install # 启动开发服务器(默认端口 5173) npm run dev ``` 打开浏览器访问:**http://127.0.0.1:5173** --- ## 4. 功能验收 | 页面 | 验证项 | |------|--------| | 热点页 | 空列表正常显示,"触发监控"按钮可点击 | | 关键词页 | 添加 / 暂停 / 删除关键词 | | 设置页 | 保存邮箱配置,发送测试邮件 | 添加关键词后,点击"触发监控"可立即测试(无需等待 30 分钟定时任务)。 --- ## 5. 功能开关说明 | 功能 | 依赖配置 | 未配置时的行为 | |------|---------|--------------| | AI 内容分析 | `OPENROUTER_API_KEY` | 监控任务报错,内容不会被分析 | | 邮件通知 | `SMTP_*` + 设置页开启 | 发送静默失败,不影响其他功能 | | Twitter 数据源 | `TWITTER_API_KEY` | 当前已停用,不参与采集 | | Web Push | `VAPID_*` | 禁用,不影响邮件和应用内通知 | | Hacker News | 无需配置 | 始终可用 | | Bing 新闻 | 无需配置 | 始终可用(注意频率限制) | --- ## 6. 常见问题 **后端启动报 `ModuleNotFoundError`** → 确认已激活虚拟环境,或重新执行 `pip install -r requirements.txt` **前端访问报 `502 Bad Gateway` / API 请求失败** → 确认后端已在 8000 端口运行 **测试邮件发送失败** → 检查 `SMTP_PASS` 是否为应用专用密码(非 Gmail 登录密码);确认 Gmail 已开启两步验证 **`OPENROUTER_API_KEY` 未填时触发监控** → 后端日志会显示 API 错误,热点列表保持空,属于正常降级行为 **Bing 新闻抓不到内容** → 先确认关键词本身有相关新闻;如果页面结构变动,日志里会看到 Bing 解析错误,后端会返回空列表 # 展示初步完成效果 <!-- 这是一张图片,ocr 内容为:AI热点监控 热点 关键词 设置 热点动态 立即采集 全部来源 9小时前 9小时前 HACKERNEWS HACKERNEWS ZCODE与GLM-5.2引发新一轮AI编码工具关注 从零构建并可生长分裂的合成细胞 研究人员首次实现由头设计的细胞能够生长和分裂,这是合成生物 围绕GLM-5.2的编程工具链ZCODE获得高度讨论,反映出开发者 对新一代代码生成,推理辅助和AI开发环境的持续关注. 学的重要里程碑,可能重塑生物工程,药物研发与人工生命研究. BIOTECH SYNTHETIC BIOLOGY DEVELOPER TOOLS 100 AL CODING 94 LLM RESEARCH 9小时前 9小时前 HACKERNEWS HACKERNEWS 开源自组装机器人吸尘器OOMWOO走红 FFMPEG9.1新AAC编码器发布 可自行组装的开源机器人吸尘器OOMWOO 受到关注,体现消费级机 FFMPEG 9.1的新AAC编码器成为音视频技术热点,显示开源多媒 体基础设施在压缩效率,音质和工具链升级上的持续进展. 器人,DIY 硬件和开源家庭自动化的结合趋势. DIY ROBOTICS OPEN SOURCE HARDWARE AUDIOPEN SOURCE FFMPEG 92 89 HACKERNEWS 9小时前 HACKERNEWS 9小时前 ANDROID恶意软件事件引发供应链与平台安全担忧 CLOUDFLARE 推出 X402 MONETIZATION GATEWAY 一则关于ANDROID恶意软件的热门讨论推动了对移动平台安全,应 CLOUDFLARE的MONETIZATION GATEWAY 支持对受保护资源直接收 用分发信任链以及大厂生态治理能力的重新审视. 费.展示了API计费,机器支付和WEB基础设施商业化的新方... CLOUDFLARE 87 CYBERSECURITYANDROID 88 API ECONOMY PAYMENTS MALWARE 9小时前 9小时前 HACKERNEWS HACKERNEWS GOOGLE开放零知识证明技术用于年龄验证隐私保护 图形程序员学习路径成为开发者热议话题 GOOGLE推动零知识证明在年龄验证场景中的应用,强调在合规与用 关于如何成为图形程序员的内容获得高关注,说明图形学,GPU编 程,渲染管线与游戏/可视化基础能力仍是技术社区重点方向. 户隐私之间寻找更优平衡,推动隐私计算落地. PRIVACY KNOWLEDGE PROOF GPU GRAPHICS PROGRAMMING SECURITY 85 83 RENDERING -->  <!-- 这是一张图片,ocr 内容为:AI热点监控 关键词 设置 热点 关键词管理 添加关键词 输入关键词,如:CLAUDE AI,大模型,GPT-5 BING NEWS HACKER NEWS 添加 ANTHROPIC 7月1日 监控中 BING HACKERNEWS -->  <!-- 这是一张图片,ocr 内容为:AI热点监控 设置 热点 关键词 设置 通知设置 启用邮件通知 每日热点摘要(每天9:00) 保存设置 通知测试 发送测试邮件 发送测试 验证邮件配置是否正常 触发每日摘要 立即发送 立即生成并发送今日热点摘要 -->  # 前端美化 从这里开始我换了模型 用 codex gpt5.4 写的,因为 claude 太贵了 Ai 设计前端千篇一律,使用前端美化技能,并人工指定UI风格,让界面更新颖 + 前端美化技能UI UX pro max + 人工提示词,指定风格 + Aceternity UI 组件库,做酷炫效果, 因为大模型训练时,看到大量 自然背景,圆角卡片,通用图标,所以形成了一种默认审美,要消除核心思路是约束 1. 指定色彩方案 2. 指定 UI 库 3. 注入情感和场景,告诉 AI 产品调性,如科技感,极客风 4. 使用前端美化技能:让AI 参考专业的 UI/UX 设计规范 写给 AI 的提示词 ```plain 目前的界面风格过于死板(米白配色+传统布局),请在保证功能易用的前提下,帮我优化前端页面。 你需要利用前端美化技能(ui ux pro max)进行设计开发,并且必须采用 Aceternity UI 组件库(通过 Context7 插件来获取最新的用法),来增强网站的科技感,但注意不要过于花里胡哨,影响了页面的正常加载或使用 我自己是一位 AI 编程程序员,最求简介高效,直观酷炫,充满科技感的页面,我急切地想要发现热点,想要第一时间给大家分享有价值的内容,你需要感受我的情绪,让前端页面体现出来 ``` 如果ai卡住了,报错了,可能是重构的代码量较多,可能会出现网络中断的情况,如果一直中断,最好换个模型,或者让 ai 拆分一下任务再继续执行 <!-- 这是一张图片,ocr 内容为:FILES CHANGED, 1557 INSERTIONS(+), DELETIONS(-) 640 +), 前端已经重做成更偏[实时信号台]的方向了,不再是米白传统后台.基于CONTEXT7 查到的官方信息,ACETERNITYUI 当前核心是 REACT+TAILWIND 体系,所以我没有 硬把这个 VUE项目改栈,而是按它官方的 SPOTLIGHT,BACKGROUND BEAMS,BENTO GRID,HOVERBORDER这些模式,在VUE里做了等价组件,保留科技感和动效语言, 同时不牺牲加载和维护成本.核心入口在FRONTEND/SRC/APP.VUE:1,全局视觉系统在 新增的 ACETERNITY 风格组件在FRONTEND/SRC/ FRONTEND/SRC/STYLES/THEME.CSS:1, COMPONENTS/ACETERNITYSPOTLIGHT.VUE:1. FRONTEND/SRC/COMPONENTS/ ACETERNITYBEAMS.VUE:1. FRONTEND/SRC/COMPONENTS/ACETERNITYBENTOCARD.VUE:1. FRONTEND/SRC/COMPONENTS/ACETERNITYGLOWBUTTON.VUE:1. 页面层面我重点改了三块:FRONTEND/SRC/VIEWS/DASHBOARD.YUE:L现在有更强的首屏 情绪,实时指标,精选热点和更利落的信号卡片;FRONTEND/SRC/VIEWS/ KEYWORDS.VUE:1 变成更像"监控规则面板",信息密度更高;FRONTEND/SRC/VIEWS/ :1则统一成同一套玻璃面板和操作节奏.INDEX.HTML也顺手改了站点 SETTINGS.VUE:1 则 标题和主题色:FRONTEND/INDEX.HTML:1. 校验方面,我用@VUE/COMPILER-SFC做了内存级SFC编译检查,8个 文件都 VUE 通过了.VITEBUILD没法在当前沙箱里完整跑完,不是代码报错,而是环境禁止创建 临时/输出目录;源码转换阶段已经开始执行,阻塞点是文件写入权限. WORKED FOR 16M 43S -->  以下是优化后的效果 <!-- 这是一张图片,ocr 内容为:采集节奏 TREND RADAR AI 热点追踪 关键词 系统设置 EVERY 30 MIN AI热点雷达 LIVE SIGNAL BOARD 当前信号 覆盖来源 先看到趋势,再决 2 12 定要不要追. 已加载热点条目 实时活跃数据源 为高频分享者设计的AL热点监控台.把HACKERNEWS,GITHUB和新闻流压缩成高密度信 最新捕获 高分内容 号,帮你更快判断什么值得立刻阅读,整理,转发和输出. 11 14H AGO 来源筛选 最新一条入库时间 全部来源 评分80+的热点 立即采集 刷新列表 FILTER FEATURED HACKER NEWS SCORE 100 当前最值得打开的内容 当前筛选 从零构建并可生长分裂的合成细胞 未限制来源,保持全局扫描视角. 研究人员首次实现由头设计的细胞能够生长和分裂,这是合成生物学的重要里程碑,可能重望生物工 程,药物研发与人工生命研究. 原文缺失 ALL SOURCES MOMENTUM 标签热度 最近内容里最频繁出现的标签. LLM DEVELOPER TOOLS AL CODING OPEN SOURCE --> 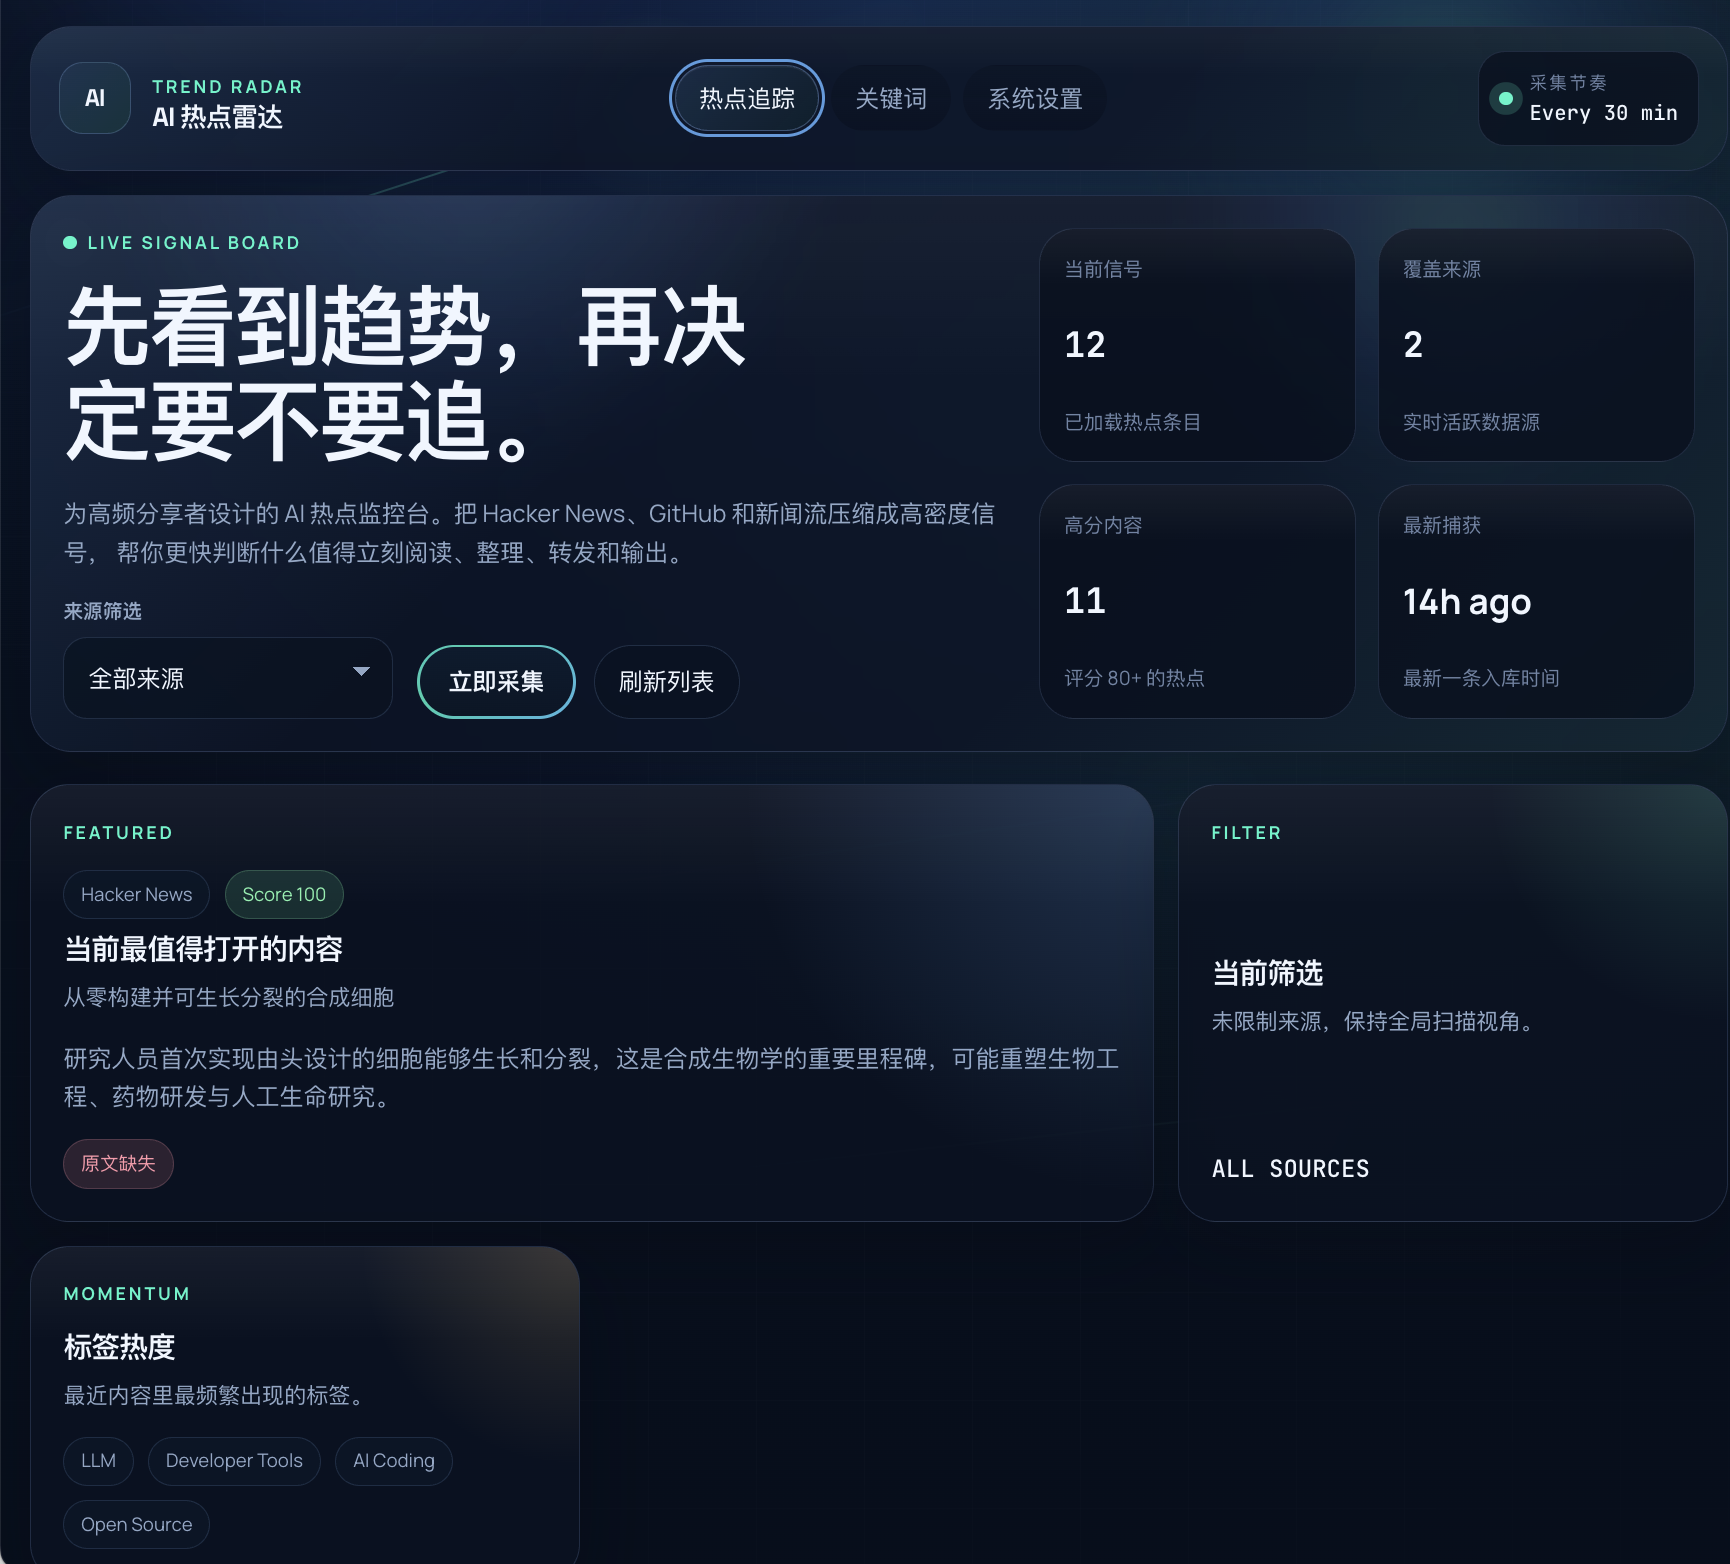<!-- 这是一张图片,ocr 内容为:HOT LIST 值得立刻读的热点 保留足够强的信息层级,但不把你拖进复杂操作里.内容优先,动作第二,装饰最后. 14H AGO 14H AGO 14H AGO SCORE 100 SCORE 92 SCORE 94 HACKER NEWS HACKER NEWS HACKER NEWS 从零构建并可生长分裂的合成细胞 ZCODE与GLM-5.2引发新一轮AI编码工具 FFMPEG9.1新AAC编码器发布 关注 研究人员首次实现由头设计的细胞能够生长和分 FFMPEG9.1的新AAC编码器成为音视频技术热 裂,这是合成生物学的重要里程碑,可能重塑生物 点,显示开源多媒体基础设施在压缩效率,音质和 围绕GLM-5.2的编程工具链ZCODE 获得高度讨 工程,药物研发与人工生命研究. 工具链升级上的持续进展. 论,反映出开发者对新一代代码生成,推理辅助和 AI开发环境的持续关注. 原文缺失 原文缺失 原文缺失 FFMPEG AL CODING DEVELOPER TOOLS OPEN SOURCE BIOTECH SYNTHETIC BIOLOGY LLM AUDIO MEDIA TECH GLM ARTIFICIAL LIFE RESEARCH 14H AGO 14H AGO 14H AGO HACKER NEWS SCORE 88 SCORE 89 HACKER NEWS SCORE 87 HACKER NEWS 开源自组装机器人吸尘器0OMWOO走红 ANDROID恶意软件事件引发供应链与平台安 CLOUDFLARE 推出 X402 MONETIZATION 全担忧 GATEWAY 可自行组装的开源机器人吸尘器OOMWOO受到关 注,体现消费级机器人,DIY硬件和开源家庭自动 CLOUDFLARE 的 MONETIZATION GATEWAY 支持对受保 一则关于ANDROID恶意软件的热门讨论推动了对移 化的结合趋势. 护资源直接收费,展示了API计费,机器支付和 动平台安全,应用分发信任链以及大厂生态治理能 力的重新审视. WEB 基础设施商业化的新方向. 原文缺失 原文缺失 原文缺失 OPEN SOURCE HARDWARE ROBOTICS PAYMENTS CLOUDFLARE CYBERSECURITY ANDROID DIY MALWARE API ECONOMY MOBILE SECURITY SMART HOME INFRASTRUCTURE 14H AGO 14H AGO 14H AGO HACKER NEWS SCORE 82 HACKER NEWS HACKER NEWS SCORE 85 SCORE 83 KIMI K2.7 CODE 正式进入 GITHUB COPILOT 图形程序员学习路径成为开发者热议话题 GOOGLE 开放零知识证明技术用于年龄验证隐 私保护 KIMI K2.7 CODE 接入GITHUB COPILOT,反映 AI编程 关于如何成为图形程序员的内容获得高关注,说明 助手平台竞争升级,多模型并存正成为开发工具的 图形学,GPU编程,渲染管线与游戏/可视化基础 GOOGLE推动零知识证明在年龄验证场景中的应 新常态. 能力仍是技术社区重点方向. 用,强调在合规与用户隐私之间寻找更优平衡,推 动隐私计算落地. 原文缺失 原文缺失 原文缺失 AL CODING GITHUB COPILOT LLM PRIVACY GRAPHICS PROGRAMMING GPU ZERO-KNOWLEDGE PROOF DEVELOPER TOOLS DEVELOPER EDUCATION LDENTITY SECURITY RENDERING --> 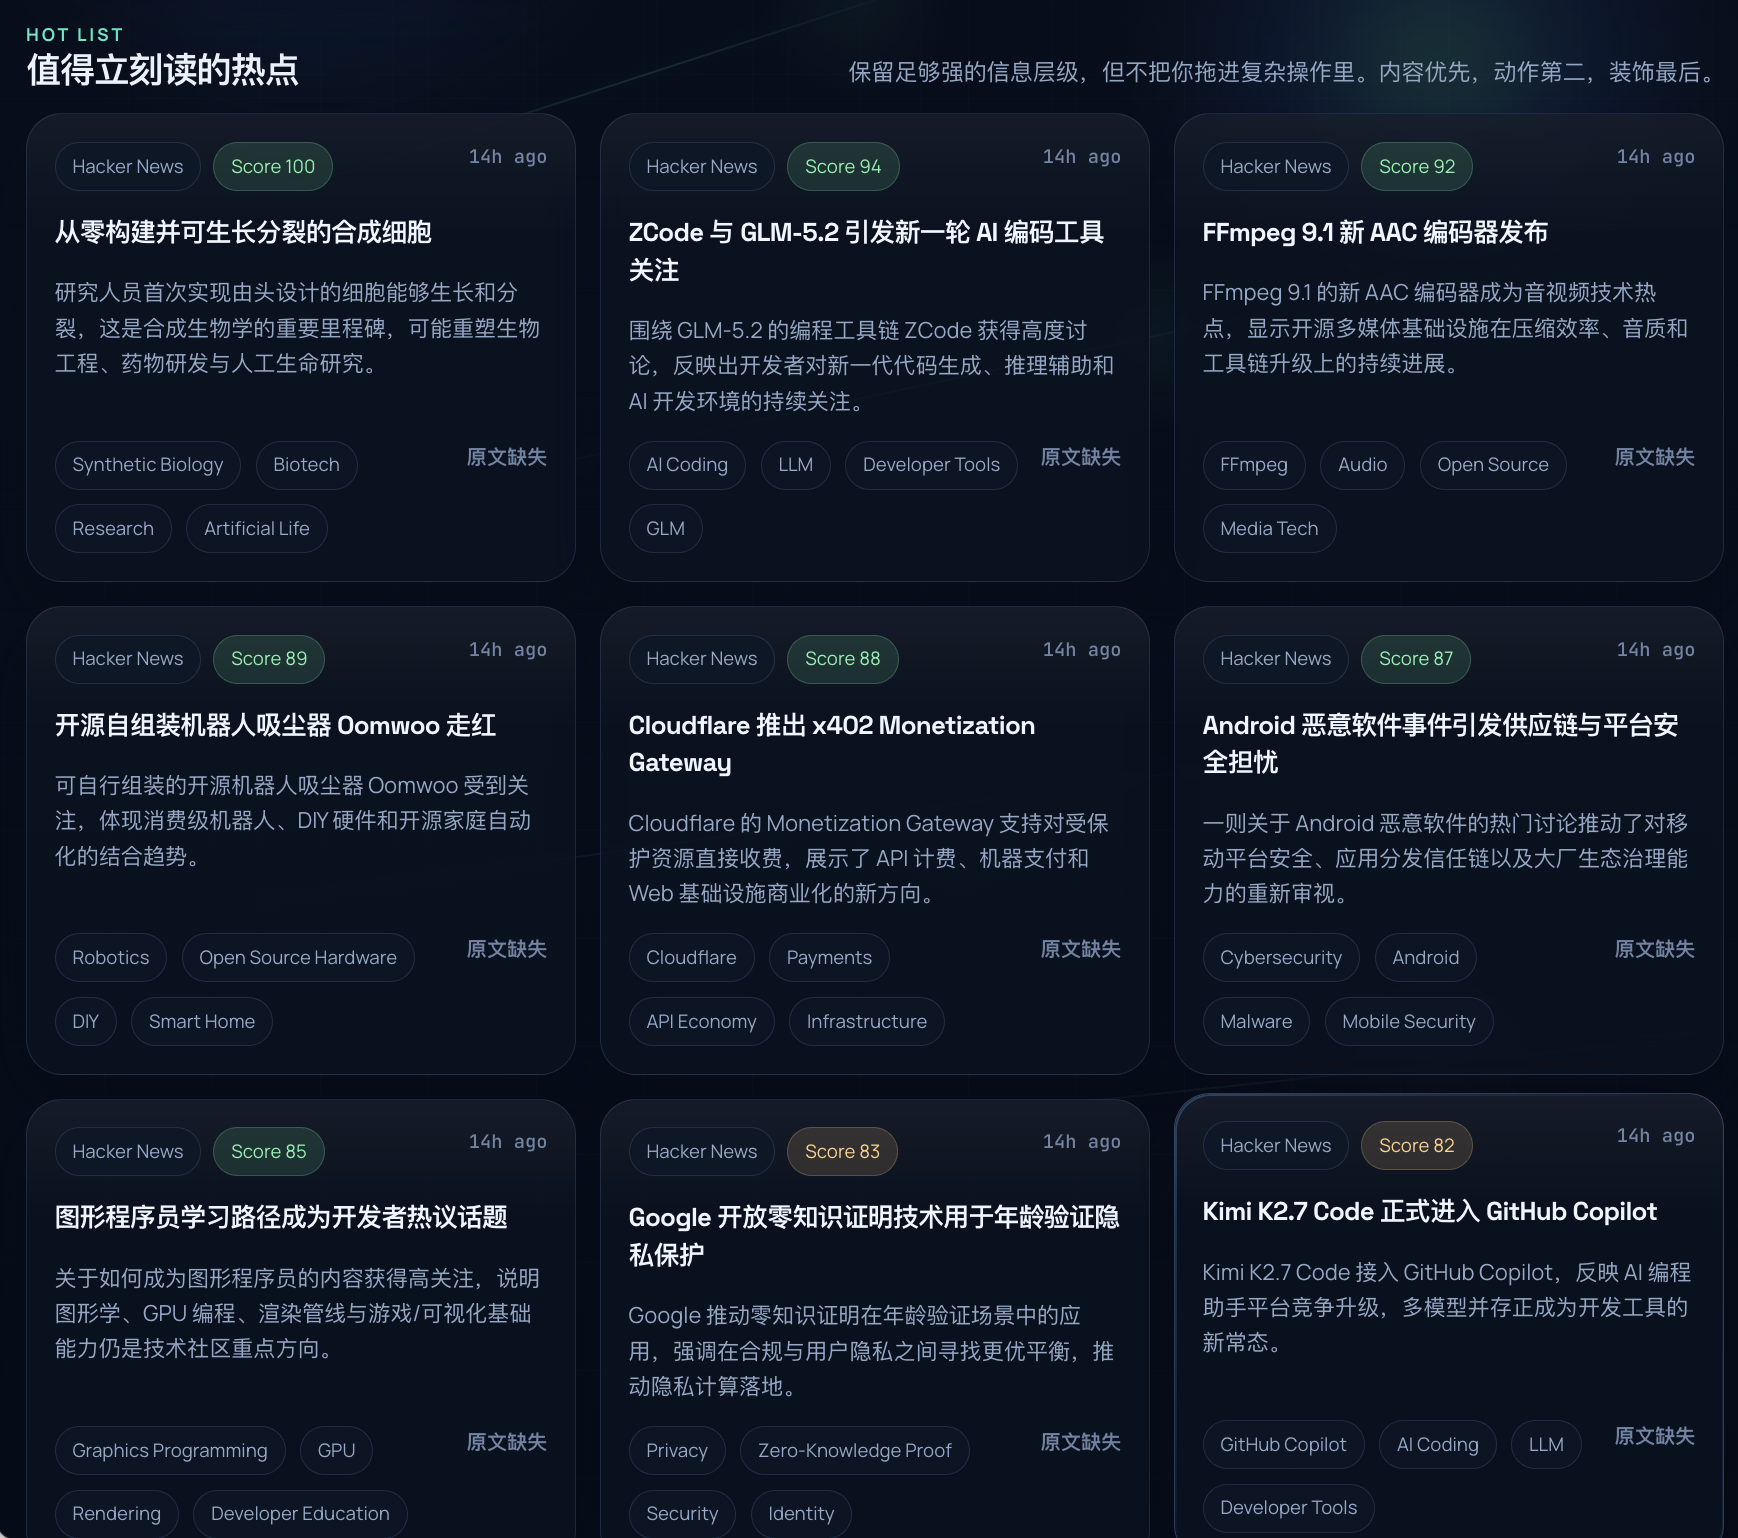<!-- 这是一张图片,ocr 内容为:采集节奏 TREND RADAR 热点追踪 系统设置 关键词 AI AI热点雷达 EVERY 30 MIN KEYWORD WATCHLIST 把你的注意力,绑定 到会爆发的话题上. 关键词不是"存挡,而是你的长期雷达.把你最想抢先输出的概念放进去,系统会稳定追踪并在热点发生时给 你信号. 覆盖来源 活跃规则 关键词总数 CREATERULE 1ACTIVE 添加监控关键词 2 1 关键词 当前关键词涉及 正在持续推送热 当前WATCHLIST 例如:CLAUDECODE,MCP,AGENTS,GPT-5 的数据源数量 中的关键词条目 点的监控规则 追踪来源 OPERATOR NOTES 更有效的关键词策略 HACKER NEWS BING NEWS 优先填"会引发讨论"的概念,而不是泛泛的行业词. 加入监控队列 新模型,新工具,新协议,用英文名和缩写一起监控. 默认每30分钟自动扫描一次. 保持数量克制,关键词过多会稀释真正值得看的信号. WATCHLIST 已建立的热点雷达 启用状态,来源覆盖和创建时间保持在同一层视线里,不需要点进去才知道规则是否正常工作. 监控中 ANTHROPIC 暂停 7月1日 删除 HACKER NEWS BING NEWS --> 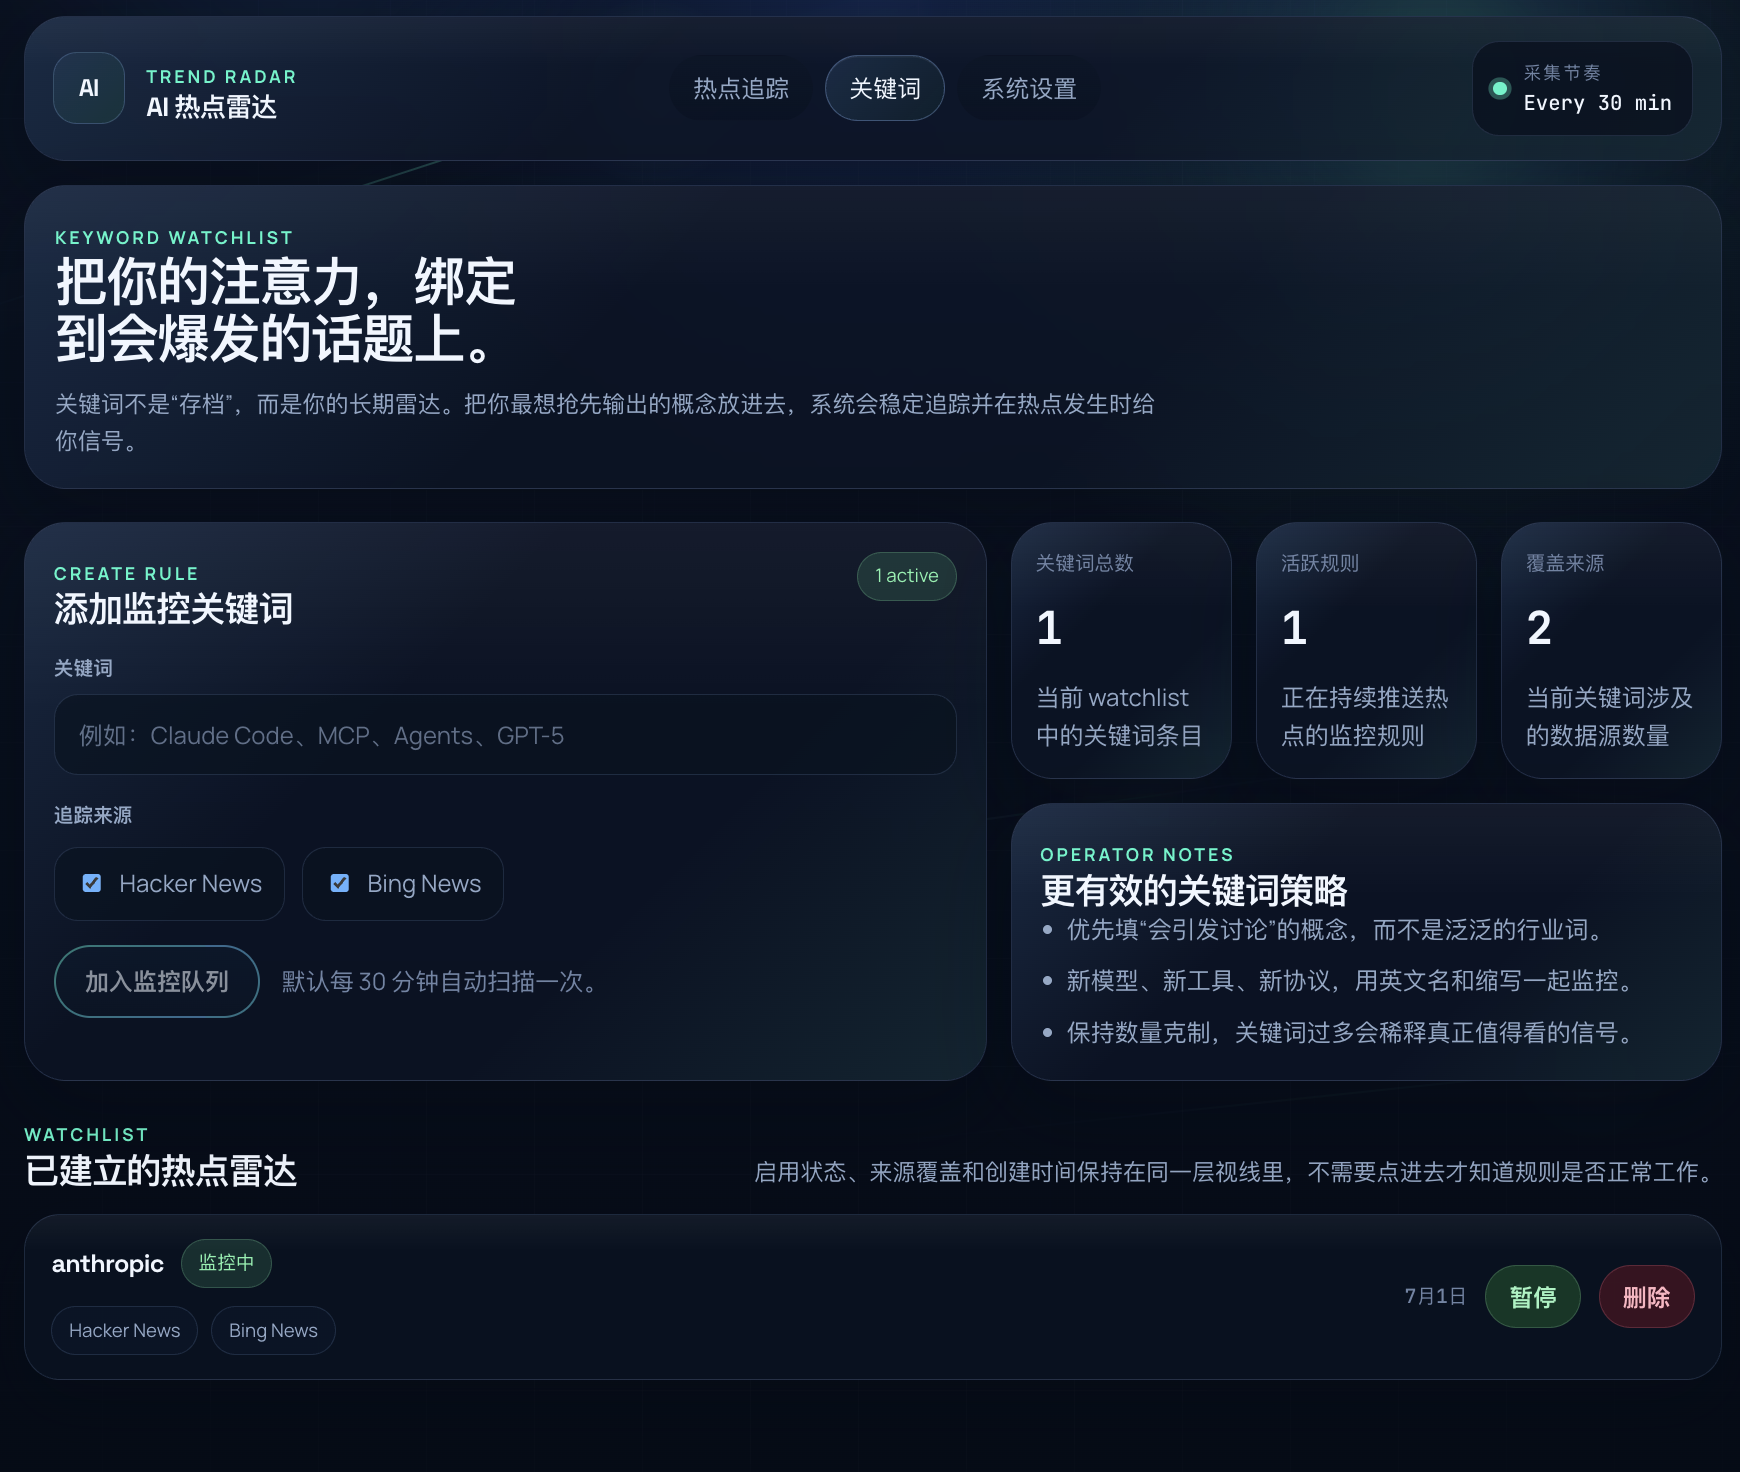<!-- 这是一张图片,ocr 内容为:采集节奏 TREND RADAR 系统设置 关键词 热点追踪 AI EVERY 30 MIN AI热点雷达 DELIVERY CONTROLS 让重要热点更快到你 面前,也更稳地发出 去. 邮件通知未开启 每日摘要已关闭 OPERATIONS NOTIFY NO INBOX YET 通知测试 通知设置 发送测试邮件 启用邮件通知 发送测试 当监控到热点时,通过邮件把信号推到你的收件箱. 验证SMTP配置,收件箱和模板是否正常. 触发每日摘要 每日热点摘要 立即发 立即发送一封模拟当日摘要,检查最终交付体 每天09:00自动发送当日精选热点,适合回顾和二次整理. 送 验. 保存设置 SYSTEM NOTE 这套通知流的目标 平时用关键词和热点流筛掉噪声,真正有价值的内容再用邮件和摘要 送出来.即时性和可回顾性都要有,但谁也不能压过主界面的判断效 率. -->  # 优化信息获取来源 ## 现在的问题 1. 包含了很多不知名的 weibo 回复信息,比如有些帖子的回复寥寥无几,可能是随便发一个,就被抓进来 2. 信息来源比较单一,几乎全是 twitter,需要扩展一下信息来源,从多个搜索引擎来获取 所以总结下来 一个是质量不好,一个是广度度不够,说一拓宽信息源,再通过规律规则控制质量,像一个漏斗,开口要大,出口要精 ## 解决方案 我们应该让 AI 关注一些官方和大博主,比如你想知道 claude 有没有更新,应该优先去关注官方的人,或者官方文档 这些要关注的人/账号/官方应该是动态的,比如你的关键词填写的是“科技”,那么输入完关键词,就应该自动关注科技领域的大 V; 如果你输入的是“艺术运动” 那么应该自动关注“艺术运动”相关的大 V。**先不要局限于自己的思路,说不定 AI 有更好的方法,所以输入提示词** ```markdown 现在的后端问题是 1. 包含了很多不知名的 weibo 回复信息,比如有些帖子的回复量寥寥无几,可能是随便发了一个,就被抓了进来 2. 信息源比较单一,基本都是 hackernews 需要扩展一下信息来源,从多个搜索引擎来获取 请你合理的实现方案,让我的信息源更可靠,注意,必须等我人工确认方案后,你才能开始执行,如果你有任何不确定的内容,必须通过提问我人工确认 ``` AI 编程中 “先问 AI”策略,很多时候我们有自己的想法,但未必是最优解,可以先问问 AI,这是好的 AI 编程习惯 1. AI 可能有更好的方案,他见过更多实现方式 2. 避免思维局限 3. 节省沟通成本,让 AI 出方案,再在这个基础上改 最后决定权在人手在,AI 给方案后 还是需要人工确认和调整的 ## 在和 ai 长时间对话上下文太满,解决方案 上下文太满了,消耗太多 token,省钱,提升效果,开个新的窗口 写入以下提示词 ### 方案一 直接 /compact 然后继续发送当前需求,如果用的 AI 工具有这个功能 ### 方案二 开个新的窗口,然后发送以下提示词 ```markdown 你是一位专业程序员,现在请你根据我的需求和方案,以及已经开发完成的前端和后端项目,在此基础上进行优化和功能扩展 ## 提供给你的资料 @需求文档 AGENTS.md @项目交互文档 STARTUP.md 必须 完整分析前端和后端已有代码 ## 本次需求 @当前需求 ``` 我选择方案一 因为工具有这个功能,省力,压缩后,窗口大小只占用了百分之一、 压缩完后我把提示词发给 ai ,ai 给出了如下方案 <!-- 这是一张图片,ocr 内容为:我先不执行,只给方案.当前问题我已经定位到两处: 1,微博低质量内容会进库 原因在 BACKEND/APP/SERVICES/SCRAPERS/WEIBO.PY:1 里,SEARCH.WEIBOO 现在只要 搜到帖子就返回,基本没有"质量筛选". 在 BACKEND/APP/JOBS/MONITOR.PY:121 里,后续 AI 只判断"和关键词相关不相关不相关", 不判断"值不值得收". 2多源聚合还不够强 关键词监控现在实际只接了 HACKERNEWS+BING+WEIBO,见BACKEND/APP/IOBS/ MONITOR.PY:126. 其中 BING是一个搜索入口,但还没有形成"多搜索引擎交又验证"的机制;趋势采集也 HACKER NEWS + GITHUB, 见 BACKEND/APP/JOBS/MONITOR.PY:170. 只有 我建议这样做,分两层改: 方案A:先把微博质量门槛补上 -给微博结果增加 QUALITY_SCORE,综合看: REPOSTS_COUNT + COMMENTS_COUNT + ATTITUDES_COUNT 是否是转发/回复型噪音内容 -文本长度是否过短 是否包含明显无信息量模板文案 -设一个预过滤门槛,低于门槛的微博在进入AI前就丢掉. -加一个"每个关键词最多保留前N条微博"的限流,避免微博把结果池淹没. -AI过滤从"只看相关性"改成"相关性+信息价值",比如要求: RELEVANT - TRUE CONFIDENCE >: 0.6 QUALITY_SCORE >; THRESHOLD 我建议默认规则偏保守,优先提高准确率,不追求把所有提到关键词的微博都抓进来. -->  <!-- 这是一张图片,ocr 内容为:方案B:把关键词监控扩成真正的多源搜索 我建议第一阶段先接这4个源: WEIBO BING_NEWS GOOGLE_NEWS HACKERNEWS 原因: GOOGLE NEWS RSS和 BING NEWS 实现成本低,稳定性通常比直接爬音通搜索页更高 NEWS适合技术圈早期信号 HACKER WEIBO适合中文社区热度 实现方式: 新增 GOOGLE_NEWS.PY,走 RSS 检索 保留现有BING.PY,但把它明确定位成 BING_NEWS 在 BACKEND/APP/JOBS/MONITOR.PY:121 增加统一聚合层: 每个源单独抓取 统一标准化字段 URL/标题去重 按源分配配额,避免单一来源霸榜 如果同一主题被多个源同时命中,给它加权 聚合策略 同主题被多个源命中时,提高可信度 单源孤立命中但质量很低时,不入库 通知时优先发"多源同时提到"的条目 趋势榜和关键词命中分开处理: 关键词命中:允许单条高质量内容入库 趋势榜:尽量要求多源支撑 我准备改动的文件范围 BACKEND/APP/SERVICES/SCRAPERS/WEIBO.PY:1 新增BACKEND/APP/SERVICES/SCRAPERS/GOOGLE_NEWS.PY BACKEND/APP/SERVICES/SCRAPERS/BING.PY:1 BACKEND/APP/JOBS/MONITOR.PY:1 可能少量更新: -->  <!-- 这是一张图片,ocr 内容为:在你确认前,我不会动代码. 但这里有3个需要你拍板的点,我不想替你擅自决定: 1.微博筛选策略你要偏"准"还是偏"全"? 我推荐偏"准",宁可漏掉一些低热度帖子,也不要把杂音收进来. 2.多搜索源第一阶段是否按我推荐的 GOOGLE NEWS+BING NEWS+HACKER NEWS+WEIBO 来做? 我不建议第一版就上百度/搜狗,抓取更脆,更容易变. 3,低质量微博的处理方式你要哪种? 我推荐"直接不入库",而不是"入库但前端隐藏". 者把这3点改掉,我再开始实现. 你回复我一句"按这个方案执行"或者把这3 WORKED FOR 1M 25S WEIBO的策略偏准所以允许"方案 A"落地 1.我希望 2.可以按照你的"方案B"来做,但是对于方案B我觉得只加入GOOGLENEWS和BING NEWS就可以并不需要你去对关键词加权,和分配优先级, 3.是的"直接不入库",你把方案修改好,再给我确认一下 -->  <!-- 这是一张图片,ocr 内容为:我把方案收敛成下面这版,先不执行. 修订后的方案 A.WEIBO 质量过滤,直接在入库前拦掉 在 BACKEND/APP/SERVICES/SCRAPERS/WEIBO.PY:1 增加微博结果质量判定. 过滤规则偏"准": 互动量过低的帖子丢弃 文本过短,明显口水化/无信息量内容丢弃 转发痕迹重,像随手回复/闲聊的内容丢弃 输出时给每条微博带一个内部QUALITY-SCORE 在 BACKEND/APP/JOBS/MONITOR.PY:1里先做微博质量过滤,再做 AI 相关性判断 低质量微博直接不入库 和BING NEWS B,关键词来源扩展,只加 GOOGLE NEWS 保留现有WEIBO 新增 GOOGLE NEWS 抓取器,优先走 RSS 现有 BING.PY 明确作为 BING NEWS 使用 关键词监控改成支持这些来源的并行抓取,统一字段,基础去重 不做关键词加权 不做来源优先级分配 不做多源命中加权 C.我会保留的最小聚合能力 URL去重 标题近似去重 统一字段结构,保证后续AI和入库逻辑一致 预计改动范围 BACKEND/APP/SERVICES/SCRAPERS/WEIBO.PY:1 新增 BACKEND/APP/SERVICES/SCRAPERS/GOOGLE_NEWS.PY BACKEND/APP/SERVICES/SCRAPERS/BING.PY:1 BACKEND/APP/JOBS/MONITOR.PY:1 可能少量更新: BACKEND/APP/API/SCHEMAS.PY:1 前端来源选项文案 现在只剩1个我必须向你确认的点: 你要不要保留HACKERNEWS在"关键词监控"里继续作为可选来源? 如果保留,在你要求"不做优先级分配"的前提下,它仍然可能继续占一部分结果. 你回复我以下其一即可: -->  这里我选了保留 hackernews <!-- 这是一张图片,ocr 内容为:已经按你确认的方案落地了,没有加你不想要的"来源加权/优先级分配". 微博这边现在先做质量过滤,再进入AT相关性判断.低互动,短文本,口水化,明显转发型内容 会直接被拦掉,不入库.核心逻辑在 BACKEND/APP/SERVICES/SCRAPERS/WEIBO.PY:140和 BACKEND/APP/SERVICES/SCRAPERS/WEIBO.PY:169. 多源这边新增了 GOOGLE NEWS RSS RSS 抓取器 BACKEND/APP/SERVICES/SCRAPERS/GOOGLE_NEWS.PY:1. LE_NEWS+WEIBO,同时只做基础去重, 并把关键词监控默认来源扩成HACKERNEWS BING + GOOGLE_NE 不做权重分配.见 BACKEND/APP/JOBS/MONITOR.PY:16,BACKEND/APP/JOBS/MONITOR.PY:97. BACKEND/OPP/JOBS/MONITOR.PY:154.趋势采集也补进了 BING NEWS +GOOGLE NEWS, 不再基本只 BACKEND/APP/JOBS/MONITOR.PY:209. 靠HN,见 前端来源选项也同步了,关键词页和仪表盘都能直接选 GOOGLE NEWS,见 FRONTEND/SRC/VIEWS/ KEYWORDS.VUE:154 和 FRONTEND/SRC/VIEWS/DASHBOARD.VUE:21. 我做了这些本地校验: 后端 APP 通过 PYTHON -M COMPILEALL 前端 NPM RUN BUILD 通过 -用本地构造样例验证了微博质量过滤和去重逻辑 这轮我没有做真实外网抓取验证,因为当前会话环境网络受限.如果你要,我下一步可以直接帮 你: 1.用你的本地环境把前后端跑起来 2.手动触发一次MONITOR 的实际入库结果 3.检查数据库里WEIBO/BING/GOOGLE_NEWS HACKERNEWS -->  ## 增加国内源 ```markdown 帮我增加国内可用的搜索源,注意,不需要让我填写 API Key, 并且如果搜索的关键词本身是一个博主/官方/账号的话, 应该直接获取这个账号的信息 ``` <!-- 这是一张图片,ocr 内容为:帮我增加国内可用的搜索源,注意,不需要让我填写APTKEY,并且如果搜索的关键词本身是一 个博主/官方/账号的话,应该直接获取这个账号的信息 我先看现有抓取链路和关键词处理逻辑,整理一版可落地方案给你确认;这次我先不改代码,等你 人工确认后再执行. EXPLORED LIST T SCRAPERS SEARCH WEIBOLBINGLGOOGLE-NEWS HACKERNEWSLGITHUBLKEYWORDLMONITORISCRAPERISOURCE IN APP :我已经确认当前链路是WEIBO+BING+GOOGLE_NEWS+HACKERNEWS+GITHUB.下一步我读 MONITOR和WEIBO实现,给你一版"只提方案,不动代码"的改造设计. EXPLORED ID MONITOR.PY, SCHEMAS.PY,MODELS.PY,WEIBO.PY READ 现在可以给你方案了,不过我还想补一眼前端关键词源选项和现有搜索源实现,避免给你一个落不 到UI的方案.之后我会只给确认清单,不直接改. EXPLORED BING.PY READ DASHBOARD.VUE,KEYWORDS.VUE,GOOGLE_NEWS.PY, 先不给你动代码,我把可执行方案收敛成这一版,等你确认后我再开始改. 方案 新增BAIDU_NEWS:抓 :抓百度新闻搜索结果,适合中文媒体,快讯,公告类内容. 新增 SOGOULWEIXIN:抓搜狗微信文章搜索结果,适合公众号,行业号内容. 保留现有 WEIBO/ HACKERNEWS/GITHUB/ BING/ GOOGLE_NEWS,这是"增加来源", 不是替 换. BAIDU_NEWS 进入"关键词监控+全局热点". SOGOULWEIXIN只进入"关键词监控",不进入"全局热点",因为它更像定向内容源,不适合做通. 用TRENDING. 账号关键词直达 -->  <!-- 这是一张图片,ocr 内容为:已经改好了,当前版本做了这几件事: 新增国内可用搜索源:BAIDU NEWS 和 SOG API KEY. 和SOGOUWEIXIN,都不需要 微博关键词改成"账号优先": 如果关键词更像账号名/官方号/博主名,会先搜微博账号;命中强匹配后,直接返回该账号卡片 和最近内容;否则回退到普通帖子搜索. 关键词默认来源扩成:HACKERNEWS +BING +GOOGLE_NEWS + - BAIDU_NEWS + SOGOU_WEIXIN + WEIBO 为了兼容你库里以前的默认关键词配置,后端会自动把旧默认来源升级到新组合,不需要你手工 逐条重配. 核心改动在这些文件: BACKEND/APP/JOBS/MONITOR.PY BACKEND/APP/SERVICES/SCRAPERS/WEIBO.PY BACKEND/APP/SERVICES/SCRAPERS/BAIDU_NEWS.PY BACKEND/APP/SERVICES/SCRAPERS/SOGOU_WEIXIN.PY FRONTEND/SRC/VIEWS/KEYWORDS.VUE FRONTEND/SRC/VIEWS/DASHBOARD.VUE 我已经做过本地检查: 后端 PYTHON -M COMPILEALL BACKEND/APP 通过 前端 NPM RUN BUILD 通过 还没做"真实外网抓取结果"的验证,因为这一步要依赖当前环境的真实出网和目标站点返回.如果 你要,我下一步可以直接帮你跑一轮采集,检查 BAIDULNEWS/SOGOULWEIXIN/WEIBO账号直达 实际抓到了什么. -->  <!-- 这是一张图片,ocr 内容为:账号关键词直达 我建议先做"微博账号直达"这一版,稳定性最高. ,逻辑是:当关键词像账号名/官方名/博主名时,先跑微博账号搜索,不先跑普通站子搜索. -如果命中高相似账号,就直接抓这个账号的资料卡片+最近若干条内容. 如果没命中,再回退到普通关键词搜索. 账号资料会作为普通结果入库,但在RAW_DATA里标记成 ENTITY_TYPE-ACCOUNT,这样前端后面 要单独展示也容易. 我会改的地方 后端新增两个 SCRAPER:BAIDU_NEWS.PY,SOGOU_WEIXIN.PY -扩展BACKEND/APP/JOBS/MONITOR.PY的SOURCE分发和账号识别分支 扩展 FRONTEND/SRC/VIEWS/KEYWORDS.VUE的来源选项 适当补去重和低质量过滤,避免公众号目录页,无效落地页,低信息量结果入库 需要你确认的点 做WEIBOACCOUNT,不先做"公众号账号页直达",因为公众号主页抓 我建议"账号直达"第一步只做 取稳定性明显更差.你是否同意? 如果同意,我就按这版开始执行. -->  <!-- 这是一张图片,ocr 内容为:已经改好了,当前版本做了这几件事: 新增国内可用搜索源:BAIDU NEWS 和 SOG API KEY. 和SOGOUWEIXIN,都不需要 微博关键词改成"账号优先": 如果关键词更像账号名/官方号/博主名,会先搜微博账号;命中强匹配后,直接返回该账号卡片 和最近内容;否则回退到普通帖子搜索. 关键词默认来源扩成:HACKERNEWS +BING +GOOGLE_NEWS + - BAIDU_NEWS + SOGOU_WEIXIN + WEIBO 为了兼容你库里以前的默认关键词配置,后端会自动把旧默认来源升级到新组合,不需要你手工 逐条重配. 核心改动在这些文件: BACKEND/APP/JOBS/MONITOR.PY BACKEND/APP/SERVICES/SCRAPERS/WEIBO.PY BACKEND/APP/SERVICES/SCRAPERS/BAIDU_NEWS.PY BACKEND/APP/SERVICES/SCRAPERS/SOGOU_WEIXIN.PY FRONTEND/SRC/VIEWS/KEYWORDS.VUE FRONTEND/SRC/VIEWS/DASHBOARD.VUE 我已经做过本地检查: 后端 PYTHON -M COMPILEALL BACKEND/APP 通过 前端 NPM RUN BUILD 通过 还没做"真实外网抓取结果"的验证,因为这一步要依赖当前环境的真实出网和目标站点返回.如果 你要,我下一步可以直接帮你跑一轮采集,检查 BAIDULNEWS/SOGOULWEIXIN/WEIBO账号直达 实际抓到了什么. -->  这里 我犯了个错误,同意了 改 weibo 那个,先搜索,关键词账号,如果搜到了,就不搜鱼关键词有关的帖子了。所以我又让 ai 改回去了,但忘记截图了。 ### 新鲜度过滤 新鲜度过滤是了点监控的一个关键策略,本项目设置了7 天的时间窗口,超过 7 天内容会自动丢弃,原因是 + 热点有强烈的时效性,超过 7 天不再是热点 + 搜索引擎可能包含很多旧的文章 + 过滤旧的内容可以减少 ai 负担,减少 api 调用成本 这边我没写提示词,直接问 AI 当前项目有没有做 7 天过滤 <!-- 这是一张图片,ocr 内容为:>目前项目,筛选有没有对文章发布时间,有要求 我先确认一下后端有没有"按文章发布时间过滤"的硬规则,重点看抓取器,监控任务和查询接口. 目前没有"统一的文章发布时间硬过滤". 现在的实际情况是: 后端入库前,没有写"只保留最近24小时/7天"的规则. 关键代码在 BACKEND/APP/IOBS/MONITOR.PY:183.这里只做相关性,质量,去重,不看发布时 间. 列表接口也不是按"文章发布时间"排,而是按"入库时间 CREATED_AT"倒序排. 在 BACKEND/APP/API/TRENDING.PY:31. 部分抓取源会带发布时间字段,但现在只是拿到了,没拿来做过滤: GOOGLE-NEWS 有 PUBLISHEDLAT, 见 BACKEND/APP/SERVICES/SCRAPERS/GOOGLE_NEWS.PY:58 BING 有 PUBLISHED_AT, 见 BACKEND/APP/SERVICES/SCRAPERS/BING.PY:199 有 WEIBO CREATED_AT 原始字段,见 BACKEND/APP/SERVICES/SCRAPERS/WEIBO.PY:210 S 有 TIME,见 BACKEND/APP/SERVICES/SCRAPERS/HACKERNEWS.PY:29 HACKERNEWS 所以结论是: 有"源站天然偏新"的倾向 例如 GITHUB TRENDING DAILY,GOOGLE NEWS / BING/百度新闻搜索结果本身通常偏近期 但系统自己没有额外加一道"发布时间必须足够新"的门槛 如果你要,我可以下一步给你设计一版"按来源分别做发布时间过滤"的方案,先给你确认,再改. -->  <!-- 这是一张图片,ocr 内容为:我的意思是,对所以获取的信息,有没有去查验信息是否是最近的,没有过时 没有. 目前项目对"信息是不是最近的,有没有过时"并没有做统一查验,只有这几层比较弱的间接约束; 某些源天然偏新. 比如 GITHUB TRENDING DAILY 在 BACKEND/APP/SERVICES/SCRAPERS/GITHUB.PY:/7 本身就是日 榜;GOOGLE NEWS,BING,百度新闻 的搜索结果通常也偏近期. 系统会读取部分来源自带的时间字段,但没有拿它们做"过时淘汰". 例如: BACKEND/APP/SERVICES/SCRAPERS/GOOGLE_NEWS.PY:58 BACKEND/APP/SERVICES/SCRAPERS/BING.PY:199 BACKEND/APP/SERVICES/SCRAPERS/WEIBO.PY:210 BACKEND/APP/SERVICES/SCRAPERS/HACKERNEWS.PY:29 入库前没有做"发布时间窗口过滤". 在BACKEND/OPP/JOBS/MONITOR.PY:183这一段,主要做的是去重,相关性,质量,不是时效性, 验证. 展示排序也不是按原文发布时间,而是按数据库入库时间 CREATED_AT. 见 BACKEND/APP/API/TRENDING.PY:31 所以准确地说: 现在系统"倾向于抓到较新的内容" 但"不会主动验证这条内容是否已经过时" 这意味着确实可能出现: 老文章被搜索引擎重新召回 旧微博/旧讨论因为关键词匹配再次进入结果 入库时间很新,但原文发布时间并不新 如果你要,我下一步可以先给你一版"时效性过滤方案"让你确认,再开始改. -->  <!-- 这是一张图片,ocr 内容为:已经改了,现在项目会在入库前统一做"时效性过滤". 当前规则是: WEIBO:只保留最近72小时 IR NEWS / BING / GOOGLE NEWS / BAIDU NEWS / SOGOU WEIXIN: 7 天 HACKER NEV GITHUB TRENDING:保留豁免,因为它本身就是趋势榜单,不靠单条发布时间判断 实现位置在: BACKEND/APP/JOBS/MONITOR.PY BACKEND/APP/SERVICES/SCRAPERS/BAIDU_NEWS.PY BACKEND/APP/SERVICES/SCRAPERS/SOGOU_WEIXIN.PY BACKEND/APP/SERVICES/SCRAPERS/WEIBO.PY 这次改动还包括: RSS 统一解析多种时间格式:R 5S时间,UNIX时间,微博时间,中文相对时间如"2小时前/昨天 12:30" 对新闻/社媒源,如果拿不到可判断的发布时间,默认直接丢弃,不入库 日志里会打印 RECENCY STATS,你能看到每个源有多少条被判定为 STALE 或 UNL UNKNOWN_TIME 我已经做过本地验证: PYTHON -M COMPILEALL BACKEND/APP 通过 过滤函数的本地样例验证通过 如果你要,我下一步可以直接帮你触发一次真实采集,然后看看数据库里还剩哪些源的数据. WORKED FOR 2M 34S WEIBO也是7天时效性,然后GITHUB应该可以通过 的时间判断吧 RELEASE -->  <!-- 这是一张图片,ocr 内容为:已经改了,WEIBO现在也是7天时效离口,在 BACKEND/APP/JOBS/MONITOR.PY:25.后端编译检 查通过了. GITHUB 这件事要分开看: GITHUB 源不是 RELEASE 源,而是 是 BACKEND/APP/SERVICES/SCRAPERS/GITHUB.PY:7 抓的 现在的 GITHUB TRENDING DAILY 仓库榜. 这个页面给的是"最近趋势仓库",并不直接提供LATESTRELEASE时间. 所以当前代码里把 GITHUB作为"榜单型新鲜源"豁免处理,是合理的;它的新鲜度来自 SINCE-DAILY,不是来自每条 REPO的RELEASE 日期. 如果以后你真想按 RELEASE时间判断,得换一种抓法,例如: 先抓TRENDING REPO 的 再额外查每个 E/PUSHED_AT LATEST RELEASE REPO 再按时间过滤 但那已经不是"当前这条 GITHUB 源直接就能拿到"的信息了.现在这版先保持 DAILY TRENDING 逻 辑更稳. -->  Github 是 直接拉的 trending 榜,所以 没有太大的必要做筛查,所以没动 <!-- 这是一张图片,ocr 内容为:请问吧时效改到7天以后,对比之前的抓取少了多少条信息呢 A!II_IVIV 你要的是"把时效改到了天后,相比之前少了多少条".我先检查数据库和代码里有没有保留变更 前后的计数依据,如果有我直接给你精确对比,没有的话我会明确告诉你差在哪. -->  <!-- 这是一张图片,ocr 内容为:我刚做了一次同批实时抓取对照,用的是"不过了天过滤"和"过7天过滤"两套统计.这个结果反 映的是本次抓取少了多少,不是历史回放值. 这次总共是: 原始抓取:191条 -7天过滤后:137条 -少了:54条 降幅:约28.3% 按模块看: 关键词抓取GEMINI 原始:40 过滤后:20 少了:20 关键词抓取CLAUDE 原始:69 过滤后:46 少了:23 TRENDING 热点抓取 原始:82 过滤后:71 少了:11 按来源看,这次被7天规则砍掉的主要是: 41条 HACKERNEWS:少了 少了13条 BAIDU_NEWS: WEIBO/GITHUB:这次基本没被 7天规则砍掉 BING GOOGLE_NEWS -->  虽然少了不少,但是 AI 认为,只保留 7 天,还是必要的,毕竟这个是热点工具,只需要最新的内容 <!-- 这是一张图片,ocr 内容为:>你觉得要只保留7天还是不要 MODEL METADATA FOR "GPT-5.6-TERRA' NOT FOUND. DEFAULTING TO FALLBACK METADATA; THIS CAN DEGRADE PERFORMANCE AND CAUSE ISSUES. 我建议保留7天过滤. 这是热点监控工具,不是资料库.去掉时效后,HACKERNEWS的关键词搜索会混进很多历史旧站, BAIDUNEWS也会出现过期报道,结果数量变多但价值会明显下降. 本次实测少掉的 54条里,41条来自过期的 HACKER NEWS,13 条来自 BAIDU NEWS:这说明过滤 BING的新内容. 主要是在清理旧内容,不是在误伤微博,GOOGLENEWS或BINGF 建议保持当前规则: - WEIBO, HACKER NEWS, GOOGLE NEWS, LE NEWS,BING,BAIDU NEWS:只保留7天内内容 GITHUB TRENDING:继续不按发布时间过滤,因为它本身已经是日榜 后续优先补强BAIDUNEWS的时间解析,避免少量新文章因无法识别发布时间被过滤掉 这样信息会少一些,但"热点"会更可信. -->  信息质量和丰富度平衡 这里体现了一个重要的工程原则,先宽后严格 数据采集要多 --> 基础过滤(去重,时间) --> AI 深度分析(相关性,真假)-> 最终展示 在数据采集阶段,要把搜索范围拓宽,不要过早过滤,过滤应该分层 1. 第一层: 基础过滤(去重,时间窗口,格式校验) 2. 第二层:质量过滤() 3. 第三层 AI 深度分析(真假识别,相关性评分) 如果第一层就过滤过于严格,后续 AI 分析就没有用物之地了 <!-- 这是一张图片,ocr 内容为:目前的过滤规则可以简化为: 抓到一条内容 找发布时间 能确认且超过7天:丢弃 严格来源但无法确认发布时间:丢弃 其余内容保留 去重 关键词任务再做AI相关性判断 入库 具体规则: 7天窗口:发布时间必须不早于"当前时间减7天". 严格来源:WEIBO,HACKERNEWS.BING. GOOGLE_NEWS, BAIDU_NEWS. SOGOULWEIXIN. -超过7天:不入库. -日期无法解析:不入库. GITHUB TRENDING: 抓取时不按仓库发布时间过滤,因为来源是GITHUB日榜. 但数据库里保存的GITHUB记录也只展示和保留7天. 发布时间查找顺序: NEWS的TIME HACKER PUBLISHED_AT CREATED_AT W_DATA 内的 PUBLISHED_AT, CREATED_AT,TIME RAW_DAT 日期格式:支持UNIX时间截,ISO,RSS新面时间,微博时间,中文/英文相对时间,例如2小 时前,3 DAYS AGO. 关键词监控的 AI判断: 时效过滤通过后才调用AI. -AI只判断"是否与关键词相关",不判断发布日期. - 要求 RELEVANT-TRUE 且 CONFIDENCE >:0.6 才入库. 数据库兜底: 每次监控或采集开始前清理CREATED_AT超过7天的记录. 列表接口与单条详情接口也会排除超过7天的数据库记录. --> 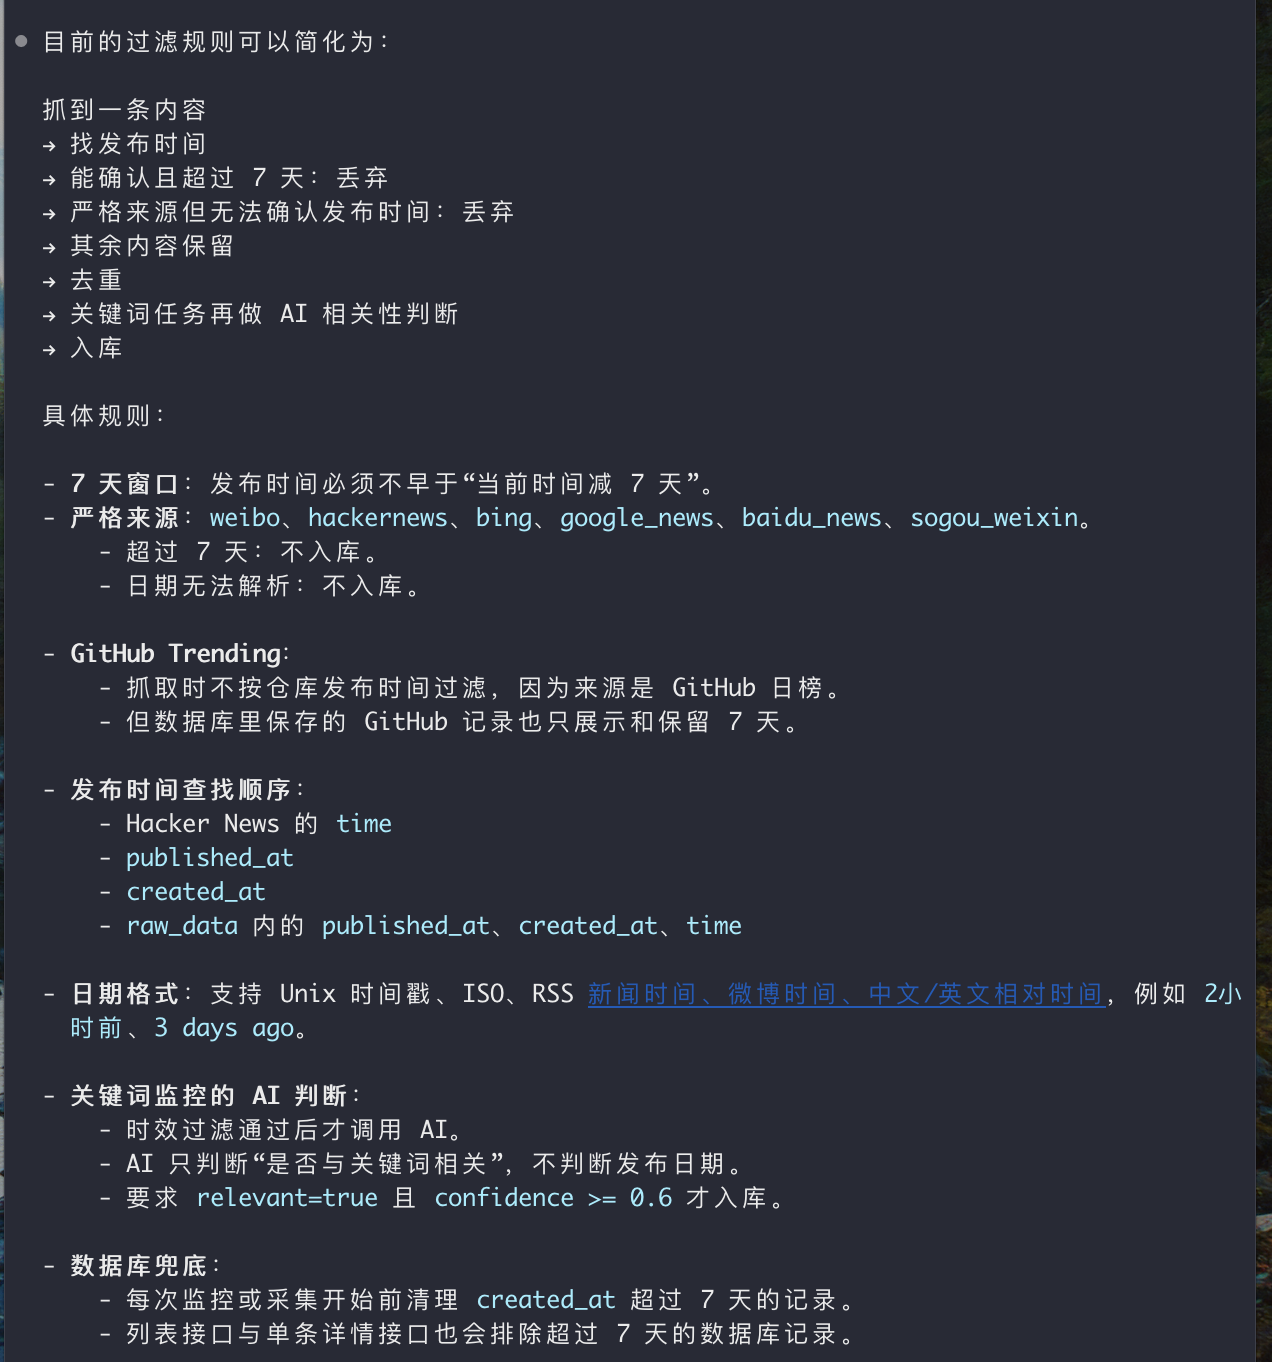<!-- 这是一张图片,ocr 内容为:有一部分,但目前不是完整的"信息源可靠性判断". 微博内容进入 AI相关性判断前,爬虫会先做一层质量筛选,代码在BACKEND/APP/SERVICES/ SCRAPERS/WEIBO.PY:359: 读取帖子互动数据:转发数,评论数,点赞数. 文本少于 18 个字符:直接过滤. 质量分计算: 转发:每条+2,最多按20条计算. 评论:每条+3,最多按 20条计算. 点赞:每条+1,最多按50条计算. 文本长度至少60字:+8;至少 30字:+4. "转发微博""哈哈"打卡"等低信息内容:-12. 转发帖:-10. 通过规则: 评论至少3条,或转发至少2条,并且质量分至少8;或者 总互动量至少 12,并且质量分至少 15. 所以,评论,转发,点赞已经用于过滤低质量微博. 但你说的"博主本人的粉丝数,认证,账号可信度",目前只用于账号搜索与账号卡片; 账号名称和关键词的匹配度是主条件. 已认证账号会加分. 粉丝数会有少量加分. 账号卡片本身的分数也会参考粉丝数. 分在 BACKEND/APP/SERVICES/SCRAPERS/WEIBO.PY:284 和 BACKEND/APP/SERVICES/SCRAPERS/ 这部分在 WEIBO.PY:328. 当前缺口是: 普通微博帖没有使用发帖人粉丝数,认证状态,账号类型来决定是否保留. AI相关性判断只收到标题和URL,不会看到评论数,点赞数,粉丝数,认证信息. 互动量目前判断的是"这条微博是否有一定讨论度",不是"这位作者是否可靠". 另外,微博的最终展示分会混合AI相关性和互动质量: 最终分 75%AI关键词相关性置信度+25%微博互动质量信号 其中互动质量信号会使用评论,转发,点费;但粉丝致只对"账号卡片"额外生效,不对普通发帖人 生效.代码在 BACKEND/APP/JOBS/MONITOR.PY:3333 和 BACKEND/APP/JOBS/MONITOR.PY:350. -->  以上是 AI 终结的筛查步骤,基本符合,我要求的层级递进筛查 # 5.信息流筛选和排序 ## 问题 目前我们获取到的了点全都堆在一起,不利于人工检索,因此希望能够对帖子进行节选和排序 <!-- 这是一张图片,ocr 内容为:TREND RADAR 热点追踪 系统设置 AI 热点雷达 当前信号 先看到趋势,再决 4 12 定要不要追. 已加碳热点条日 最新捕获 为高提分享者设计的AI热点监控台.把HACKERNEWS,GITHUB和新闻流压缩成高密度信号,帮 你更快判断什么值得立刻阅读,整理,转发和输出. 7月14日 4 来源铸选 是新一条入库时间 全部来源 统一热度BO的热点 立即采集 刷新列表 FEATURED 当前最值得打开的内容 CLAUDE CODE存在安全隐患,央煤:递防境外AI"后门风险 新浪财经 当前筛选 来限制来源,保持全局扫描视角. HREF-'HTTPS FINENS GOOGLE.COM/RSS/ARTICLES/CBMIEEFVX3IXTE4AMPPYNZNA2XBEK5/XODSUGZECUGZECU9RRWVLZJZ CC-5'TARGET:"-BLANK>CLAUBECODE存在安全隐患,央媒:谨防填外AR局门风险(/A)(TONTCOLOR 立即查看 ALL SOURCES 标签热度 等待更多内容来提炼热点标签. 值得立刻读的热点 .但不把你拖进复杂操作里,内容优先,动作第二,装饰最后. 保留足够强的信息层级,但不 7月14日 7月14日 7月14日 7月14日 CLAUDE 和 CODEX 这两家,现在打 CLAUDE CODE存在安全隐患,央 ANTHROPIC发文称自家 CLAUDE已 拘屁公司好不容易买了个CLAUDE. 经开智,网友:为了上市,不择手 媒:谨防境外A严后门风险新浪 得火热,你发一个新功能,我就跟 结果没几天就因为THIS IS CHINA封 一个更狠的,版本迭代的节奏越来 段?雷峰网 号了,现在让我设计一堆图,又把 财经 越快,竞争肉眼可见地在升温,用 我当美工使啊 户也跟着受益,两边都在拼命卷体 狗层公司好不容易买了个CIAUDE,结果 验,卷能力上限.反倒是 没几天就因为THIS ISCHINA封号了,现 OPENCLAW和HERMES.好像突然 在让我设计一增图,又把我当美工使啊 文称自家CLAUDE 已经开智,网友:为. 安静了下来.前段时间还有些声 门 风险:/FCNT COIOR 了上市,不择手段?(LA)(FONT 量,最近却几乎没什么动静了.这 新波财经</FONT) COLOR .6616R雷峰网://FONT 其实挺值得琢磨的..全文 CLAUDE和 CODEX 这两家,现在打得火 热.你发一个新功能.我就跟一个更银 的,版本这代的节要越来越快,竞争肉 眼可见地在升溜.用户也跟着受益. 7月14日 7月24日 7月14日 7月14日 HECKER NEWS 清华校友总会A大数据专委会走进 年初的时候,我制作了一套提示 OPENAL壁脸输出!仅5分钟,把 FUNDAMENTALS OF WIRELESS 有道,观察ALAGENT应用新样本. 词,在大模型里,你只需要把文章 COMMUNICATION (2005) GPT-5.6塞进CLAUDE老家-智源社 扔进去,它就会制作成文字海报 京报网 区 这条内容智无摘要,建议直接打开原文 包含封面图,标题,作者,时间以 判断它是否适合进入你的分享流. 及正文,并切成符合内容平台发布 HREF"HTTPS LLNEWS GOOGIE.COM/RSS/AR HREF 'NTTPS LLNEWS GOOGLE COMLRSS/AN 的图片,还挺好用的,最近我看微 OC5 TARGOT-BIANK"清华校友总会 OCSTARGETM"_BLANK`CPENAL骑脸 博开启了一个VIBELAB的A创意 输出!仅5分钟,把GPT-5.6塞进CIAU. AL大数据专委会走进有道,观察A. 赛,所以我也想参赛一下.昨天我 老家(LA)(FONT COIOR"#61616161616161616R 就把这个提示词扔给了AI,在 社区(FONT COLOR"#661京按网(FONT CLAUDE COD...全文 年初的时候,我制作了一套提示词.在 大模型里,你只需要把文章扔进去,它 就会制作成文字海报,包含封面图,标 题,作者,时间以及正文,并切成符. 7月14日 7月24日 PHAT 09 GOOGLE NEWS 11天,64个CLAUDE,112万元: 报告称CLAUDE CODE处理用户请求 ANTHROPIC发文称自家CLAUDE已 HOW TO GET CLAUDE PRO FOR FREE IN 经开智,网友:为了上市,不择手 2026(11 PROVEN WAYS) 用RUST重写 BUN手机网易网 前消耗TOKENS量约为OPENCODE的 段?新浪网 4.7倍-凤凰网科技 -->  为什么需要筛选和排序? 系统从 7 个信息源采集数据后,一次扫描可以产生几十条甚至上百条结果,如果内容平铺展示,用户需要逐条阅读才能找到有价值的信息,效率很低 筛选和排序解决了两个核心问题 1. 信息过载: 通过筛选条件缩小范围,快速找到特定类型的信息 2. 优先级判断:通过排序将最优价值的信息排在最前面 这是经典设计,类似电商商品筛选,和行文客服内容排序 ## 方案设计 直接让AI 帮我分析,提供哪些筛选方式和排序,不用人工去想,让AI找我们确认 ```markdown /mention /path/to/AGENTS.md 你是一位专业的程序员,现在请你根据我的需求和方案、以及已经开发完成的前端和后端项目,在此基础上进行优化和功能扩展。 ## 提供给你的资料 需求文档 AGENTS.md 必须完整分析前端和后端已有代码 ## 本次需求 @当前的需求 请你先帮我思考有哪些排序和筛选方式(尽量丰富),并且找我人工确认,不要直接开始开发。 ``` <!-- 这是一张图片,ocr 内容为:现状 目前仅支持单一来源解造:列表固定按入库时间倒序,没有可选择序.见FRONTEND/SCNLENS/DASHBOAND APP/API/TRENDING.PY:22. 可用学校有来派,监控关键词,A工直信度,统一分数,来集时间;真实发布时间和媒体名尚来规范化为数据库学政 NONMAIIZED 500RS 存在J50V 原购数据中,无法可采用于效摇库排序;全同热点的现有"热或自来面轮响顺斥,不宜直 接作为"最热"排序. 标签数据当前全为空,标签筛选需先增加标签生成;来源筛选遗漏了搜狗微信. 建议方案 ,基础铸选:多选来源,范围(全局热点(指定关键词),发布时间(24小时,3天,7天),热度区间,A工置信度区间,标题( 摘要搜索. 排序:最新发布,最新采集,综合推荐,热度最高,AL相关性最高;固定ID作为次级排序,保证分页不跳项 数据优化:细加 PUBLISHEDLAT,NORMALIZED-SCORE,SOURCE.NAME 等可查询字段与索引; 文章时间缺失的 GITHUB TRENDING TRENDING TRENDI 确显示为"采集时间". 界面:顶部常用快捷筛选,展开"高级筛选",显示结果数和"一键重置";补齐搜狗微信. 可选增强:为每条内容生成AI标签后,再提供标签筛选.会增加AT调用与成本,建议独立决定. 热度修正:重构全局热点的统一热度后再开放"热度最高",避免把当前采集顺序误当热度. 请确认两点后我再开发: 1.是否按"基础筛选+五种排序+数据字段规范化 热度修正"实施? 2.AI标签筛选本次做,还是暂不做? WORKED FOR 7M 49S -->  <!-- 这是一张图片,ocr 内容为:已实现 一热点页新增多来源,范图,时间,关键词,推荐分,AL置信度,搜索筛透,以及五种排序.FRONTEND/SRCNTEWSL DASHBOARD.VUE:29 接口在数据库端执行筛选与稳定分页,支持重复 SOURCES 参数.BACKEND/APP/APP/APP/APP/APP/APP/APP/APP/AP 入库规范化保存发布时间,缓体名,热度与综合推荐分;全局热点不再用来源轮调顺序评分,BACKEND/APP/108S/NONITOR.42 SQLITE会在后端启动时自动迁移历史表并回填可用字段.BACKEND/APP/DB/DB/MODELS.PY:28 未增加AI标签调用;README已补充查询参数说明. 验证 -通过PYTHON语法检查,旧SQLITE副本迁移与组合筛选查询验证. FRONTEND 的 NPM RUN BUILD 通过. 未执行 GIT COMMIT. -->  最后方案如下 # 热点筛选与排序 ## 筛选 | 维度 | 可选值 | 说明 | | --- | --- | --- | | 来源 | HN、Bing、Google News、百度、搜狗微信、微博,可多选 | 只看指定信息源;不选即全部来源。 | | 发布时间 | 24 小时、3 天、7 天 | 按文章发布时间过滤。 | | 监控关键词 | 已建立的任一关键词 | 只查看该关键词经过 AI 相关性判断后入库的内容。 | | 最低推荐分 | 不限、60+、80+ | 筛选综合推荐分较高的内容。 | | AI 置信度 | 不限、60%+、80%+ | 所有展示内容均来自关键词监控,因此都有该字段。 | | 文本搜索 | 标题、摘要、媒体名 | 可搜索 `Gemini`、`OpenAI` 或媒体名称。 | ## 排序方式 | 排序方式 | 规则 | 说明 | | --- | --- | --- | | 综合推荐 | 综合推荐分降序 | 默认方式;`75%` 标准化热度 + `25%` 新鲜度。 | | 热度最高 | 标准化热度降序 | 统一到 `0-100`,避免混用不同来源的原始分数。 | | AI 相关性 | AI 置信度降序 | 与监控关键词最相关的内容优先。 | | 最新发布 | 发布时间降序 | 优先展示近期发布的内容。 | | 最新采集 | 入库时间降序 | 展示系统最近抓到的内容,不等同于文章发布时间。 | 所有排序在分数或时间相同时,都会按记录 `id` 倒序,保证分页顺序稳定。 # 当前打分逻辑 页面展示的是 `recommendation_score`,即综合推荐分,范围固定为 `0-100`。 系统已经移除全局热点采集,因此页面中的每一条内容都属于关键词监控,并且只有 AI 判断为相关、置信度不低于 `0.6` 的内容才会入库。 ```latex 标准化热度 = AI 相关性置信度 × 75% + 来源信号 × 25% 综合推荐分 = 标准化热度 × 75% + 新鲜度 × 25% ``` 展开后,综合推荐分的实际权重为:AI 相关性 `56.25%`、来源信号 `18.75%`、新鲜度 `25%`。 ## 标准化热度 不同来源的原始数据不能直接比较,因此会先转换为 `normalized_score`。 | 来源 | 标准化热度逻辑 | | --- | --- | | Hacker News | `帖子分 / 18 + 评论数 / 6`,最高 100 分。 | | 微博 | 内容质量分 × 55% + 转评赞互动;账号类结果额外加入少量粉丝信号。 | | 搜索新闻类 | 基础 35 分 + 有摘要 18 分 + 标题完整度最多 12 分 + 内容新鲜度最多 25 分。 | 所有来源在计算出来源信号后,都会与 AI 相关性置信度合成为标准化热度:`AI 相关性置信度 × 75% + 来源信号 × 25%`。 ## 新鲜度 新鲜度也按 `0-100` 计算,并在综合推荐分中占 25%。 + 刚发布的内容接近 100 分。 + 7 天时约为 30 分。 + 无法解析发布时间时,按 55 分处理。 因此,页面上的“推荐 85”不是原始点赞数或 Hacker News 原始分数,而是将来源热度、内容质量、AI 相关性和发布时间统一后的分数。 ## 代码入口 + 来源热度、AI 加权、新鲜度与综合推荐分:`backend/app/jobs/monitor.py` + 列表筛选和排序:`backend/app/api/trending.py` + 前端展示分数:`frontend/src/views/Dashboard.vue` <!-- 这是一张图片,ocr 内容为:LIVESIONALBOARD 当前信号 先看到趋势,再决 定要不要追. 1 6 为高频分享者设计的AL热点监控台.把HACKERNEWS,GITHUB和新闻流压缩成高密度信号,帮 你更快判断什么值得立刻阅读,整理,转发和输出. 立即采集 刷新列表 实时活跃数据源 已加载热点条目 来源 GOOGLE NEWS GITHUB HACKER NEWS WEICO BAIDU NEWS SOGOU WEIXIN BING NEWS 最新捕获 高推荐内容 排序方式 内容范围 发布时间 最近7天 全部内容 综合推荐 搜素标题,摘要或媒体 最低推荐分 3 8H AGO 例如:GEMINI,CPENAL,模型发布 全部关键调 不限 AI置信度 不限 清除筛选 最新一条入库时间 综合推荐分 80+的热点 AL置信度仅适用于关键词监控内容;CIHUB TRENDING没有原始发有原始发有原始发有原始发有原始发有原始发有原始发有原始发有原始发有原始发有原始发有原始发有原始发有时间时按采集时间接造. 推荐98 HACKER NEWS 当前最值得打开的内容 当前视图 全部内容,1个来源,7D内. TERENCE TAO'S CHATGPT CONVERSATION ABOUT THE JACOBIAN CONJECTURE COUNTEREXAMPLE 立即查看 抓到第一条热点后,这里会优先展示最值得你第一时间读的信号. 综合推荐 MOMENTUM 标签热度 等待更多内容来提炼热点标签. NO TAGS YOT HOT LIST 值得立刻读的热点 保留足够强的信息层级,但不把你拖进复杂操作里.内容优先,动作第二,装饰最后. 23H AGO 7月22日 7月22日 7月22日 HACLCER NEWS 推荐85 HACKER NEWS 推荐80 推荐98 HACKER NEWS HACKER NEWS 推荐98 JOHN C. DVORAK HAS DIED TERENCE TAO'S CHATGPT SHOW HN:BENTO-AR SO REDDIT HAS DECIDED THAT PLAIN POWERPOINT IN ONE HTML FILE HTML IS UNSAFE CONVERSATION ABOUT THE 这条内容哲无摘要,建议直接打开原文 (EDIT+VIEW*DATA+COLLAB) JACOBIAN CONJECTURE 判断它是否适合进入你的分享流. 这条内容暂无摘要,建议直接打开原文 COUNTEREXAMPLE 判断它是否适合进入你的分享流. 这条内容暂无摘要,建议直接打开原文 判断它是否适合进入你的分享流. 这条内容暂无摘要,建议直接打开原文 判断它是否适合进入你的分享流. READ NOW 7月22日 7月22日 推荐57 HACKER NEWS ARE AL LABS PELICANMAXXING? GIGA TOKEN:~1000X FASTER LANGUAGE MODEL TOKENIZATION 这条内容暂无摘要,建议直接打开原文 判断它是否适合进入你的分享流. 这条内容暂无摘要,建议直接打开原文 判断它是否适合进入你的分享流. READ NOW 加载更多热点 -->  ### 人工测试验证 发现 内容概括出现了带 html tag 的问题,要么没有 <!-- 这是一张图片,ocr 内容为:8月12日 推荐95 BING NEWS CLAUDE2-ANTHROPIC 暂无可用摘要,建议打开原文查看详情. READ NOW --> 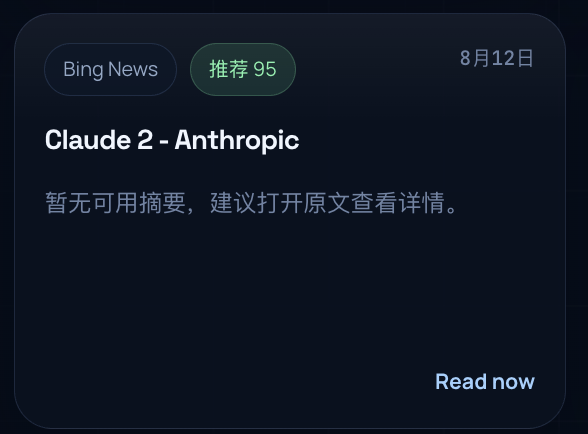<!-- 这是一张图片,ocr 内容为:8月12日 推荐96 GOOGLE NEWS 在CLAUDE CODE里用GPT被秒封!义父 TIBO:别急,我给你重置-智源社区 <A HREF"HTTPS://NEWS.GOOGLE.COM/RSS/ARTICLES/C "_BLANK">在CLAUDE CODE里用 OC5"TARGET" GPT被秒封!义父TIBO:别急,我给你重置... READ NOW -->  直接让 AI 进行修复 ```markdown 我:我发现,我的帖子 摘要都很有问题,这是为什么,有没有解决方案 ``` <!-- 这是一张图片,ocr 内容为:原因已经确认:当前卡片里的"摘要"并不是A工生成的文章摘要,大多数只是搜索源返回的原始片段,且没有级 一清洗. 数据库里实际情况: GOOGLE NEWS 33 条都有"摘要".但内容是 RSS的 HML 链接片段,例如 <A HREF-".."标题</A>.前端直接 显示了这段原始HTML文本. BAIDU NEWS 7条摘要全为空. BING12条里有10条为空. HACKER NEWS 5条也都为空. OPENROUTER.PY 里的 GENERATE-SUMMARYO)目前只用于每日部件汇总,没有用于新间卡片;关键词AI判断也. 只传了标题和URL,并未读取正文. 所以问题不在前端,而在采集链路:没有获得可用正文,也没有生成统一摘要. 建议的解决方案: 1.先清洗所有来源的原始片段 用 BEAUTIFULSOUP 去除 HTML,链接,广告标记,避免 GOOGLE N GLE NEWS 的 <A> 标签显示在卡片中. 2.对可访问的原文抓取正文或META DESCRIPTION GOOGLE/BING/百度等结果先解析最终原文地址,再提取页面标题,描述和前几段正文. 3.用AI批量生成短摘要 基于"标题+清洗后的片段/正文",生成60-100字中文摘要;要求只复述给定材料,不足以概括则不编造. 4,设定可靠降级 原文抓取失败时,显示清洗后的搜索片段:片段也没有时,显示"暂无可用摘要",而不是让A工根据标题猜. 测. 我建议按以上完整方案做.代价是每次采集会多一些原文请来和一次批量A1调用,采集时间会增加,但捐要质 量会明显改善. -->  <!-- 这是一张图片,ocr 内容为:我建议,先只做抓取METADESCRIPTION放在 SUMMARY,如果没有,就显示暂无可用摘要 我会只做原文METADESCRIPTION;采集结果在通过时效与相关性弹选后,再并发请求原文页提取描述;取不到航 保持空值,前端明确显示"暂无可用摘要".不会使用AI生成或猜测摘要. EXPLORED - READ MONITOR.PY, DASHBOARD.VUE, REQUIREMENTS,TXT, BAIDULNEWS.PY, SOGOULNEIXIN.PY, WEIBO.PY SEARCH SEARCH-LRETURN \[LSUMMARYLSNIPPETLDESCRIPTIONLURL IN SCRAPERS H ASYNC DEF RAN SED -N '1,160P' BACKEND/TESTS/TEST-TRENDING-SORTING.PY 8& GIT STATUS --SHORT IMPORT ASYNCIO FROM DATETIME IMPORT DATETIME, TIMEDELTA, TIMEZONE +163 LINES (CTRL + T TO VIEW TRANSCRIPT) ?? DOCS/IMAGES/ ?? "DOCS//351\241\271\347\233\256\347\254\224\350\256\256\260.MD" -->  这里为了降低 AI 开销,我选了直接 抓取,网页上的摘要,而不是通过 AI 提炼,所以效果不一定很好,但是姑且选择这种方案 <!-- 这是一张图片,ocr 内容为:已按你的方案实现,不使用 AI 生成摘要. 现在新闻/文章类来源的流程是: 1.通过关键词相关性判断后,访问原文页面. 2.只提取 OG:DESCRIPTION,否则提取 META[NAME-"DESCRIPTION"]. 3.获取不到,页面不是HTML,请求失败或没有 META DESCRIPTION时,摘要为空. 4,前端显示"暂无可用摘要,建议打开原文查看详情. 微博不走原文META抓取,仍显示微博帖子的正文,因为它本身就是原始内容. 另外,重复采来到同一个 URL时,会更新旧记录的摘要.因此重新点击"立即采来"后,1日的 GOOGLENS RSS HTML和搜索片段会被替换为 META DESCRIPTION;取不到就清空. 已验证:PYTEST 共5PASSED,PYTHON 语法检查,前端 NPM RUN BUILD 与 GIT DIFF --CHECK 均通过.当前改 动尚未提交. -->  修复完成后,我发现 google news 的来源还是有 html 的 herf tag 于是追问,AI 为什么 这个来源有这个问题,以下是他的回答 <!-- 这是一张图片,ocr 内容为:问题已经确认:GOOGLE NEWS RSS给的是NEWS.GOOGLE.COM跳转链接,不是真正的媒体原文链接.请求这个链接 NEWS 自己的通用 DESCRIPTION.所以无法获得新闻原文的 META DESCRIPTION;旧记录则还保 只能拿到GOOGLE 留着RSS的HTML片段. 我会修正为:GOOGLENS 跳转页的摘要一律视为空,不保存适用描述或 RSS HML:同时清理数据库中已有的 GOOGLE NEWS HREF 摘要,让页面直接显示"暂无可用摘要". -->  这里我同意他的方案,让 google news 的摘要暂时为空 ### AI 编写单元测试 <!-- 这是一张图片,ocr 内容为:请问你有写TESTCASE验证过这个排序吗 我会检查仓库现有测试目录和本次提交的验证记录,区分"构建检查"手动查询验证"和直正可重复执行的排序测 EXPLORED - SEARCH TESTS IN BACKEND *TEST* LIST RG --FILES -G -G PYTEST.INI -G PYPROJECT.TOML -G TOX.INI -G PACKAGE.JSON -G *1 * 'VITEST.CONFIG. -G 'JEST.CONFIG. " D3E813A GIT SHOW --NAME-ONLY --FORMAT-' RANGITSHOW-- -STAT --ONELINE D3E813A && GIT SHO D3E813A REFINE KEYWORD-ONLY MONITORING AND RANKING I 22+++ README.MD +22 LINES (CTRL + T TO VIEW TRANSCRIPT) FRONTEND/SRC/SERVICES/API.JS FRONTEND/SRC/VIEWS/DASHBOARD.VUE 没有.当前仓库没有TESTS/目录或测试框架配置,本次只做了: PYTHON语法检查 前端 NPM RUN BUILD GIT DIFF --CHECK 之前曾用临时数据库做过筛选/排序的手动查询验证 但没有写成可医复执行的 TEST CASE.排序逻辑在 BACKEND/APP/API/TRENDING.PY:76,应扑充API/TRENDING. 综合推荐,热度,AI相关性,发布时间,采集时间,以及同分时按ID倒序的稳定分页规则. -->  <!-- 这是一张图片,ocr 内容为:用 PYTEST 完成一下 这些 没有 做的 TESTCASE 我会补齐可蛋复执行的 PYTEST测试,重点验证五种排序,同分时ID例序,以及分页不会重复或漏项.我会先 读取项目的依赖与数据库初始化方式,再按现有 FASTAPI/SQLALCHEMY 写最小测试架.这里会使用CONTEXT?查. 证当前相关库的测试写法. EXPLORED - READ SKILL.MD (CONTEXT7-MCP SKILL), REQUIREMENTS.TXT, DATABASE.PY,PACKAGE.JSON CALLED CONTEXT?RESOLVE-TIBRARY-ID("LIBRARYNAME"," ' PYTEST"," QUERY";"PYTEST ASTS WITH FASTAPI AND IRT DEPENDENCY OVERRIDES TEMPORARY SQLITE DATABASE"}) HTTPX ASGITRANSPORT DE AVAILABLE LIBRARIES: TITLE: PYTEST CONTEXT7-COMPATIBLE LIBRARY ID://PYTEST-DEV/PYTEST DESCRIPTION: THE PYTEST FRAM ST FRAMEWORK MAKES IT EASY TO WRITE SMALL TESTS, YET SCALES TO SUPPORT COMPLEX FUNCTIONAL TESTING CODE SNIPPETS: 2763 SOURCE REPUTATION:HIGH BENCHMARK SCORE: 81.55 VERSIONS:9.0.0 TITLE: PYTEST ASYNCIO CONTEXT7-COMPATIBLE LIBRARY ID: /PYTEST-DEV/PYTEST-ASYNCIO DESCRIPTION:ASYNCIO SUPPORT FOR PYTEST CODE SNIPPETS:106 SOURCE REPUTA.. -->  <!-- 这是一张图片,ocr 内容为: -->  <!-- 这是一张图片,ocr 内容为:已补齐 PYTEST 排序测试,测试通过: 1 PASSED 新增: BACKEND/TESTS/TEST,TRENDING-SORTING.PY:覆盖五种排序,最低推荐,最低推荐分过滤,排除过期/无关键词/不相关内 容,同条件按IDDESC,分页无重复无漏项. BACKEND/PYTEST.INI BACKEND/REQUIREMENTS-DEV.TXT README 中加入测试命令. 运行方式: CD BACKEND SOURCE /OPT/HOMEBREW/BIN/TARENA/BIN/ACTIVATE PIP INSTALL -R REQUIREMENTS-DEV.TXT PYTEST 测试使用临时SQLITE数据库,不会修改正式数据.当前这些测试改动尚未提交. WORKED FOR 47M 26S -->  这是一个良好的 AI 编码习惯,不仅修复 AI 问题,还验证了结果,好处是 1. 自动验证,不需要人工逐个测试每种排序 2. 防止回归:后续代码修改时,测试会自动检查是否破坏了排序逻辑 3. 文档作用:测试代码本身就是排序规则最好的说明 ### UI Bug 排查技巧 前端 UI Bug(如元素被遮挡、布局错乱)在 AI 编程中 很常见。排查技巧: 1. 截图给 AI:AI 可以通过截图理解问题 2. 描述具体现象:比如 “筛选栏被帖子内容遮挡了” 3. 提到 CSS 关键词:如 `z-index`、`overflow`、`position` 等,帮 AI 缩小排查范围 4. 浏览器开发者工具:按 F12 打开 DevTools,检查元素的样式和层级 5. 推荐一个 工具,浏览器插件,可以通过点击想要 ai 修改的页面元素,直接生成对应页面元素提示词,然后直接复制到对话框里 [https://github.com/oil-oil/selector](https://github.com/oil-oil/selector) 6. codex桌面版 自带浏览器 可以允许你在页面上进行标注,直接发给它 ### 成品效果图 <!-- 这是一张图片,ocr 内容为:热点追踪 关键涡 A热点雷达 LIVE SIONAL BOAND 先看到趋势,再决 定要不要追. 2 12 为高膜分享者说计的AL热点监控台,把HADKERNEWS,GITHUO和新闻速压缩成高击度信号. 都你更快到断什么值得立刻间读,整理,转发和输出. 立即果集 刷新列表 新新线快 最任脂肪分 8H AGO 12 不限 清阳路选 所有展示内部的已通过风轻动妇关但利期:从置您度及按与监控关键讨的还起权度. 当前视图 当前最值得打开的内容 全部关键词,全部来源.7D内. LOG IN TO YOUR CIAUDE ACCOUNT ICIAUDTELP CENTER 抓到第一条热点后,这里会优先黑示最值得你第一时间读的信号. 综合推荐 标签热度 值得立刻读的热点 保留足够强的信息层级,但不把你接进复杂操作里,内容优先,动作第二,装饰是后. 推荐06 在CLAUDE CODE 里用GPT被秒封! OPENAU报空CLAUDE CODE!用户家 义父TIBO:别急,我给你重置智 CLAUDE HELP CENTER 当一键进CODEX,唯独带不走 这条内容暂无胸药,建议直接打开原文 CLAUDE 新浪财经 EING NIONS CLAUDE和GPT思维链黄被两步蒸 馆!116灵论文曝光API致命满同. 投资界 这条内容皆无病婴,建议直接打开原文 这条内容皆无换要,建议直接打开原文 判断它是否适合进入你的分享流, OC 5' TARGET'_BLAUK`CIAUAE DOPT 思维链两被两步萧馏!116页论文曝光 226 APO 154 APO 三星引入CLAUDE模型定制SOC验证 A写的文章以后都要留痕了? DOWNLOAD CLAUDE AL (FREE)FOR DEEPBEEKPI王炸组合跑赢 CLAUDE宣布文本默认加入助形水 CLAUDE CODE?PI创始入:这套组 任务编组至两天观点网 WINDOWS,MACOS,ANDROIDIOS 合我早押中了产业链光通信PRO 印,网友热议:这会成为行业新趋 判断它是否适合进入你的分享流. HREF HTTPS ONEWS GOOGLE COMIRSSIAR CLAUDB模型宽制SOC验证任务缩短至. 人:这么概合投早押中了产业银((A) 后标要前康了77CLAJDO宣布文本献. BEDD NDW 加载更多热点 -->  ## 6.优化热点信息展示 ### 目前的问题 目前 已经展示了,重要性,来源,关键词,帖子标题 帖子描述,相关性,热度,等等但是可能还是要人工跳转到原始网站去获取一些数据,比如帖子发布时间,这都会浪费一些时间,**所以目标是能够节省人工判断信息价值的时间,更快定位需要的热点信息** ### 信息展示的设计原则 好的信息暂时应该遵循“**一眼不值**”原则,用户只需要看一眼,就能判断这条信息是否值得深入阅读 要实现这一点,需要在有限的空间提供关键决策信息 | 决策维度 | 对应信息 | 为什么重要 | | --- | --- | --- | | 时效性 | 发布时间,抓取时间 | 判断信息是否过时 | | 热度 | 点赞,转发,认证状态 | 判断信息关注度 | | 可信度 | 作者信息,认证状态 | 判断信息来源可信度 | | 相关性 | AI 相关性评分和理由 | 判断信息是否与关注话题相关 | | 原文链接 | 一键跳转 | 方便深入阅读原文内容 | 目前我的的界面缺少部分观点信息(如发布时间,互动数据等),导致用户需要额外跳转才能获取完整信息 提示词如下 ```markdown 你是一位专业的程序员,现在请你根据我的需求和方案、以及已经开发完成的前端和后端项目,在此基础上进行优化和功能扩展。 ## 提供给你的资料 plan.md 必须完整分析前端和后端已有代码 ## 本次需求 目前 已经展示了,重要性,来源,关键词,帖子标题 帖子描述,相关性,热度, 等等但是可能还是要人工跳转到原始网站去获取一些数据,比如帖子发布时间,这都会浪费一些时间, 所以目标是能够节省人工判断信息价值的时间,更快定位需要的热点信息 比如还可以展示 - 抓取时间 - 更多互动数据(比如点赞,转发,等等,有的话则展示) - AIf分析相关性的理由,支持展开折叠,以及一点展开所有帖子相关性的理由 此外,你还可以有自己的想法,比如还需要展示哪些信息(能达到我的目标),并且找我人工确认,不要直接开始开发。 ``` <!-- 这是一张图片,ocr 内容为:现状结论 已有发布时间,抓取时间和来源媒体字段,但卡片只显示其中一个相对时间,无法同时判断中容何时发布,系 统何时发现". 微博已有转发,评论,点盟;账号结果还有粉丝,关注,博文数与认证.HACKERNEWS 有帖子分和评论数.其 他新闻搜索源通常不提供可靠互动量. AI 批量相关性分析目前只保存 RELEVANT 和 CONFIDENCE,没有生成或持久化"相关性理由". 建议实施方案 实现内容 模块 规则 时间信息 卡片明确展示"发布时间"和"抓取时间" 均显示本地绝对时间,并保留相对时长;缺 失发布时间时明确标注"发布时间未知" 互动数据 按来源展示可用指标 微博:点赞,评论,转发;微博账号:粉 丝,关注,博文,认证;HN:帖子分,评论 数;其他来源不显示空指标 新闻显示媒体/站点,微博显示作者或匹配 展示已有 发布者/媒体 SOURCE_NAME 账号,减少跳转前的信息缺口 AI返回不超过约 60字的事实性理由;支 每条卡片新增默认折叠的"AI判断依据" AI相关性理由 持单条展开/收起及"展开全部/收起全部" 新增结构化互动字段和 数据存储 RELEVANCE_REASON 不向前端暴露完整RAW_DATA;历史记录从 已有原始数据回退读取互动指标,但不重新 调用AI补生成理由 AI输入 用标题,来源和可用文本片段判断 不再只让AI看标题和URL,理由必须基于 实际输入内容,降低编造风险 单批失败不应静默污染理由;保留现有"仅 批量AI结果按小批次处理,严格校验格式 稳定性 置信度>:0.6才入库"规则 覆盖互动字段归一化,理由持久化/API返 校验 补充后端PYTEST和前端构建验证 回,历史数据降级与展开状态 同时会修正看板中仍提及已移除的GITHUB 数据源,以及 README 中与当前六个数据源,摘要规则不一致的说 明. 请确认按以上方案开发. -->  <!-- 这是一张图片,ocr 内容为:UPDATED PLAN 后端,前端,测试,文档和本地API/浏览器验证均已完成. "扩展热点模型,迁移,API契约和互动数据归一化 接入批量AI-相关性理由并在入库流程持久化 改造热点看板的时间,指标,理由折叠和批量控制 补测试,同步文档并完成后端/前端验证 已按方案完成: 后端新增互动指标,内容类型,认证状态,AI判断理由字段. -微博,HACKERNEWS指标已归一化,历史数据自动迁移. AI批量分析现在会保存简短理由,失败时不会绕过相关性过滤. 前端同时展示发布时间,抓取时间,发布者/媒体和互动数据. 新增单条及全部展开/收起AI判断依据. 更新README和打分说明. BUILD 成功,浏览器布局检查通过. 验证结果:12PASSED,前端 RUN BU NPM 当前8000端口是旧后端进程,需要重启后才能看到新API字段: BACKEND CD SOURCE /OPT/HOMEBREW/BIN/TARENA/BIN/ACTIVATE UVICORN APP.MAIN:APP --RELOAD --PORT 8000 新采集的数据才会有AI判断理由,历史数据可能为空. WORKED FOR 12M 03S -->  成品展示 <!-- 这是一张图片,ocr 内容为:HOT LIST 收起全部AI分析 值得立刻读的热点 发布时间,发现时间和可用互动数据会直接显示在卡片中. 发布2026/08/13 发布2026/08/13 发布2026/08/13 BING NEWS BING NEWS BING NEWS 11:29 19:36 12:55 抓取2026/08/13 抓取2026/08/13 抓取2026/08/13 推荐96 推荐96 15:23 推荐96 14:40 19:53 GEMINI 2.5 PRO GEMINI API GOOGLE AL GOOGLE GEMINI AL: GEMINI 3.5 FLASH, GEMINI 3:INTRODUCING THE LATEST GEMINI NANO BANANA,LIVE,BEST FEATURES... AL MODEL FROM GOOGLE FOR DEVELOPERS GOOGLE GEMINI HAS SO MANY VERSIONS AND TODAY WE'RE RELEASING GEMINI 3 -OUR MOST 了解GOOGLE的GEMINI 2.5 PRO FEATURES THAT IT'S HARD TO KEEP TRACK.THIS INTELLIGENT MODEL THAT HELPS YOU BRING ANY GEMINI QUIDE WILL BREAK EVERYTHING DOWN. IDEA TO LIFE. 发布者/媒体:AI.GOOGLE.DEV 发布者/媒体:ANDROIDCENTRAL.COM 发布者/媒体:BLOG.GOOGLE AI判断依据 AI判断依据 AI判断依据 标题含 GEMINI API,内容介绍 GEMINI2.5 模型 标题与内容都在介绍GOOGLE GEMINI的AI功能 能力 标题与内容都在介绍 GOOGLE 最新GEMINI 模型 READ NOW READ NOW READ NOW 发布2026/08/14 发布2026/08/13 发布2026/08/14 BING NEWS BING NEWS GOOGLE NEWS 23:18 00:22 01:26 抓取 2026/08/12 抓取2026/08/13 抓取2026/08/13 推荐96 推荐96 推荐96 23:54 17:12 15:53 MODELS-GEMINI APL | GOOGLE AL FOR INSTALL CLAUDE DESKTOP LAUDE HELP AI打破37年数学纪录:黎曼猜想零点比例 推高至67.2%-新浪网 DEVELOPERS CENTER 了解GOOGLE 的所有最先进AI模型 暂无可用摘要,建议打开原文查看详情. 暂无可用摘要,建议打开原文查看详情. 发布者/媒体:NEWS.GOOGLE.COM 发布者/媒体:AI.GOOGLE.DEV 发布者/媒体:SUPPORT.CLAUDE.COM AI判断依据 AI判断依据 AI判断依据 仅提AI数学突破,标题内容均未提CLAUDE 标题为安装CLAUDE DESKTOP,内容介绍其功能 标题为GEMINI API,内容介绍其模型 READ NOW READ NOW READ NOW -->  # 信息判断效率优化前后对比 | 维度 | 优化前 | 优化后 | | --- | --- | --- | | 发布时间 | 已保存,但卡片只显示一个时间 | 明确显示“发布”和“抓取”时间 | | 抓取时间 | 仅作为发布时间缺失时的回退 | 每条卡片固定展示,便于判断发现时效 | | 互动数据 | 微博/HN 数据藏在 `raw_data`,前端不可见 | 微博显示点赞、评论、转发;账号显示粉丝、关注、博文与认证;HN 显示积分和评论 | | 发布者/媒体 | 部分有数据但不展示 | 直接展示账号、作者或媒体/站点 | | AI 判断 | 只有相关性置信度 | 保存简短相关性理由,支持单条展开与全部展开 | | AI 输入 | 主要使用标题和 URL | 使用标题、来源和可用文本片段 | | AI 异常 | 降级逻辑可能保留未经有效判断的数据 | 批次失败直接跳过,不绕开相关性阈值 | | 历史理由 | 旧记录均为空 | 已回填最近 7 天关键词记录的 62 条理由 | | Google News 理由 | 大量历史记录为空 | `59/63` 条已有理由;其余为旧全局热点,不在当前列表展示 | | 测试验证 | 无本次功能测试 | `13` 个 pytest 通过,覆盖采集、AI 判断理由、互动指标归一化、发布者和发布时间入库;前端生产构建通过 | ## 7.优化 AI 分析准确度+扩展思路 我们发现 AI 保留的内容可能跟关键词没有直接关联,会导致获取的信息咋软,比如关键词是 claude 结果搜出完全无关的内容,没有提到 claude,而且 ai 摘要和相关分析也显示没有什么关系,这不利于我快速判断热点内容和匹配度 <!-- 这是一张图片,ocr 内容为:发布2026/08/13 GOOGLE NEWS 23:18 抓取2026/08/13 推荐96 23:54 AI打破37年数学纪录:黎曼猜想零点比例 推高至67.2%-新浪网 暂无可用摘要,建议打开原文查看详情. 发布者/媒体:NEWS.GOOGLE.COM AI判断依据 仅提AI数学突破,标题内容均未提CLAUDE READ NOW -->  我们的目标是,优化 AI 审核热点准确度,过滤和关键词不搭相关的内容 ### 问题 根因分析 AI 相关性分析不准确的原因可能有多个层面 1. 搜索层面: 搜索引擎返回的内部本身就不够相关 2. prompt 层面:给 AI 的分析提示词不够精确,没有明确要求判断“是否” 3. 阈值层面: 相关评分阈值设置不合理,低相关性内容也被保留 4. 评估层面: 缺乏系统化的测试机制,无法量化分析质量 ### 解决方案 ```markdown 你是一位专业的程序员,现在请你根据我的需求和方案、以及已经开发完成的前端和后端项目,在此基础上进行 优化和功能扩展。 必须完整分析前端和后端已有代码 本次需求 我们发现 AI保留的内容可能是跟关键词没有直接关联的,会导致获取到的信息杂乱。 比如关键词是 claude 和 gemini,结果搜出现了 AI 打破 37 年数学记录、没有提到 Claude 和 Gemini 的内容。而且 AI摘要和相关性分析没什么关系,只是在介绍内容而已,不利于我快速判断热点的内容和匹配 度。 我们的目标是,优化 AI 审核热点的准确度,过滤掉和关键词关联不大的内容。 此外,你还可以有自己的想法,无论如何都要达到我的目标,并且找我人工确认,不要直接开始开发。 要注意,由于相关性分析不像数据一样是精确的,而是一段话,所以建议让AI 自己建立测试和评估机制,节省 我们后续测试的时间。 ``` <!-- 这是一张图片,ocr 内容为:你是一位专业的程序员,现在请你根据我的需求和方案,以及已经开发完成的前端和后端项目, 在此基础上进行优化和功能扩展. 提供给你的资料 @需求文档 @方案设计文档 必须完整分析前端和后端已有代码 本次需求 我们发现AL保留的内容可能是跟关键词没有直接关联的,会导致获取到的信息杂乱. 比如关键词是CLAUDE SONNET4.6,结果提出了仅和OPENCLAW相关的,没有提到CLAUDE SONNET 4.6的内容.而且AL摘要和相关性分析没什么关系,只是在介绍内容而已,不利于我快速判断热 点的内容和匹配度. (如图) 我们的目标是,优化AI审核热点的准确度,过滤掉和关键词关联不大的内容. 此外,你还可以有自己的想法,无论如何都要达到我的目标,并且找我人工确认,不要直接开始 开发. 要注意,由于相关性分析不像数据一样是精确的,而是一段话,所以建议让AI自己建立测试和评 估机制,节省我们后续测试的时间. -->  <!-- 这是一张图片,ocr 内容为:问题定位 已完整检查采集,审核,入库,API,看板和现有测试.根因明确: -相关性提示允许"直接相关概念",却没有要求关键词的可验证文本证据.ANTHROPIC,这AI,数学突破会披理 型自行推断为CLAUDE相关. AT审核发生在原文META DESCRIPTION获取之前,主要依据标题,搜索片段或微博正文. AI理由未要求输出"关键词出现在哪,原文证据是什么",因此容易变成内容介绍. 数据库样本已证实问题:CLOUDE 的"AI打破 37年数学记录"被保存为 0.99置信度,而其理由本身写着"未提 CLAUDE". 补充说明:卡片的SUMMARY 不是AT摘要,而是原网页的 META DESCRIPTION;AI实际生成的是 RELEVANCE_REASON.因此摘要不会天然解释关键词匹配. 建议方案 改造方案 环节 仅当关键词在标题,提索片段,微博正文中直接出现时,才送入AI;大小写,空白和全半角 硬性预过滤 归一化.ANTHROPIC 不等同于 CLAUDE,GOOGLE 不等同于 GEMINI. 微博账号例外 若关键词与微博账号精确匹配,可保留账号及该账号的帖子,并记录"账号匹配"证据. AI审核 AI 返回结构化结果:RELEVANT,CONFIDENCE,MATCH.TYPE,EVIDENCE,REASON.EVIDENCE 必须是原始文本中的短引文. 代码复核 代码再次验证:AT返回的证据必须真实存在于候选文本,且包含关键词;否则强制判为不相 关, 入库规则 仅"硬性命中+AI相关+置信度达标+证据有效"的内容入库. 前端表达 卡片增加一行"关键词命中:CLAUDE,标题/正文/账号",展开后显示原文证据和AI关联解 释;原网页摘要明确作为内容简介,不再与匹配理由混淆. 扫描现有关键词记录;不含直接证据的记录标记为不相关并从列表隐藏,不物理删除,保留 旧数据清理 审计能力. -->  <!-- 这是一张图片,ocr 内容为:AI自评与测试 ,建立版本化的正例,硬负例和账号例外样本集:包含"CLAUDE 水印"GEMINI发布"正例,以及"黎曼猜想"仅 ANTHROPIC"仅 GOOGLE""泛 AI"负例. 新增PYTEST:验证硬过滤,AI虚假证据拒绝,账号例外,入库拦截及前端API字段. 新增可选AL红队评估脚本;让A工为每个关键词生成"看似相关但未提关键词"的干扰样本;代码验证其不含 关键词,再用正式审核链路评测. 输出准确率报告,目标是:硬负例误放行0,所有入库内容证据有效率100%.该评估只在调整,PROMPT/很型或 手动执行时运行,不加入每30分钟采集,避免额外API成本. 需确认 建议采用上表的"严格直接命中"策路,并将旧的不合规记录标记隐藏而非删除.代价是:标题和正文都未出现 CLAUDE/GEMINI的公司级新闻,即使可能间接相关,也不会保留. 请确认按此方案开发. -->  再让 ai 加入 query expansion 功能来提供准确度。这里我每次输入热点关键词,让 AI 生成相关的变体列表,让搜索到的内容变得更广泛,以免有漏网之鱼 为什么 Query Expansion 提高准确度 1. 覆盖更多表达方式 2. 跨预约覆盖中英文都能检索到 3. 缩写和全称能覆盖 4. 减少纰漏,不会因为关键词拼写差异,错过重要信息 <!-- 这是一张图片,ocr 内容为:我同意你的所有方案,但是还要注意: 也被错误过滤了,所以我们可以用QUERYEXPAND查询扩展. AL提到要用基础文本匹配过滤,也就是说内容必须要包含关键词,可能就会导致有些相 似的合理内容 比如你搜索(鱼皮的AI导航),可以扩展为(程序员鱼皮的A1导航),(AI导航鱼皮) 鱼皮AI编程教程等,从而提高检索到的内容的数量. QUERYEXPANSION应用于"召回",但不能直接放宽入库标准;否则会重新引入泛AL噪声. 调整后的方案 规则 环节 AL为每个关键词生成并保存:实体锚点,搜索扩展词,可接受关联词和反例边界. 关键词画像 查询扩展 每个来源使用原关键词加最多4个扩展查询,合并后再做URL/标题去重. 鱼皮的AI导航可扩展搜索程序员鱼皮的AI导航,鱼皮AI导航,鱼皮AI编程数程. 示例 CLAUDE,GEMINI 仍要求文本直接包含本词或包含本词的产品变体,如 CLAUDE CODE, GEMINI 直接命中 API.ANTHROPIC或GOOGLE 单独出现不再算命中. 扩展词命中 对"鱼皮AL编程教程"这类扩展词,内容必须有实体错点"鱼皮(程序员鱼皮",再经AL证明它与"AI导航" 存在直接内容关系. 原词直接命中,或"扩展词命中+实体锚点+AL证据有效+更高置信度门槛".AL必须返回原文引文, 入库门槛 不可只写泛泛说明. 显示"命中词,命中位置,原文证据,关联解释",将原网页摘要与匹配理由明确分开. 理由展示 AL生成扩展词的正例,近似负例和混清样一:代码验证其文本证据与预期标签.输出原词(扩展词的误 评估机制 放行率和漏放率. -->  <!-- 这是一张图片,ocr 内容为:关键边界需要你确认: 是否允许叶展河命中,但未出现原始完整关键词"的内容入库?例如"程序员鱼皮的AI编程教程"没有完整写"鱼皮的A! 导航",但包含实体锚点且AI能说明其与AI导航直接相关. 我建议允许,但采用更高置信度门槛和强制证据校验.确认后我再开始开发. -->  ## <!-- 这是一张图片,ocr 内容为:将投确认的规则实现查询扩展和严格证据筛选;扩展调可入库,但必须命中实体验点,通过AL的直接关系判断及代码证 据校验;随后补充回归测试并验证.首先核对现有监控链路,模型和测试状态,避免覆盖未提交改动. 现有实现确突只依赖AL返回的 RELEVANT/CONFIDENCE/REASON,没有要求关键词或引用证据真实出现在原文:这正 是无关A1新闻被误收录的原因.接下来会在不破坏现有评分和展示字段的前提下,加入独立的"关键词画像,扩展查" 询,证据校验"层. 实现分为四层,且保持原始摘要不被AI改写: 1.为每个关键词缓存一个AL生成,代码校验过的检索画像,含最多4条扩展查询,实体锚点和边界. 2.各来源同时检索原词和扩展词,合并重复结果并记录命中的查询. 3.先以确定性的文本命中拦截无证据候选,再要求AL这回原文中的逐字证据;扩展河命中须有实体错点且置信度至少 0.75,原词为0.60. 4.将匹配类型与证据入库井在前端展示;另提供历史记录审计脚本和本地PYTEST回归样例,避免依赖真实AI调用.现 在开始修改这些后端契约,迁移,界面和测试. 编辑了文件 核心的AL契约已改为结构化输出,并把"原文逐字证据"设为硬要求.下一步把画像持久化,扩展查询调度和最终代码校 验接入监控任务;这样即使模型误判,缺少可验证证据的内容也不会入库. 编辑了文件 查询任务已调整为能保留"该候透由哪些查询命中"的信息,避免扩展检索后的重复条目丢失来源.接下来接入主循环, 并确保同一轮只生成一次画像,不会为每个来源重复调用AI. 已编辑 MONITOR.PY +39 -27 监控主循环现在会对每个关键词复用持久化画像,对原词加扩展词井行检索,再做两次证据门禁.还会把最终命中的 词,匹配类型和原文引文写入记录,前端可用于人工快速复 接着补齐展示,历史审计与测试. -->  <!-- 这是一张图片,ocr 内容为:监控主循环现在会对每个关键词复用持久化画像,对原词加扩展词并行检索,再做两次证据门禁.还会把最终命中的 词,匹配类型和原文引文写入记录,前端可用于人工快速复核.接看补齐展示,历史审计与测试. 编辑了文件 前端会在展开"AL判断依据"时同时显示原关键词或扩展词命中,实际命中的词,以及AL从原内容摘录的引文;文章插, 要仍保持机取到的原始元信息.现在补上不联网的回归测试,覆盖精确命中,扩展命中,泛AL误报和伤造引文这几类边 界. 编辑了文件 测试样例和历史审计脚本已加入.审计脚本款认只报告不修改数据,只有显式传,一-APPLY 才会将近期鼓少批准文字证 据的旧记录标记为不相关,且不删除数据.现在运行后端测试与前端构建,处理兼容性问题. 后筛测试只发现一处预期差异:AL输入现在放意包含标题加正文,才能让标题也作为可验证引文来源;这是新规则的一 部分,不是实现错误.将测试预期同步后继续执行完整验证. 已编辑 TEST ITEM METADATA.PY+1-1 验证通过:后端 17 PASSED.前端生产构建成功.最后进行代码审查和运行时导入检查,重点确认数据库迁移能平源 处理已有SQLITE,以及关键词画像缓存不会在采集时造成额外重复调用. 审查发现一个迁移函数的索引语可因插入位置落在了关键词迁移函数中,虽然当前初始化顺序仍能执行,但职责不正 确.将其移回热点表迁移函数,并再跑一次测试确认. 已编辑DATABASE.PY+9-9 .迁移职责已修正.为满足后续不依赖人工反复发现边界系例的目标,还会加入一个不接入CI的可选A1对抗样本生成 器,以及一份说明文档;日常PYTEST仍完全使用固定样例和MOCK,不消耗API调用. 编辑了文件 文档和可选AL对抗评估已补开,并已更新项目约定.接下来进行最终验证:测试,前端构建,PYTHON编译,以及临时 SQLITE初始化检查新字段是否能自动创建. -->  优化后效果展示 <!-- 这是一张图片,ocr 内容为:HOT LIST 值得立刻读的热点 发布 2026/08/30 17 17:50 推荐94 BING NEWS 抓取 2026/08/31 09:11 GEMINI 3.1 PRO-GOOGLE DEEPLMIND BEST FOR COMPLEX TASKS AND BRINGING CREATIVE CONCEPTS TO LIFE 发布者/媒体:DEEPMIND.GOOGLE AI判断依据 READ NOW -->  ## SKILLS 开发 ### 以下为提示词 ```markdown 你是一位专业的程序员,现在请你根据我的需求和方案、以及已经开发完成的前端和后端项目,在此基础上进行优化和功能扩展。 ## 本次需求 帮我把【热点监控工具】的能力封装为 Agent Skills,要求不影响现有项目的代码,只是额外新增一个单独的目录作为 Skills。 此外,你还可以有自己的想法,无论如何都要达到我的目标,并且找我人工确认,不要直接开始开发。并且要根据 /skill-creator 这个 skill 来给出方案 ``` ### 开发过程 ### 用户 > 你是一位专业的程序员,现在请你根据我的需求和方案、以及已经开发完成的前端和后端项目,在此基础上进行优化和功能扩展。 > > ## 本次需求 > 帮我把【热点监控工具】的能力封装为 Agent Skills,要求不影响现有项目的代码,只是额外新增一个单独的目录作为 Skills。 > > 此外,你还可以有自己的想法,无论如何都要达到我的目标,并且找我人工确认,不要直接开始开发 > ### 助理 > 初始方案是新增 `skills/ai-trending-monitor/`,与 `backend/`、`frontend/` 隔离,但通过现有 FastAPI 接口调用热点、关键词和通知能力。 > > 默认只读;修改关键词、触发采集、发送通知等动作需要人工确认。 > --- ### 2. 不依赖后端的约束 #### 用户 > 我不希望访问后端服务器。使用这个 Skill 的人不一定会启动这个项目后端。请直接把 Skill 写在这个文件夹,并重新给方案。 > #### 助理 > 方案调整为纯独立 Skill:只新增 `skills/` 内容,不访问 FastAPI、SQLite、定时任务或本地服务。 > > Skill 每次调用即时使用公开搜索/网页浏览采集信息,执行时效过滤、URL 去重、相关性审核、热点聚合和分享文案生成。 > > 关键规则: > > + 不访问 `http://localhost:8000`、`http://127.0.0.1:8000` 或 `/api/v1/*`。 > + 不读取、修改或提交项目的 `backend/`、`frontend/`、`.env` 与数据库文件。 > + 只输出真实原文 URL;无发布时间、无直接证据或无法核验的内容降级或排除。 > + 微博只在用户明确授权并提供当次 `WEIBO_COOKIE` 时查询,Cookie 不写入仓库或输出。 > + 默认最近 7 天;原词直接命中阈值 `0.60`,批准扩展词命中阈值 `0.75`。 > #### 用户 > 可以的,按照这个方案开发吧。 > --- ### 3. 初版独立 Skill #### 助理 > 已创建独立 Skill 文档,不修改前后端: > > 初版包含各来源策略、时效与去重规则、逐字证据要求、输出结构、分享模板和降级处理。 > ```latex skills/ai-trending-monitor/ ├── SKILL.md ├── examples/ └── references/ ``` --- ### 4. 补齐 skill-creator 流程 #### 用户 > 你没有用 `skill-creator` 这个技能吗? > #### 助理 > 没有。前一轮只完成了 Skill 草稿,没有执行 `skill-creator` 的完整闭环:缺少 `evals/evals.json`、带 Skill / 无 Skill 对照、评分、benchmark、审阅页和反馈迭代。 > > 建议补 3 个评测: > > 1. 最近 7 天 AI Agent 关键词热点监控。 > 2. 最近 24 小时 AI 编程热点微信群简报。 > 3. AI 模型发布在 Hacker News、新闻和微博中的多来源对比。 > #### 用户 > 可以。还可以观察后端写一些脚本辅助获取信息,不要纯粹靠 Markdown,用 `skill-creator`。 > #### 助理 > 会从后端提炼已验证的公开采集策略,但脚本只放在 Skill 目录,不导入项目后端、不调用本地 API。 > > Markdown 负责决策与审核规则;脚本负责可复现的采集、时间解析、URL 规范化、去重和 JSON 输出。 > --- ### 5. 新增独立采集脚本 #### 助理 > 已新增: > > 脚本仅依赖 Python 标准库,支持: > > + Hacker News、Google News RSS、GitHub、Bing、百度新闻、搜狗微信。 > + 经明确授权的微博移动端候选采集。 > + 标题、URL、来源、发布时间、摘要和互动指标规范化。 > + 常见追踪参数清理、URL 去重、时间窗口过滤。 > + 统一 JSON 输出:`scan`、`source_status`、`items`、`limitations`。 > + 固定输出 `backend_used: false`,用于证明未调用项目后端。 > > 示例: > ```latex skills/ai-trending-monitor/scripts/collect_hotspots.py ``` ```bash python3 scripts/collect_hotspots.py --keyword "AI Agent" --limit 10 --pretty ``` #### 助理 > 冒烟测试通过:Google News 成功返回候选;Hacker News 当时不可用但被标记为 `unavailable`,没有阻塞扫描;JSON 中 `backend_used` 为 `false`。 > --- ### 6. 发现并修复来源范围问题 #### 助理 > 评测发现文档与脚本不一致:文档说关键词扫描覆盖全部来源,但脚本默认仅扫描 Hacker News 和 Google News。 > > 已修复。关键词扫描现在默认尝试以下 7 个来源,并在 `source_status` 中透明记录成功、失败、限流或未授权状态: > ```latex hackernews, google_news, github, bing, baidu_news, sogou_weixin, weibo ``` --- ### 7. 第一轮 skill-creator 评测 #### 助理 > 已新增: > > 每个任务都运行两组: > > + `with_skill`:读取并遵循 `ai-trending-monitor` Skill。 > + `without_skill`:不读取、不使用该 Skill。 > > 两组均禁止访问项目后端、前端、数据库和本地 API。 > ```latex skills/ai-trending-monitor/evals/evals.json ``` #### 助理 > **评测 1:AI Agent 热点监控** > > 带 Skill 会先运行采集脚本,再打开原文核验。Hacker News 失败、GitHub `429` 限流、Bing 缺失可解析时间等情况均被明确记录;最终仅保留带真实 URL、日期、逐字证据、匹配类型和置信度的条目。 > > 无 Skill 基线也生成了候选,但没有同等明确的“每个声明来源是否实际参与”的来源状态契约。 > #### 助理 > **评测 2:24 小时 AI 编程简报** > > 带 Skill 在严格的“真实 URL + 24 小时发布时间 + 直接文字证据”条件下没有发现合格热点,因此透明返回空结果,并报告 GitHub 限流、Google News 失败、微博未授权等限制,而不是用弱候选凑数量。 > #### 助理 > **评测 3:模型发布多来源对比** > > 带 Skill 选择 `GLM-5.3-Flash`,明确分为多来源确认事实、单一来源信息和社区推测;性能、价格和替代能力等内容未被写成已证实事实。微博未授权时标记为未核验。 > --- ### 8. 自动评分、Benchmark 与审阅页 #### 助理 > 已新增评分脚本: > > 它检查时间窗口、来源状态、原文 URL、发布时间、逐字证据、匹配类型、置信度、来源分层及微博未授权处理。 > ```latex skills/ai-trending-monitor-workspace/iteration-1/benchmark-runs/grade_iteration.py ``` #### 助理 > 评分器第一次只识别中文字段,误判了使用 `Source Status`、`Published`、`Verbatim evidence` 的带 Skill 英文输出。已修正为中英文等价字段匹配后重新评分。 > > 默认 `python3` 是 Python 3.7,而 `skill-creator` 聚合器需要 Python 3.9+,因此使用 `/opt/homebrew/bin/python3.10` 聚合 benchmark,没有修改 `skill-creator` 自身文件。 > #### 助理 > 第一轮 benchmark: > > 这个分数只衡量本轮的可审计性、安全披露和结构化输出,不代表所有实时事实均被自动验证。每个配置仅运行 1 次,且运行耗时没有持久化,`0.0s` 不能作为性能结论。 > ```latex With Skill: 100.0% Without Skill: 83.3% Delta: +0.17 ``` #### 助理 > 已使用 `skill-creator` 提供的 `eval-viewer/generate_review.py` 生成静态审阅页: > > 页面包含 3 个任务的带 Skill / 无 Skill 报告、评分结果和 benchmark。 > ```latex skills/ai-trending-monitor-workspace/iteration-1/review.html ``` --- ### 9. 当前状态 #### 助理 > 当前产物: > > Skill 初版、独立采集脚本和第一轮 `skill-creator` 对照评测已完成。尚未收到最终人工评测反馈,也尚未打包为 `.skill` 文件。 > ```latex skills/ai-trending-monitor/ ├── SKILL.md ├── evals/evals.json ├── examples/ ├── references/ └── scripts/collect_hotspots.py skills/ai-trending-monitor-workspace/iteration-1/ ├── benchmark.json ├── benchmark.md ├── review.html └── benchmark-runs/grade_iteration.py ``` #### 助理建议 > 下一步: > > 1. 审阅 `review.html` 中的对照输出。 > 2. 根据反馈修改 `SKILL.md`、来源策略、脚本或分享模板。 > 3. 第二轮加入固定网页快照、受控 fixture 或 URL/日期重抓检查,增强事实质量评测。 > 4. 人工确认满意后,再打包为可分发的 `.skill` 文件。 > # 可能遇到的坑 ### 手动提供API文档 如果AI 获取的api 文档不对,过时,可以手动投喂,发送api 网址 ### 避免套娃优化 修复问题A ->引入问题 B ->修复问题 B->问题 A 回来了 原因是 1. 每次质管局当前问题没有全局视角 2. 修复师改动了之前的关键逻辑 3. 需求本身存在矛盾,(既要信息丰富,又要信息质量高) 解决方法 + 设定明确的优先级 (质量>数量) + 让 A`··I 在修改前先完整理解当前代码逻辑 + 如果3 次修复还不能解决,考虑新开上下文,或者回滚代码 ## Codex 权限配置速记,代码与 Git 权限 Codex 默认沙箱模式,可以通过 workspace-write 修改项目代码,但 .git/ 是受保护目录,未单独授权时无法执行 git add、git commit 或 git push。这是为了避免代理在未确认时改写提交记录、分支和远端配置。所以编辑 ~/.codex/config.toml: ```toml [sandbox_workspace_write] network_access = true writable_roots = ["/Users/kawaiwong/projects/ai_trending_tool/.git"] ``` 添加这段,保存后重新开启 Codex 会话生效。该配置只授权当前项目及其 .git,无需让沙箱使用 danger-full- access。但普通 Git 命令不一定会每次都弹出权限确认。因此真正控制“何时提交”的规则应是:只有你明确说“commit”“commit + push”时,我才执行提交或推送。这也是当前协作中最顺手的方式。 # 项目地址 https://github.com/ansonwong9695/ai_trending_tool
GitHub 每周精选|2026 W25
GitHub 上每天都会冒出很多新项目。 大多数我都会看过就忘。 有些看起来很酷,但装完就吃灰。 还有一些,会让我真的想留下来继续折腾。 我想把这些项目记录下来。 不追求“最火”。 只记录那些: 让我真正想装下来试试的东西。 --- ### 1. 人味 skill 项目名:renwei-writing GitHub 仓库地址: https://github.com/orange2ai/renwei-writing **这是继 web-access 之后,我基本上天天会使用的 skill,目前还不到 1k 的 star,暂时算是不温不火的状态** 从这个仓库名称也基本可以猜到这个仓库的作用到底是什么了,没错就是输出的时候更有人味 这里我没有单独去做一个用和不用这个 skill 输出的文本的实验了,因为自从用了这个 skill 之后,就基本没有在创作的时候不用这个 skill 了 如果你是一名创作者的话,这个 skill 大抵会让你爱不释手的 **虽然这个 skill 的效果确实很不错,但对于输出的内容并不能做到真正的全部使用,还是需要人的创作指导的,要不人味依然不会很高** ### 2. andrej-karpathy-skills 项目名:andrej-karpathy-skills GitHub 仓库地址: https://github.com/multica-ai/andrej-karpathy-skills Andrej Karpathy 在 26 年的 1 月发了一条推特,来聊了聊过去几周大量使用Claude编程的一些零散想法,**有 770 万次浏览量**,推特链接如下: https://x.com/karpathy/status/2015883857489522876 这里也简单介绍一下 Andrej Karpathy 的背景 Andrej Karpathy 是 AI 研究者与工程实践者,**OpenAI 创始团队成员之一**,后担任 Tesla Autopilot 视觉方向负责人 --- 在这条推特当中,Andrej Karpathy 聊到了现在 AI 智能体在编码时的一些问题,这里我还是觉得直接放原文会好一些,相信这也是大家在用 AI 智能体编码时多多少少会遇到的一个问题  为了解决上面的问题,就有这个仓库,ndrej-karpathy-skills 做的事情,就是把以上问题压缩成 4 条规则(**以下不是完整的 skill 内容**): 1. 编码前先思考:不要默默假设,有歧义就说出来 2. 简洁优先:能 50 行解决,就不要写成 200 行 3. 精准修改:只动和当前任务有关的地方,不顺手重构 4. 目标驱动执行:不要只说“修一下”,而是定义可验证的成功标准 优先是很轻,可以直接将这个 skill 安装到 AI Agent 当中,或者直接写进 CLAUDE.md 或者 AGENTS.md 都是可以的,可以一定程度上解决上面的问题 **缺点也是比较明显的,它不是强约束**,它不会像类型系统、测试、lint 那样硬性拦住错误,能减少犯错的概率,但并不能杜绝错误的发生 比如关于 "编码前先思考" 这点,用 superpower 的效果会更好 --- 至于使用人群的话,如果你打算用 AI 认真写代码,那么值得一试,它做了一件很朴素的事情:**AI coding 的下一步,不只是让模型更会写代码,也要让模型少乱写代码**  ### 3. guizang-social-card-skill 项目名:guizang-social-card-skill GitHub 仓库地址: https://github.com/op7418/guizang-social-card-skill 藏师傅的新作品,之前也有推荐过藏师傅的 PPT skill,感兴趣的话可以点击下面的链接去看一下 https://zhuanlan.zhihu.com/p/2040526006285509057 优点有如下几个: 第一:延续上次 guizang-ppt-skill 的两种风格,审美起点更高 不是让你从零调字体、颜色、间距,而是先给你一套有约束的视觉语言。这个约束反而是好事,因为大多数内容图做丑,不是因为自由不够,而是因为自由太多 第二:适合长文拆图 说成大白话就是为文章配图,将一片文章拆成 5 到 9 张小红书卡片,它能从结构、标题、重点句、截图排布这些地方一起处理,不只是做一张封面 第三:修改成本低 最初的产物是单文件 HTML,再用 Playwright 渲染成 PNG。HTML 和 CSS 都能继续改,出问题也能查,不像很多在线设计工具,最后只剩一个不可控的导出结果 当然我也需要说一说局限性,原配的 skill 主要是生成小红书和公众号内容的,这两个平台的图片比例为 3:4 和 21:9,**对于 4:3 和 16:9 比例的支持稍微差一些**,我第一次在生成 16:9 的配图时出现了配图模糊的情况,后续在原配的基础上进行一些改进,顺利的解决了这个问题,这一点有必要告诉大家  ### 4. agent-skills 项目名:agent-skills GitHub 仓库地址: https://github.com/addyosmani/agent-skills 区别于很多 "角色大全" 式的 skill 合集,产品、运营、设计、销售、法务、数据分析都来一点,看起来很全 agent-skills 的重心收得很窄,基本围绕软件开发这条线展开:**从需求澄清、写规格、拆任务,到编码、测试、调试、代码审查、安全、性能、CI/CD、发布、监控和迁移废弃** 所以它更像是把一个资深工程团队的日常习惯拆开,写成 AI coding agent 可以照着执行的工作流 里面不只是“你是一个前端工程师”这种角色设定,还会告诉agent:什么时候该写 spec,什么时候该停下来补测试,什么时候该做安全检查,什么时候该考虑回滚和可观测性等等  ### 5. whisper 项目名:whisper GitHub 仓库地址: https://github.com/openai/whisper 如果单说功能的话,这个仓库的功能是极其简单的: 将视频 / 音频转换成文字稿 而且这个文字稿也不是完美的。**它不会顺手帮你清理语气词,不会自动帮你删除重复表达,对一些专业名词、人名、品牌名的识别也不总是稳定。**你如果拿它的结果直接发出去,往往还是要自己再校对一遍 对于做字幕,没有剪映方便 对于视频会议的转写也没有腾讯会议、飞书会议方便 对于只是偶尔转一段采访或者播客,现在市面上也有很多现成工具能做,比如 TurboScribe、Riverside、VEED、Otter、Notta,中文场景里还有飞书妙记、通义听悟这类产品,很多都比它更省事 --- 那我为什么还想要来推荐这个仓库呢? 第一点是,**它足够便宜**,准确点说,是几乎没有使用门槛上的持续成本 很多在线转写产品表面上能免费试,但真正想长期用,要么限制分钟数,要么限制文件大小,要么导出字幕和全文稿时开始收费 Whisper 不一样。环境装好、模型下载好之后,它就是一个可以一直放在你电脑上的本地工具。你不用反复算时长,也不用担心哪天平台把免费额度收紧 第二点是,**它是本地可控的** 你的视频、录音、采访、会议材料,不需要上传到第三方网站。这个差别平时不明显,但一旦素材涉及客户、内部沟通、未发布内容、个人隐私,你就会知道“本地处理”这四个字有多值钱。很多产品更方便,但方便的代价就是文件先出去;Whisper 不是。 第三点是,它虽然简单,但它简单得很像一个基座 很多成品工具解决的是“给你一个结果”,Whisper 解决的是“把音频转文字这一步,变成你自己手里的一项能力” 你可以拿它输出 .txt、.srt、.vtt、.json,然后继续接自己的工作流:字幕、归档、摘要、检索、内容拆条、AI 总结,后面怎么接都行 这也是它和剪映、飞书会议、腾讯会议这类工具最大的差异点。那些工具是成品,目标是让普通用户少折腾;Whisper 是底层能力,目标是让你自己决定后面怎么用 它的优点说白了就三个:免费、本地、通用 它的缺点也很明确:不够傻瓜、不够省心、结果不够干净、后处理要靠自己 --- 所以它并不是一个适合所有人的仓库 如果你只是想偶尔给视频加字幕,剪映更合适 如果你主要是开会并且想自动生成纪要,腾讯会议、飞书会议更合适。 如果你不想碰命令行,也不想自己管模型和环境,那各种在线转写网站也更合适 --- 但如果你属于下面这几类人,Whisper 就很值得看一眼: 你经常要处理录音、播客、口播、采访、课程、会议素材; 你在意隐私,不想把文件上传到第三方平台; 你想把“音频转文字”这一步沉淀成一个长期可用的本地能力; 或者你是开发者,后面还想接字幕、摘要、检索、自动化流程 对这些人来说,Whisper 的价值不在于它做得比所有产品都更好,而在于它把最基础、也最关键的一步,稳定地交回到了你自己手里。 如果要给它一句比较准确的定位,我会更愿意这么说: **Whisper 不是最好用的视频转文字产品,但它是很值得拥有的本地转写底座**  --- 最后: 后面肯定还会继续遇到: 让我真正想装下来试试的项目。 这个系列也会继续更新下去。
易扣AI (Go + CloudWeGo) 企业级AI智能体项目教程 第5章:后端项目基于Eino对话记忆的对话历史模块搭建
## 一、方案设计 ### 业务需求描述 在集成Eino对话记忆之前,我们的代码生成智能体存在以下核心问题: ##### 问题1:对话无持久化 **现状:** ```go // 现有智能体的Generate方法 - 无状态设计 func (a *BaseAgent) Generate(ctx context.Context, userMessage string, chatTemplate prompt.ChatTemplate, adkAgent *adk.ChatModelAgent) (*schema.Message, error) { // 直接格式化Prompt,没有任何历史上下文 format, err := chatTemplate.Format(ctx, map[string]any{ "content": userMessage, // 只有当前消息,没有history! }) // ... } ``` **用户体验:** - 每次都要重新描述需求 - AI无法理解"它"、"这个"、"那个"等指代词 - 对话不连贯,体验极差 ##### 问题2:无法追溯对话历史 **现状:** - 智能体运行时内存中保存对话 - 服务重启后所有对话丢失 - 无法查询历史对话记录 - 无法回溯用户的完整需求变更过程 **业务影响:** - 用户无法回顾之前的对话内容 - 开发者无法调试AI生成的问题 - 无法进行数据分析(如用户常用功能统计) - 不符合合规性要求(需要保留操作日志) ##### 问题3:无多对话隔离 **现状:** 单个智能体处理多个应用对话 **安全风险:** - 应用A的用户可能看到应用B的对话 - 不同应用的对话历史混在一起 - 数据泄露风险高 - 无法按应用维度管理数据 ##### 问题4:无自动总结机制 **现状:** - 长对话导致Token消耗指数增长 - 20轮对话后,Prompt可能超过模型上下文窗口 - AI响应质量下降(注意力分散) - API调用成本急剧上升 **成本估算示例:** ``` 假设每条消息平均100 tokens: - 第1轮:200 tokens (用户+AI) - 第10轮:2000 tokens - 第20轮:4000 tokens - 第50轮:10000 tokens (超出许多模型的限制) API成本增长曲线:线性 → 指数级增长 ``` ### 对话历史分页方案选型:传统分页 vs 游标分页 在对话历史模块中,我们同时使用了两种分页方式:管理员接口使用**传统分页**,用户接口使用**游标分页**。为什么要这样设计?下面通过一个真实的案例来说明。 #### 一个真实的场景 假设你的应用"任务管理系统"已经和AI进行了 **50轮对话**,产生了 **100条消息记录**。用户打开对话历史页面,每页显示10条。 #### 传统分页的做法 传统分页的思路很简单:告诉数据库"我要第3页,每页10条"。 ``` 请求:GET /api/chat/history?appId=123&pageNum=3&pageSize=10 ``` 数据库执行的SQL: ```sql SELECT * FROM chat_history WHERE app_id = 123 ORDER BY create_time DESC LIMIT 10 OFFSET 20; ``` 翻译成白话就是:"跳过前20条,取接下来的10条"。 **看起来没问题?让我们看看会发生什么。** 用户正在浏览第3页时,另一条新的AI消息到达了,插入到了最新位置。此时数据变成了101条,最新的一条被推到了第1页的顶部。 用户点击"下一页"想看第4页: ```sql SELECT * FROM chat_history WHERE app_id = 123 ORDER BY create_time DESC LIMIT 10 OFFSET 30; ``` **问题出现了**——用户看到了第3页最后一条消息的重复!因为新插入的消息把所有记录往下挤了一位,OFFSET 30实际上跳过了一条本该看到的消息,而把第3页末尾的那条又展示了一次。 ``` 插入前: 插入后(新消息挤入第1页): 第1页:Msg100, Msg99... 第1页:Msg101, Msg100, Msg99... 第2页:Msg90, Msg89... 第2页:Msg91, Msg90, Msg89... 第3页:Msg80, Msg79... 第3页:Msg81, Msg80, Msg79... ← Msg81是新挤进来的 第4页:Msg70, Msg69... 第4页:Msg71, Msg70, Msg69... ← 用户看到的第4页,Msg71重复了! ``` 这就是传统分页的**数据漂移问题**——在有新数据插入时,页与页之间会出现重复或遗漏。 **另一个问题:性能** 当数据量很大时,OFFSET的代价很高: ```sql -- 查看第1000页,每页10条 SELECT * FROM chat_history ORDER BY create_time DESC LIMIT 10 OFFSET 9990; ``` 数据库并不是直接跳到第9990条,而是先扫描前9990条记录,然后丢弃它们,再返回接下来的10条。也就是说,**翻到越后面的页,查询越慢**。 ``` 第1页: 扫描 0 条 → 耗时 1ms 第10页: 扫描 90 条 → 耗时 3ms 第100页:扫描 990条 → 耗时 15ms 第1000页:扫描9990条 → 耗时 150ms ``` #### 游标分页的做法 游标分页的思路完全不同:不告诉数据库"我要第几页",而是告诉它"我要在某个位置之后的数据"。 ``` 第一次请求:GET /api/chat/history?appId=123&pageSize=10 (没有游标,从头开始取) 返回结果: Msg100 (createTime: 2025-01-10 10:30:00) Msg99 (createTime: 2025-01-10 10:28:00) ... Msg91 (createTime: 2025-01-10 10:10:00) 游标标记:lastCreateTime = 2025-01-10 10:10:00 ``` 用户向下滚动,加载更多: ``` 第二次请求:GET /api/chat/history?appId=123&pageSize=10&lastCreateTime=2025-01-10 10:10:00 (告诉数据库:从这条之后继续取) ``` 数据库执行的SQL: ```sql SELECT * FROM chat_history WHERE app_id = 123 AND create_time < '2025-01-10 10:10:00' ORDER BY create_time DESC LIMIT 10; ``` 翻译成白话就是:"给我比这个时间更早的10条"。 **关键区别来了**——即使此时有新消息插入,也不会影响结果。因为我们不是在说"跳过多少条",而是在说"从这个时间点之前取"。新消息的时间一定比游标更新,不会出现在结果中。 ``` 插入前和插入后的查询结果完全一致: 第二次请求返回: Msg90 (createTime: 2025-01-10 10:08:00) Msg89 (createTime: 2025-01-10 10:06:00) ... Msg81 (createTime: 2025-01-10 09:50:00) 不会出现重复,不会出现遗漏! ``` **性能方面**——游标分页利用了索引,无论翻到多深,查询速度都一样快: ```sql -- 第1次查询和第100次查询的执行计划完全相同 -- 都是利用 create_time 索引定位,然后向后扫描10条 -- 耗时始终在 1-2ms ``` ``` 第1次加载: 利用索引定位 → 耗时 1ms 第10次加载:利用索引定位 → 耗时 1ms 第100次加载:利用索引定位 → 耗时 1ms 第1000次加载:利用索引定位 → 耗时 1ms ``` #### 那为什么管理员接口还用传统分页? 游标分页虽然好,但也有它的局限: **局限1:无法跳页** 游标分页只能"下一页",不能直接跳到第5页。用户必须从第1页开始,一页一页往下翻。 ``` 传统分页:可以直接跳到第50页 → GET /api/admin/chat/history?pageNum=50 游标分页:必须从第1页开始,连续翻50次 → 不现实 ``` **局限2:无法显示总页数** 游标分页不知道总共有多少数据,所以无法显示"共100页"这样的信息。 ``` 传统分页:可以显示 "第3页/共100页" 游标分页:只能显示 "加载更多" 或 "没有更多了" ``` **局限3:排序字段必须唯一且递增** 游标分页依赖一个稳定的、单调递增的字段作为游标。如果排序字段有重复值,可能会漏数据。 ``` 用 createTime 做游标: 如果两条消息的 createTime 完全相同(精度到秒) → 可能会漏掉其中一条 → 解决方案:用 (createTime, id) 联合游标 ``` #### 我们的选择 根据两种分页的特点,我们这样分配: **用户查看对话历史 → 游标分页** 用户的场景是"向下滚动加载更多",不需要跳页,不需要总页数。对话是实时产生的,用游标分页可以避免数据漂移,保证体验流畅。 ``` 前端交互: 打开对话历史 → 加载最新10条 向下滚动 → 基于最后一条的时间加载更多 继续滚动 → 继续加载... 没有更多了 → 显示"已加载全部" ``` **管理员查看所有对话 → 传统分页** 管理员的场景是"后台管理",需要跳转到指定页码,需要看到总记录数,需要按多种条件筛选。数据变动对管理员来说影响不大。 ``` 前端交互: 打开管理后台 → 显示第1页,共50页 点击第5页 → 直接跳转 输入页码25 → 直接跳转 筛选条件变更 → 重新从第1页开始 ``` ### 数据库表设计 **对话历史表(chat_history)** **表结构:** | 字段名 | 类型 | 说明 | 约束 | | ----------- | ----------- | ------------------- | ----------------------------------- | | id | bigint | 主键ID | PRIMARY KEY, AUTO_INCREMENT | | message | text | 消息内容 | NOT NULL | | messageType | varchar(32) | 消息类型(user/ai) | NOT NULL | | appId | bigint | 应用ID | NOT NULL, INDEX | | userId | bigint | 用户ID | NOT NULL, INDEX | | turnNumber | int | 对话轮数 | NOT NULL, DEFAULT 1 | | createTime | datetime | 创建时间 | NOT NULL, DEFAULT CURRENT_TIMESTAMP | | updateTime | datetime | 更新时间 | NOT NULL, DEFAULT CURRENT_TIMESTAMP | | isDelete | tinyint | 是否删除 | NOT NULL, DEFAULT 0 | **索引设计:** - 主键索引:id - 联合索引:(appId, userId, turnNumber) - 普通索引:createTime **建表语句:** ```sql -- 对话历史表 create table if not exists chat_history ( id bigint auto_increment comment 'id' primary key, message text not null comment '消息内容', messageType varchar(32) not null comment '消息类型:user/ai', appId bigint not null comment '应用ID', userId bigint not null comment '用户ID', turnNumber int default 1 not null comment '对话轮数', createTime datetime default CURRENT_TIMESTAMP not null comment '创建时间', updateTime datetime default CURRENT_TIMESTAMP not null on update CURRENT_TIMESTAMP comment '更新时间', isDelete tinyint default 0 not null comment '是否删除', INDEX idx_appId_userId (appId, userId), INDEX idx_turnNumber (turnNumber), INDEX idx_createTime (createTime) ) comment '对话历史' collate = utf8mb4_unicode_ci; ``` ## 二、对话历史接口开发 本节我将详细讲解对话历史模块的Service接口定义和Logic层实现,包括对话历史的增删改查、轮次管理、自动总结等核心功能。 ### Service 接口定义 **文件位置:** `internal/service/chat_history_service.go` **接口设计:** ```go type IChatHistoryService interface { AddChatMessage(ctx context.Context, appId int64, message string, messageType enum.ChatHistoryMessageTypeEnum, userId int64) error DeleteByAppId(ctx context.Context, appId int64) error ListAppChatHistoryByPage(ctx context.Context, appId int64, pageSize int32, lastCreateTime time.Time, loginUser *vo.UserVo) (*response.PageResponse[*model.ChatHistory], error) ListAllChatHistoryByPageForAdmin(ctx context.Context, pageNum int32, pageSize int32, queryRequest *api.YiKouChatHistoryQueryRequest) (*response.PageResponse[*model.ChatHistory], error) } ``` ### Logic 层实现 **文件位置:** `internal/logic/chat_history_logic.go` #### 服务初始化 ```go func NewChatHistoryService(db *gorm.DB) *ChatHistoryService { return &ChatHistoryService{ db: db, } } type ChatHistoryService struct { db *gorm.DB } ``` #### 分页查询应用对话历史(ListAppChatHistoryByPage) **功能说明:** 分页获取指定应用的对话历史记录,支持游标分页和时间过滤。 **完整代码:** ```go func (s *ChatHistoryService) ListAppChatHistoryByPage(ctx context.Context, appId int64, pageSize int32, lastCreateTime time.Time, loginUser *vo.UserVo) (*response.PageResponse[*model.ChatHistory], error) { // 1. 校验基本参数 if appId == 0 || appId < 0 || pageSize <= 0 || pageSize > 50 { return nil, errorutil.ParamsError } if loginUser == nil { return nil, errorutil.NotLoginError } // 2. 校验用户角色是否为管理员或者应用创建者 app, err := query.Use(s.db).App.Where(query.App.ID.Eq(appId)).First() if err != nil { return nil, err } if app.UserID != loginUser.ID && loginUser.UserRole != string(enum.AdminRole) { return nil, errorutil.NotAuthError } // 3. 构建查询条件 chatHistoryQuery := query.Use(s.db).ChatHistory. Where(query.ChatHistory.AppID.Eq(appId)). Where(query.ChatHistory.MessageType.Neq(string(enum.SummaryMessageType))) // 4. 处理时间过滤(游标分页) if !lastCreateTime.IsZero() { chatHistoryQuery = chatHistoryQuery.Where(query.ChatHistory.CreateTime.Lt(lastCreateTime)) } // 5. 查询总记录数 totalRow, err := chatHistoryQuery.Count() if err != nil { return nil, err } // 6. 计算总页数 totalPage := 0 if totalRow > 0 { totalPage = int((totalRow + int64(pageSize) - 1) / int64(pageSize)) } // 7. 分页查询应用的聊天记录 chatHistoryList, err := chatHistoryQuery. Order(query.ChatHistory.CreateTime.Desc()). Limit(int(pageSize)). Find() if err != nil { return nil, err } // 8. 构建并返回分页响应 return &response.PageResponse[*model.ChatHistory]{ Records: chatHistoryList, PageNum: 1, PageSize: int(pageSize), TotalPage: totalPage, TotalRow: int(totalRow), OptimizeCountQuery: true, }, nil } ``` #### 删除应用对话历史(DeleteByAppId) **功能说明:** 删除指定应用的所有对话记录,通常在删除应用时调用。 **完整代码:** ```go func (s *ChatHistoryService) DeleteByAppId(ctx context.Context, appId int64) error { // 1. 校验应用ID if appId == 0 || appId < 0 { return errorutil.ParamsError.WithMessage("应用ID不能为空") } // 2. 删除该应用的所有对话记录 _, err := query.Use(s.db).ChatHistory. Where(query.ChatHistory.AppID.Eq(appId)). Delete() if err != nil { return err } return nil } ``` #### 添加对话消息(AddChatMessage)⭐核心方法 **功能说明:** 添加一条对话消息到数据库,自动计算对话轮次,并在达到阈值时触发对话总结。 **完整代码:** ```go func (s *ChatHistoryService) AddChatMessage(ctx context.Context, appId int64, message string, messageType enum.ChatHistoryMessageTypeEnum, userId int64) error { // 1. 校验参数 if appId <= 0 || messageType == "" || userId <= 0 || message == "" { return errorutil.ParamsError } // 2. 获取上一条消息的轮次 lastMessage, err := query.Use(s.db).ChatHistory. Where(query.ChatHistory.AppID.Eq(appId)). Order(query.ChatHistory.CreateTime.Desc()). First() var turnNumber int32 if err != nil { turnNumber = 0 // 第一条消息,轮次为0 } else { turnNumber = lastMessage.TurnNumber } // 3. 如果当前是用户消息,开启新的一轮 if messageType == enum.UserMessageType { turnNumber += 1 } // 4. 生成雪花算法ID chatMessageId, err := snowflake.GenerateSnowFlakeId() if err != nil { return err } // 5. 创建对话记录 err = query.Use(s.db).ChatHistory.Create(&model.ChatHistory{ ID: chatMessageId, AppID: appId, Message: message, MessageType: string(messageType), UserID: userId, TurnNumber: turnNumber, }) if err != nil { return err } // 6. 当对话轮次达到20轮且为AI消息时,异步生成总结 if turnNumber >= 20 && messageType == enum.AIMessageType { go s.generateSummary(context.Background(), appId, userId) } return nil } ``` **步骤详解:** | 步骤 | 操作 | 说明 | | ---- | ---------- | ---------------------- | | 1 | 参数校验 | 验证所有必填参数 | | 2 | 查询轮次 | 获取上一条消息的轮次数 | | 3 | 计算新轮次 | 用户消息则轮次+1 | | 4 | 生成ID | 使用雪花算法生成唯一ID | | 5 | 保存记录 | 写入数据库 | | 6 | 触发总结 | 达到阈值后异步生成总结 | **对话轮次计算规则:** ``` 示例对话流程: 轮次1: - 用户消息(turnNumber=1) - AI响应(turnNumber=1) 轮次2: - 用户消息(turnNumber=2) - AI响应(turnNumber=2) 轮次3: - 用户消息(turnNumber=3) - AI响应(turnNumber=3) ... ``` #### 生成对话总结(generateSummary)⭐高级功能 **功能说明:** 当对话达到一定轮次时,异步生成对话总结,用于优化长对话的上下文管理。 **完整代码:** ```go // generateSummary 生成对话总结 func (s *ChatHistoryService) generateSummary(ctx context.Context, appId int64, userId int64) { // 1. 获取历史对话记录(按时间正序) historyList, err := query.Use(s.db).ChatHistory. Where(query.ChatHistory.AppID.Eq(appId)). Order(query.ChatHistory.CreateTime.Asc()). Find() if err != nil { logger.Errorf("获取历史对话失败: %v\n", err) return } // 2. 构建对话历史字符串 var chatHistoryBuilder strings.Builder for _, history := range historyList { if history.MessageType == string(enum.UserMessageType) { chatHistoryBuilder.WriteString(fmt.Sprintf("用户: %s\n", history.Message)) } else if history.MessageType == string(enum.AIMessageType) { chatHistoryBuilder.WriteString(fmt.Sprintf("AI: %s\n", history.Message)) } } err = s.AddChatMessage(ctx, appId, chatHistoryBuilder.String(), enum.SummaryMessageType, userId) if err != nil { logger.Errorf("对话总结保存失败: %v\n", err) } } ``` **对话格式化示例:** ``` 输入:数据库中的对话记录列表 输出格式化的对话字符串: 用户: 我需要一个任务管理系统 AI: 好的,我来帮你创建一个任务管理系统。这个系统将包括任务的增删改查功能... 用户: 需要支持优先级设置 AI: 明白,我会添加优先级字段,支持高、中、低三个级别... 用户: 还要有截止日期提醒 AI: 没问题,我会集成日期选择器和提醒功能... ``` 在后续我们会自定义一个对话总结智能体用于总结所有轮次的对话,实现真正意义上的节省token #### 管理员分页查询所有对话历史(ListAllChatHistoryByPageForAdmin) **功能说明:** 管理员专用的全量对话历史查询接口,支持多条件组合查询。 **完整代码:** ```go func (s *ChatHistoryService) ListAllChatHistoryByPageForAdmin(ctx context.Context, pageNum int32, pageSize int32, queryRequest *api.YiKouChatHistoryQueryRequest) (*response.PageResponse[*model.ChatHistory], error) { // 1. 校验基本参数 if pageNum <= 0 || pageSize <= 0 || pageSize > 50 { return nil, errorutil.ParamsError } if queryRequest == nil { return nil, errorutil.ParamsError } // 2. 构建基础查询 chatHistoryQuery := query.Use(s.db).ChatHistory. Where(query.ChatHistory.ID.IsNotNull()) // 3. 动态添加查询条件 if queryRequest.Id > 0 { chatHistoryQuery = chatHistoryQuery.Where(query.ChatHistory.ID.Eq(queryRequest.Id)) } if queryRequest.AppId > 0 { chatHistoryQuery = chatHistoryQuery.Where(query.ChatHistory.AppID.Eq(queryRequest.AppId)) } if queryRequest.UserId > 0 { chatHistoryQuery = chatHistoryQuery.Where(query.ChatHistory.UserID.Eq(queryRequest.UserId)) } if queryRequest.MessageType != "" { chatHistoryQuery = chatHistoryQuery.Where(query.ChatHistory.MessageType.Eq(queryRequest.MessageType)) } if queryRequest.Message != "" { chatHistoryQuery = chatHistoryQuery.Where( query.ChatHistory.Message.Like("%" + queryRequest.Message + "%") ) } if !queryRequest.LastCreateTime.IsZero() { chatHistoryQuery = chatHistoryQuery.Where( query.ChatHistory.CreateTime.Lt(queryRequest.LastCreateTime) ) } // 4. 查询总记录数 totalRow, err := chatHistoryQuery.Count() if err != nil { return nil, err } // 5. 计算总页数 totalPage := 0 if totalRow > 0 { totalPage = int((totalRow + int64(pageSize) - 1) / int64(pageSize)) } // 6. 计算偏移量 offset := int((pageNum - 1) * pageSize) // 7. 执行分页查询 chatHistoryList, err := chatHistoryQuery. Order(query.ChatHistory.CreateTime.Desc()). Limit(int(pageSize)). Offset(offset). Find() if err != nil { return nil, err } // 8. 构建并返回分页响应 return &response.PageResponse[*model.ChatHistory]{ Records: chatHistoryList, PageNum: int(pageNum), PageSize: int(pageSize), TotalPage: totalPage, TotalRow: int(totalRow), OptimizeCountQuery: true, }, nil } ``` ### Handler 层实现 **文件位置:** `internal/handler/chat_history_handler.go` #### Handler 结构体定义 ```go type ChatHistoryHandler struct { chatHistoryService service.IChatHistoryService userService service.IUserService } func NewChatHistoryHandler( chatHistoryService service.IChatHistoryService, userService service.IUserService, ) *ChatHistoryHandler { return &ChatHistoryHandler{ chatHistoryService: chatHistoryService, userService: userService, } } ``` #### 分页查询应用对话历史(ListAppChatHistory) **接口说明:** 用户查看指定应用的对话历史,使用游标分页。 **完整代码:** ```go func (h *ChatHistoryHandler) ListAppChatHistory(ctx context.Context, c *app.RequestContext) { // 1. 获取路径参数appId appIdStr := c.Param("appId") appId, err := strconv.ParseInt(appIdStr, 10, 64) if err != nil { c.JSON(consts.StatusOK, response.NewErrorResponse[any](errorutil.ParamsError.WithMessage("应用ID格式错误"))) return } // 2. 获取查询参数pageSize,默认值为10 pageSizeStr := c.Query("pageSize") pageSize := int32(10) // 默认值 if pageSizeStr != "" { if ps, err := strconv.Atoi(pageSizeStr); err == nil { pageSize = int32(ps) } } // 3. 获取查询参数lastCreateTime,可选 lastCreateTimeStr := c.Query("lastCreateTime") var lastCreateTime time.Time if lastCreateTimeStr != "" { if t, err := time.Parse(time.RFC3339, lastCreateTimeStr); err == nil { lastCreateTime = t } } // 4. 获取登录用户 loginUser, err := h.userService.GetLoginUserVo(ctx, c) if err != nil { c.JSON(consts.StatusOK, response.NewErrorResponse[any](err)) return } // 5. 调用服务层方法 result, err := h.chatHistoryService.ListAppChatHistoryByPage(ctx, appId, pageSize, lastCreateTime, &loginUser) if err != nil { c.JSON(consts.StatusOK, response.NewErrorResponse[any](err)) return } // 6. 返回成功响应 c.JSON(consts.StatusOK, response.NewSuccessResponse[*response.PageResponse[*model.ChatHistory]](result)) } ``` #### 管理员分页查询所有对话历史(ListAllChatHistoryByPageForAdmin) **接口说明:** 管理员查看所有应用的对话历史,支持多条件筛选,使用传统分页。 **请求参数(文件位置 `internal/api/chat_history.go`):** ```go type YiKouChatHistoryQueryRequest struct { Id int64 `json:"id"` // 对话ID AppId int64 `json:"appId"` // 应用ID UserId int64 `json:"userId"` // 用户ID MessageType string `json:"messageType"` // 消息类型 Message string `json:"message"` // 消息内容(模糊搜索) LastCreateTime time.Time `json:"lastCreateTime"` // 创建时间过滤 } type YiKouChatHistoryQueryResponse response.BaseResponse[response.PageResponse[*model.ChatHistory]] ``` **完整代码:** ```go func (h *ChatHistoryHandler) ListAllChatHistoryByPageForAdmin(ctx context.Context, c *app.RequestContext) { // 1. 绑定请求参数 req := &api.YiKouChatHistoryQueryRequest{} err := c.BindAndValidate(req) if err != nil { c.JSON(consts.StatusOK, response.NewErrorResponse[any](errorutil.ParamsError)) return } // 2. 获取分页参数 pageNum := int32(1) // 默认值 pageSize := int32(10) // 默认值 // 3. 调用服务层方法 result, err := h.chatHistoryService.ListAllChatHistoryByPageForAdmin(ctx, pageNum, pageSize, req) if err != nil { c.JSON(consts.StatusOK, response.NewErrorResponse[any](err)) return } // 4. 返回成功响应 c.JSON(consts.StatusOK, response.NewSuccessResponse[*response.PageResponse[*model.ChatHistory]](result)) } ``` #### 修改路由文件增加接口声明 文件位置 `internal/router/router.go` ```go // RegisterRoutes 注册路由 func RegisterRoutes(h *server.Hertz, url func(config *swagger.Config), db *gorm.DB, userHandler *handler.UserHandler, appHandler *handler.AppHandler, chatHistoryHandler *handler.ChatHistoryHandler) { // 注册全局中间件 // 处理跨域问题 h.Use(cors.New(cors.Config{ AllowAllOrigins: true, AllowMethods: []string{"GET", "POST", "PUT", "DELETE", "OPTIONS"}, AllowHeaders: []string{"Origin", "Content-Type", "Authorization"}, ExposeHeaders: []string{"Content-Length"}, AllowCredentials: false, MaxAge: 12 * time.Hour, })) // 全局异常处理 h.Use(recovery.Recovery(recovery.WithRecoveryHandler(CustomRecoveryHandler))) // 测试接口 h.GET("/ping", handler.Ping) // swaggo文档 h.GET("/swagger/*any", swagger.WrapHandler(swaggerFiles.Handler, url)) userRoute := h.Group("/user") { userRoute.POST("/register", userHandler.UserRegister) userRoute.POST("/login", userHandler.UserLogin) userRoute.GET("/get/vo", userHandler.GetUserVo) // 需要登录的接口 userRoute.GET("/get/login", middleware.AuthMiddleware(enum.UserRole, db), userHandler.GetLoginUser) userRoute.POST("/logout", middleware.AuthMiddleware(enum.UserRole, db), userHandler.Logout) // 需要管理员权限的接口 userRoute.POST("/add", middleware.AuthMiddleware(enum.AdminRole, db), userHandler.AddUser) userRoute.GET("/get", middleware.AuthMiddleware(enum.AdminRole, db), userHandler.GetUser) userRoute.POST("/delete", middleware.AuthMiddleware(enum.AdminRole, db), userHandler.DeleteUser) userRoute.POST("/update", middleware.AuthMiddleware(enum.AdminRole, db), userHandler.UpdateUser) userRoute.POST("/list/page/vo", middleware.AuthMiddleware(enum.AdminRole, db), userHandler.ListUserVoByPage) } appRoute := h.Group("/app") { appRoute.POST("/good/list/page/vo", appHandler.ListGoodApp) appRoute.GET("/get/vo", middleware.AuthMiddleware(enum.UserRole, db), appHandler.GetAppVo) // 需要登录的接口 appRoute.GET("/chat/gen/code", middleware.AuthMiddleware(enum.UserRole, db), appHandler.ChatToGenCode) appRoute.POST("/my/list/page/vo", middleware.AuthMiddleware(enum.UserRole, db), appHandler.ListMyApp) appRoute.POST("/add", middleware.AuthMiddleware(enum.UserRole, db), appHandler.AddApp) appRoute.POST("/update", middleware.AuthMiddleware(enum.UserRole, db), appHandler.UpdateApp) appRoute.POST("/delete", middleware.AuthMiddleware(enum.UserRole, db), appHandler.DeleteApp) // 需要管理员权限的接口 appRoute.POST("/admin/update", middleware.AuthMiddleware(enum.AdminRole, db), appHandler.AdminUpdateApp) appRoute.POST("/admin/delete", middleware.AuthMiddleware(enum.AdminRole, db), appHandler.AdminDeleteApp) appRoute.GET("/admin/get/vo", middleware.AuthMiddleware(enum.AdminRole, db), appHandler.AdminGetAppVo) appRoute.POST("/admin/list/page/vo", middleware.AuthMiddleware(enum.AdminRole, db), appHandler.AdminListApp) } // 聊天历史路由 chatHistoryRoute := h.Group("/chatHistory") { // 需要管理员权限的接口 chatHistoryRoute.POST("/admin/list/page/vo", middleware.AuthMiddleware(enum.AdminRole, db), chatHistoryHandler.ListAllChatHistoryByPageForAdmin) chatHistoryRoute.GET("/app/:appId", middleware.AuthMiddleware(enum.UserRole, db), chatHistoryHandler.ListAppChatHistory) } } ``` ### 应用模块集成对话历史服务 除了专门的对话历史接口外,应用模块也需要调用对话历史服务来保存用户和AI的对话记录。本节将详细描述 `app_handler.go` 和 `app_logic.go` 中如何集成对话历史服务。 #### Handler 层集成 **文件位置:** `internal/handler/app_handler.go` ##### AppHandler 结构体修改 在 `AppHandler` 中注入 `chatHistoryService`: ```go type AppHandler struct { appService service.IAppService userService service.IUserService chatHistoryService service.IChatHistoryService // ← 新增:对话历史服务 } func NewAppHandler( appService service.IAppService, userService service.IUserService, chatHistoryService service.IChatHistoryService, // ← 新增参数 ) *AppHandler { return &AppHandler{ appService: appService, userService: userService, chatHistoryService: chatHistoryService, } } ``` ##### ChatToGenCode 方法中的调用 **功能说明:** 在流式代码生成完成后,异步保存AI的响应消息到对话历史表。 **调用位置:** 流式响应结束后 **完整代码片段:** ```go func (a *AppHandler) ChatToGenCode(ctx context.Context, c *app.RequestContext) { // ... 前面的代码省略 var aiResponseBuilder strings.Builder for { // ... 流式读取代码省略 aiResponseBuilder.WriteString(chunk.Content) // ... 发送SSE事件省略 } // ← 关键调用:保存AI响应到对话历史 err = a.chatHistoryService.AddChatMessage(ctx, appId, aiResponseBuilder.String(), enum.AIMessageType, userVo.ID) if err != nil { logger.Errorf("保存对话历史失败: %v\n", err) } _ = w.WriteEvent(lastEventID, "done", []byte{1}) } ``` #### Service 层集成 **文件位置:** `internal/logic/app_logic.go` ##### AppService 结构体修改 在 `AppService` 中注入 `chatHistoryService`: ```go func NewAppService( aiCodeGenFacade *core.YiKouAiCodegenFacade, userService service.IUserService, chatHistoryService service.IChatHistoryService, // ← 新增:对话历史服务 db *gorm.DB, ) *AppService { return &AppService{ aiCodeGenFacade: aiCodeGenFacade, userService: userService, chatHistoryService: chatHistoryService, db: db, } } type AppService struct { aiCodeGenFacade *core.YiKouAiCodegenFacade userService service.IUserService chatHistoryService service.IChatHistoryService // ← 新增字段 db *gorm.DB } ``` ##### ChatToGenCode 方法中的调用 **功能说明:** 在调用代码生成服务前,先保存用户的对话消息到对话历史表。 **调用位置:** 参数校验通过后,调用代码生成服务前 **完整代码片段:** ```go func (s *AppService) ChatToGenCode(ctx context.Context, appId int64, message string, loginUser *vo.UserVo) (*schema.StreamReader[*schema.Message], error) { // 1. 校验参数 if message == "" { return nil, errorutil.ParamsError.WithMessage("消息不能为空") } if appId == 0 || appId < 0 { return nil, errorutil.ParamsError.WithMessage("应用ID不能为空") } // 2. 校验应用是否存在 app, err := query.Use(s.db).App.Where(query.App.ID.Eq(appId), query.App.IsDelete.Eq(0)).First() if err != nil { return nil, err } // 3. 校验用户是否有权限使用该应用 if app.UserID != loginUser.ID { return nil, errorutil.NotAuthError.WithMessage("无权使用该应用") } // 4. 获取代码生成类型 if enum.CodeGenTypeTextMap[enum.CodeGenTypeEnum(app.CodeGenType)] == "" { return nil, errorutil.ParamsError.WithMessage("应用代码生成类型不支持") } // ← 关键调用:保存用户消息到对话历史 err = s.chatHistoryService.AddChatMessage(ctx, appId, message, enum.UserMessageType, loginUser.ID) if err != nil { logger.Errorf("保存对话历史失败: %v\n", err) } // 6. 调用代码生成服务 return s.aiCodeGenFacade.GenCodeStreamAndSave(ctx, message, enum.CodeGenTypeEnum(app.CodeGenType), appId) } ``` ##### DeleteApp 方法中的调用 **功能说明:** 在删除应用时,级联删除该应用的所有对话历史记录。 **调用位置:** 应用逻辑删除成功后 **完整代码片段:** ```go func (s *AppService) DeleteApp(ctx context.Context, id int64, userId int64) (bool, error) { // 1. 查询应用 app, err := query.Use(s.db).App.Where(query.App.ID.Eq(id)).First() if err != nil { return false, err } // 2. 校验权限 if app.UserID != userId { return false, errorutil.ParamsError.WithMessage("无权删除该应用") } // 3. 逻辑删除应用 _, err = query.Use(s.db).App.Where(query.App.ID.Eq(id)).Update(query.App.IsDelete, 1) if err != nil { return false, err } // ← 关键调用:级联删除对话历史 err = s.chatHistoryService.DeleteByAppId(ctx, id) if err != nil { logger.Errorf("对话历史删除失败: %v\n", err) } return true, nil } ``` ## 三、集成Eino对话记忆 本节将详细讲解Eino框架的对话记忆机制在项目中的完整实现,包括基础设施层、存储层、Agent层和工厂层的架构设计与代码实现。 ### 对话记忆的保存方案设计 在深入实现细节之前,我们需要先理解一个核心设计决策:**为什么Eino对话记忆保存在Redis,而不是MySQL?** #### 一个关键的区别:对话历史 vs 对话记忆 很多人会混淆这两个概念,但它们有本质区别: **对话历史(Chat History)** - 保存在MySQL的 `chat_history` 表中 - 是**完整的、永久的**对话记录 - 用于**审计、统计、回溯** - 数据结构:包含 appId、userId、turnNumber、messageType 等完整字段 - 查询场景:管理员查看、用户翻阅历史、数据分析 **对话记忆(Conversation Memory)** - 保存在Redis的 `memory:{appId}` 键中 - 是**裁剪的、临时的**对话上下文 - 用于**AI实时推理** - 数据结构:只包含 role 和 content 的消息列表 - 查询场景:AI调用时加载上下文 用一个比喻来理解: ``` 对话历史 = 银行的交易流水账本 - 永久保存,不能修改 - 记录每一笔交易的完整信息 - 用于对账、审计、统计 - 存储在数据库 对话记忆 = 你的记账本摘要 - 只记录最近几笔交易 - 定期清理旧记录 - 用于快速查看当前财务状况 - 存储在便签纸上(Redis) ``` #### 为什么Eino对话记忆不用MySQL? 假设我们用MySQL存储Eino对话记忆,会发生什么? **场景:用户发送一条消息,AI生成响应** ``` [步骤1] 用户发送消息 "添加删除功能" ↓ [步骤2] 从MySQL加载对话记忆 执行SQL: SELECT * FROM chat_history WHERE app_id = 123 ORDER BY create_time DESC LIMIT 20; 耗时:5-10ms(需要解析SQL、优化查询、扫描索引、回表) ↓ [步骤3] 将查询结果转换为Eino的Message格式 遍历20条记录,构建 []*schema.Message 耗时:1-2ms ↓ [步骤4] 调用AI模型(带上下文) 耗时:2000-5000ms(网络请求) ↓ [步骤5] AI响应完成,保存新的对话记忆 执行SQL: INSERT INTO chat_history (...) VALUES (...); 耗时:3-5ms ↓ 总耗时:2010-5020ms ``` **如果用Redis存储对话记忆:** ``` [步骤1] 用户发送消息 "添加删除功能" ↓ [步骤2] 从Redis加载对话记忆 执行命令: GET memory:123 耗时:0.5-1ms(直接内存读取,无SQL解析) ↓ [步骤3] JSON反序列化为Message格式 耗时:0.5-1ms ↓ [步骤4] 调用AI模型(带上下文) 耗时:2000-5000ms(网络请求) ↓ [步骤5] AI响应完成,保存新的对话记忆 执行命令: SET memory:123 '...' EX 86400 耗时:0.5-1ms ↓ 总耗时:2002-5003ms ``` **性能对比:** | 操作 | MySQL | Redis | 差异 | | ---------- | ------ | ------- | ------------------ | | 加载记忆 | 5-10ms | 0.5-1ms | **快10倍** | | 保存记忆 | 3-5ms | 0.5-1ms | **快5倍** | | 总耗时影响 | +15ms | +3ms | **节省12ms** | 看起来差异不大?但考虑以下场景: **场景:高并发情况下,每秒100个用户同时对话** ``` MySQL方案: 每秒 100 次读取 + 100 次写入 = 200 次数据库操作 数据库连接池压力:高 慢查询风险:高(特别是OFFSET分页) 主从延迟风险:高(写入后立即读取可能读到旧数据) Redis方案: 每秒 100 次读取 + 100 次写入 = 200 次Redis操作 Redis单线程也能轻松处理(QPS可达10万+) 连接池压力:低 响应速度:稳定在1ms以内 ``` #### 那对话历史为什么还保存在MySQL? 既然Redis这么快,为什么不把对话历史也保存在Redis? **原因1:持久化要求** 对话历史是**审计数据**,必须永久保存。Redis虽然有RDB/AOF持久化,但: - RDB是定期快照,可能丢失最近的数据 - AOF虽然实时,但文件体积大,恢复慢 - Redis重启后数据可能丢失 MySQL的InnoDB引擎提供ACID事务保证,数据绝对不会丢失。 **原因2:复杂查询需求** 对话历史需要支持: - 分页查询(游标分页、传统分页) - 多条件筛选(按appId、userId、messageType) - 聚合统计(按应用统计对话数、按用户统计活跃度) - 关联查询(JOIN应用表、用户表) Redis只能做简单的Key-Value操作,无法支持这些复杂查询。 **原因3:数据分析需求** 运营需要分析: - 用户最常问的问题是什么? - 哪个应用的对话最多? - 用户活跃度趋势如何? 这些需要SQL聚合查询,Redis无法支持。 **原因4:合规性要求** 很多行业要求保留用户操作日志至少6个月,甚至永久保存。Redis的内存成本太高,不适合存储海量历史数据。 #### 存储方案总结 | 维度 | 对话历史(MySQL) | 对话记忆(Redis) | | ---------------- | ---------------------------- | ------------------------- | | **用途** | 审计、统计、回溯 | AI实时推理 | | **数据量** | 全量永久保存 | 最近20条,24小时TTL | | **字段** | 完整字段(appId、userId等) | 简化字段(role、content) | | **查询** | 复杂查询(分页、筛选、聚合) | 简单查询(GET、SET) | | **性能** | 5-10ms | 0.5-1ms | | **一致性** | 强一致(ACID) | 最终一致 | | **持久化** | 永久保存 | 可能丢失(可重建) | | **成本** | 磁盘存储,成本低 | 内存存储,成本高 | ### Redis初始化 我们先在控制台执行以下命令下载go-redis库,然后修改dal包下的 `init.go`文件 ```bash go get github.com/redis/go-redis/v9 v9.7.3 ``` **文件位置:** `internal/dal/init.go` #### 功能说明 负责项目核心基础设施的初始化,包括MySQL数据库连接和Redis客户端连接。而Redis是整个对话记忆系统的基础设施支撑,我们在原来的初始化内容增加一个Redis的provider方法用于注入。 #### 完整代码 ```go package dal import ( "fmt" "github.com/redis/go-redis/v9" "gorm.io/driver/mysql" "gorm.io/gorm" "gorm.io/gorm/logger" "yikou-ai-go-teach/config" "yikou-ai-go-teach/internal/dal/query" ) // InitDB 初始化数据库连接 func InitDB(config *config.Config) *gorm.DB { if config == nil { panic(fmt.Errorf("配置加载失败")) } dsn := config.Database.GetDSN() db, err := gorm.Open(mysql.Open(dsn), &gorm.Config{ Logger: logger.Default.LogMode(logger.Info), }) if err != nil { panic(fmt.Errorf("数据库连接失败: %w", err)) } query.SetDefault(db) return db } // InitRedis 初始化Redis连接 func InitRedis(config *config.Config) *redis.Client { if config == nil { panic(fmt.Errorf("配置加载失败")) } redisClient := redis.NewClient(&redis.Options{ Addr: fmt.Sprintf("%s:%d", config.Redis.Host, config.Redis.Port), Password: config.Redis.Password, DB: config.Redis.DB, }) return redisClient } ``` ### RedisMemoryStore实现 **文件位置:** `internal/store/memory_store.go` #### 功能说明 由于Eino官方不支持将对话记忆抽象为组件,所有我根据Eino官网的方案自定义了一个MemoryStore的接口,我们只需要自定义一种对话记忆存储方式实现然后在基础agent引用就行了。这里我实现了基于Redis的对话记忆存储,作为MemoryStore接口的具体实现。负责对话消息的持久化存储和读取。  #### 接口定义与实现 ```go package store import ( "context" "encoding/json" "fmt" "github.com/cloudwego/eino/schema" "github.com/redis/go-redis/v9" "time" ) // MemoryStore 对话记忆存储接口 type MemoryStore interface { GetMessages(ctx context.Context) ([]*schema.Message, error) AppendMessage(ctx context.Context, message *schema.Message) error } // RedisMemoryStore Redis实现的内存存储 type RedisMemoryStore struct { redisClient *redis.Client memoryId string maxMemoryMessages int ttl time.Duration } ``` #### 构造函数 ```go func NewRedisMemoryStore(redisClient *redis.Client, memoryId string, maxMemoryMessages int, ttl time.Duration) *RedisMemoryStore { return &RedisMemoryStore{ redisClient: redisClient, memoryId: memoryId, maxMemoryMessages: maxMemoryMessages, ttl: ttl, } } ``` #### 核心方法实现 ##### 获取消息列表(GetMessages) ```go func (r RedisMemoryStore) GetMessages(ctx context.Context) ([]*schema.Message, error) { key := fmt.Sprintf("memory:%s", r.memoryId) data, err := r.redisClient.Get(ctx, key).Bytes() if err != nil { return nil, err } return decodeMessagesFromJSON(data) } ``` ##### 追加消息(AppendMessage) ```go func (r RedisMemoryStore) AppendMessage(ctx context.Context, message *schema.Message) error { messages, err := r.GetMessages(ctx) if err != nil { if errors.Is(err, redis.Nil) { messages = []*schema.Message{} } else { return err } } messages = append(messages, message) messagesToJSON, err := encodeMessagesToJSON(messages) if err != nil { return err } key := fmt.Sprintf("memory:%s", r.memoryId) return r.redisClient.Set(ctx, key, messagesToJSON, r.ttl).Err() } ``` ##### 序列化辅助函数 ```go func encodeMessagesToJSON(msgs []*schema.Message) ([]byte, error) { return json.Marshal(msgs) } func decodeMessagesFromJSON(data []byte) ([]*schema.Message, error) { if len(data) == 0 { return nil, nil } var msgs []*schema.Message err := json.Unmarshal(data, &msgs) return msgs, err } ``` ### 修改基础Agent - Eino对话记忆核心实现 **文件位置:** `internal/ai/agent/base_agent.go` #### 修改结构体定义和构造函数 ```go type ChatModelWrapperAdaptor interface { GetChatModel() *openai.ChatModel GetModelName() string } type BaseAgent struct { model *openai.ChatModel modelName string memoryStore store.MemoryStore } func NewBaseAgent(chatModel ChatModelWrapperAdaptor, memoryStore store.MemoryStore) *BaseAgent { return &BaseAgent{ model: chatModel.GetChatModel(), modelName: chatModel.GetModelName(), memoryStore: memoryStore, } } ``` #### 修改流式生成方法(GenerateStream) ```go func (a *BaseAgent) GenerateStream(ctx context.Context, userMessage string, chatTemplate prompt.ChatTemplate, adkAgent *adk.ChatModelAgent) (*schema.StreamReader[*schema.Message], error) { // 1. 从Redis加载对话历史 messages, err := a.memoryStore.GetMessages(ctx) if err != nil { if errors.Is(err, redis.Nil) { messages = []*schema.Message{} } else { return nil, err } } // 2. 格式化Prompt(包含历史上下文) format, err := chatTemplate.Format(ctx, map[string]any{ "content": userMessage, "history": messages, }) if err != nil { return nil, err } err = a.memoryStore.AppendMessage(ctx, schema.UserMessage(userMessage)) if err != nil { return nil, err } // 3. 创建流式Runner runner := adk.NewRunner(ctx, adk.RunnerConfig{ Agent: adkAgent, EnableStreaming: true, }) iter := runner.Run(ctx, format) // 4. 创建管道用于流式传输 reader, writer := schema.Pipe[*schema.Message](2) // 5. 异步处理流数据 go func() { defer writer.Close() var fullContent string for { event, ok := iter.Next() if !ok { break } if event.Err != nil { writer.Send(nil, event.Err) return } if event.Output != nil && event.Output.MessageOutput != nil { stream := event.Output.MessageOutput.MessageStream if stream != nil { for { msg, err := stream.Recv() if err == io.EOF { break } if err != nil { writer.Send(nil, err) return } if msg != nil { fullContent += msg.Content writer.Send(msg, nil) } } } } } // 6. 将完整响应保存到Redis err := a.memoryStore.AppendMessage(ctx, schema.AssistantMessage(fullContent, nil)) if err != nil { logger.Errorf("保存对话记忆失败: %v", err) } }() return reader, nil } ``` ### 修改代码生成Agent **文件位置:** `internal/ai/agent/codegen_agent.go` ```go func NewCodeGenAgent(chatModel ChatModelWrapperAdaptor, codeGenType enum.CodeGenTypeEnum, memoryStore store.MemoryStore) *CodeGenAgent { baseAgent := NewBaseAgent(chatModel, memoryStore) return &CodeGenAgent{ BaseAgent: baseAgent, agentType: codeGenType, } } ``` ### 增加Agent工厂结构体 **文件位置:** `internal/ai/ai/agent/codegen_agent_factory.go` #### 为什么使用工厂模式? 在修改代码实现后,由于原有的智能体业务发生了较大的改动,于是在这里我引用工厂模式进行创建代码生成智能体。当然,在学习业务逻辑前,我们先理解为什么需要引入工厂模式。通过对比**没有工厂模式**和**有工厂模式**的代码,你会发现工厂模式解决了哪些核心问题。 ##### 问题场景:没有工厂模式时 假设我们直接在业务代码中创建 `CodeGenAgent`,会发生什么? **场景:用户请求生成HTML代码** ```go // 在 Handler 或 Service 中直接创建 Agent func (h *AppHandler) ChatToGenCode(c *gin.Context) { // ... 获取参数 redisStore := store.NewRedisMemoryStore( h.redisClient, // 需要传递Redis客户端 strconv.Itoa(int(appId)), // 需要手动转换类型 20, // 魔法数字:最大消息数 24*time.Hour, // 魔法数字:TTL ) agent := agent.NewCodeGenAgent( h.chatModel, // 需要传递ChatModel codeGenType, // 需要传递类型 redisStore, // 需要传递刚创建的Store ) // ... } ``` **这段代码有什么问题?** **问题1:重复代码** 每次需要Agent时,都要重复这段创建逻辑: ``` 创建RedisStore → 配置参数 → 创建Agent → 传递依赖 ``` 如果项目中有10个地方需要创建Agent,这段代码就要复制10次。 **问题2:违反开闭原则** 假设我们要修改RedisMemoryStore的配置: ```go // 从 20条消息 改为 30条消息 redisStore := store.NewRedisMemoryStore( h.redisClient, strconv.Itoa(int(appId)), 30, // ← 修改这里 24*time.Hour, ) ``` 我们需要找到所有创建Agent的地方,逐一修改。如果有10处,就要改10次。 ##### 解决方案:引入工厂模式 工厂模式的核心思想:**把对象的创建逻辑封装到一个专门的类中**。 ```go // 工厂类:专门负责创建 CodeGenAgent type CodeGenAgentFactory struct { chatModel *llm.ChatModelWrapper // 持有依赖 redisClient *redis.Client // 持有依赖 chatHistoryService service.IChatHistoryService // 持有依赖 } // 工厂方法:封装创建逻辑 func (c CodeGenAgentFactory) GetCodeGenAgent(appId int64, codeGenType enum.CodeGenTypeEnum) (*CodeGenAgent, error) { // 所有创建逻辑都在这里 redisStore := store.NewRedisMemoryStore(c.redisClient, strconv.Itoa(int(appId)), 20, 24*time.Hour) return NewCodeGenAgent(c.chatModel, codeGenType, redisStore), nil } ``` **业务代码变得简洁:** ```go // 在 Handler 或 Service 中 func (h *AppHandler) ChatToGenCode(c *gin.Context) { // ... 获取参数 // 一行代码创建Agent,所有细节都被封装 agent, err := h.agentFactory.GetCodeGenAgent(appId, codeGenType) if err != nil { // 错误处理 } // 业务逻辑清晰,不被创建逻辑干扰 stream, err := agent.GenerateHtmlCodeStream(ctx, userMessage) // ... } ``` #### 结构体定义 ```go type CodeGenAgentFactory struct { chatModel *llm.ChatModelWrapper redisClient *redis.Client chatHistoryService service.IChatHistoryService } ``` #### 构造函数 ```go func NewCodeGenAgentFactory(chatModel *llm.ChatModelWrapper, redisClient *redis.Client, chatHistoryService service.IChatHistoryService) *CodeGenAgentFactory { return &CodeGenAgentFactory{ chatModel: chatModel, redisClient: redisClient, chatHistoryService: chatHistoryService, } } ``` #### 创建Agent方法 ```go func (c CodeGenAgentFactory) GetCodeGenAgent(appId int64, codeGenType enum.CodeGenTypeEnum) (*CodeGenAgent, error) { redisStore := store.NewRedisMemoryStore(c.redisClient, strconv.Itoa(int(appId)), 20, 24*time.Hour) return NewCodeGenAgent(c.chatModel, codeGenType, redisStore), nil } ``` ### 修改门面结构体 **文件位置:** `internal/core/ai_codegen_facade.go` ```go package core import ( "context" "fmt" "io" "strings" "github.com/bytedance/gopkg/util/logger" "github.com/cloudwego/eino/schema" "yikou-ai-go-teach/internal/ai/agent" "yikou-ai-go-teach/internal/core/parser" "yikou-ai-go-teach/internal/core/saver" "yikou-ai-go-teach/pkg/enum" ) // YiKouAiCodegenFacade 代码生成门面 type YiKouAiCodegenFacade struct { codeGenFactory *agent.CodeGenAgentFactory // Agent工厂 codeParserExecutor *parser.CodeParserExecutor // 代码解析器 codeFileSaverExecutor *saver.CodeFileSaverExecutor // 代码保存器 } // NewYiKouAiCodegenFacade 构造函数 func NewYiKouAiCodegenFacade( codeGenFactory *agent.CodeGenAgentFactory, codeParserExecutor *parser.CodeParserExecutor, codeFileSaverExecutor *saver.CodeFileSaverExecutor, ) *YiKouAiCodegenFacade { return &YiKouAiCodegenFacade{ codeGenFactory: codeGenFactory, codeParserExecutor: codeParserExecutor, codeFileSaverExecutor: codeFileSaverExecutor, } } // GenCodeStreamAndSave 流式代码生成并保存(核心方法) func (y *YiKouAiCodegenFacade) GenCodeStreamAndSave( ctx context.Context, userMessage string, typeStr enum.CodeGenTypeEnum, appId int64, ) (*schema.StreamReader[*schema.Message], error) { // 创建Agent genAgent, err := y.codeGenFactory.GetCodeGenAgent(appId, typeStr) if err != nil { return nil, err } // 根据类型调用不同的生成方法 switch typeStr { case enum.HtmlCodeGen: streamResp, err := genAgent.GenerateHtmlCodeStream(ctx, userMessage) if err != nil { return nil, err } return y.processCodeStream(streamResp, typeStr, appId) case enum.MultiFileGen: streamResp, err := genAgent.GenerateMultiFileCodeStream(ctx, userMessage) if err != nil { return nil, err } return y.processCodeStream(streamResp, typeStr, appId) default: return nil, fmt.Errorf("不支持的代码生成类型: %s", typeStr) } } // processCodeStream 处理流式响应并异步保存 func (y *YiKouAiCodegenFacade) processCodeStream( respStream *schema.StreamReader[*schema.Message], typeStr enum.CodeGenTypeEnum, appId int64, ) (*schema.StreamReader[*schema.Message], error) { // 复制流 streams := respStream.Copy(2) processingStream := streams[0] returnStream := streams[1] // 异步处理 go func() { var builder strings.Builder defer processingStream.Close() // 读取流 for { chunk, err := processingStream.Recv() if err == io.EOF { break } if err != nil { return } builder.WriteString(chunk.Content) } // 解析和保存 parsedResp, err := y.codeParserExecutor.ExecuteParser(builder.String(), typeStr) if err != nil { return } dirPath, err := y.codeFileSaverExecutor.ExecuteSaver(parsedResp, typeStr, appId) if err != nil { return } logger.Info("代码已保存到目录: %s", dirPath) }() return returnStream, nil } ``` ### 修改依赖注入文件 **文件位置:** `wire/wire.go` ##### 修改点1:新增Redis客户端Provider ```go // 数据库依赖 var dbSet = wire.NewSet( dal.InitDB, // MySQL客户端 dal.InitRedis, // ← 新增:Redis客户端 ) ``` ##### 修改点2:新增ChatHistoryService注册并移除原来的agentService注入 ```go // Service依赖 var serviceSet = wire.NewSet( logic.NewAppService, wire.Bind(new(service.IAppService), new(*logic.AppService)), logic.NewUserService, wire.Bind(new(service.IUserService), new(*logic.UserService)), // ← 新增:ChatHistoryService logic.NewChatHistoryService, wire.Bind(new(service.IChatHistoryService), new(*logic.ChatHistoryService)), ) ``` ##### 修改点3:新增ChatHistoryHandler ```go // Handler依赖 var handlerSet = wire.NewSet( handler.NewUserHandler, handler.NewAppHandler, handler.NewChatHistoryHandler, ) ``` ##### 修改点4:新增CodeGenAgentFactory注册 ```go // 初始化函数 func InitializeApp() (*server.Hertz, error) { panic(wire.Build( initServer, configSet, dbSet, serviceSet, handlerSet, llmSet, parser.NewCodeParserExecutor, saver.NewCodeFileSaverExecutor, agent.NewCodeGenAgentFactory, // ← 新增:Agent工厂 core.NewYiKouAiCodegenFacade, )) } ``` ##### 修改点5:initServer方法 ```go // initServer 初始化 Web 服务器 func initServer(cfg *config.Config, userHandler *handler.UserHandler, appHandler *handler.AppHandler, db *gorm.DB, chatHistoryHandler *handler.ChatHistoryHandler) *server.Hertz { // 动态设置 Swagger 信息 docs.SwaggerInfo.Host = fmt.Sprintf("localhost:%d", cfg.Server.Port) docs.SwaggerInfo.BasePath = cfg.Server.ContextPath // 初始化swagger路径 swaggerPath := fmt.Sprintf("http://localhost:%d%s/swagger/doc.json", cfg.Server.Port, cfg.Server.ContextPath) url := swagger.URL(swaggerPath) // 创建 Hertz 服务器 h := server.Default( server.WithHostPorts(":"+strconv.Itoa(cfg.Server.Port)), server.WithBasePath(cfg.Server.ContextPath), ) // 注册路由 router.RegisterRoutes(h, url, db, userHandler, appHandler, chatHistoryHandler) return h } ``` **最后在wire目录下运行以下生成命令** ```bash wire gen wire/wire.go ``` 如果配置正确,会生成 `wire/wire_gen.go` 文件,无报错。 ### 测试对话记忆功能 直接启动前端服务器,然后随便生成一个应用  然后查看Redis保存记忆对话是否成功  可以得到对话记忆如下 ```json [ { "role": "user", "content": "做一个个人博客网站,包含文章列表和详情页面" }, { "role": "assistant", "content": "这是一个包含文章列表和详情功能的个人博客网站。它使用原生 JavaScript 模拟了单页面应用(SPA)的视图切换体验。\n\n```html\n\u003c!DOCTYPE html\u003e\n\u003chtml lang=\"zh-CN\"\u003e\n\u003chead\u003e\n \u003cmeta charset=\"UTF-8\"\u003e\n \u003cmeta name=\"viewport\" content=\"width=device-width, initial-scale=1.0\"\u003e\n \u003ctitle\u003e我的极简博客\u003c/title\u003e\n \u003cstyle\u003e\n /* --- 全局重置与基础样式 --- */\n :root {\n --primary-color: #2c3e50;\n --accent-color: #3498db;\n --bg-color: #f9f9f9;\n --card-bg: #ffffff;\n --text-color: #333;\n --text-light: #666;\n --border-radius: 8px;\n --shadow: 0 4px 6px rgba(0,0,0,0.05);\n --transition: all 0.3s ease;\n }\n\n * {\n box-sizing: border-box;\n margin: 0;\n padding: 0;\n }\n\n body {\n font-family: -apple-system, BlinkMacSystemFont, \"Segoe UI\", Roboto, \"Helvetica Neue\", Arial, sans-serif;\n line-height: 1.6;\n color: var(--text-color);\n background-color: var(--bg-color);\n display: flex;\n flex-direction: column;\n min-height: 100vh;\n }\n\n a {\n text-decoration: none;\n color: inherit;\n }\n\n ul {\n list-style: none;\n }\n\n img {\n max-width: 100%;\n display: block;\n }\n\n /* --- 头部导航 --- */\n header {\n background-color: var(--card-bg);\n box-shadow: var(--shadow);\n position: sticky;\n top: 0;\n z-index: 100;\n }\n\n .nav-container {\n max-width: 1200px;\n margin: 0 auto;\n padding: 1rem 2rem;\n display: flex;\n justify-content: space-between;\n align-items: center;\n }\n\n .logo {\n font-size: 1.5rem;\n font-weight: 700;\n color: var(--primary-color);\n }\n\n .nav-links a {\n margin-left: 20px;\n font-weight: 500;\n color: var(--text-light);\n transition: var(--transition);\n }\n\n .nav-links a:hover {\n color: var(--accent-color);\n }\n\n /* --- 主要内容区域 --- */\n main {\n flex: 1;\n max-width: 1200px;\n margin: 2rem auto;\n padding: 0 2rem;\n width: 100%;\n }\n\n /* --- 文章列表视图 --- */\n .view-section {\n display: none; /* 默认隐藏所有视图 */\n animation: fadeIn 0.5s ease;\n }\n\n .view-section.active {\n display: block; /* 激活时显示 */\n }\n\n .page-title {\n margin-bottom: 2rem;\n font-size: 2rem;\n color: var(--primary-color);\n border-bottom: 2px solid var(--accent-color);\n display: inline-block;\n padding-bottom: 0.5rem;\n }\n\n .post-grid {\n display: grid;\n grid-template-columns: repeat(auto-fill, minmax(300px, 1fr));\n gap: 2rem;\n }\n\n .post-card {\n background: var(--card-bg);\n border-radius: var(--border-radius);\n overflow: hidden;\n box-shadow: var(--shadow);\n transition: var(--transition);\n cursor: pointer;\n display: flex;\n flex-direction: column;\n }\n\n .post-card:hover {\n transform: translateY(-5px);\n box-shadow: 0 10px 15px rgba(0,0,0,0.1);\n }\n\n .post-card-image {\n height: 200px;\n width: 100%;\n object-fit: cover;\n }\n\n .post-card-content {\n padding: 1.5rem;\n flex: 1;\n display: flex;\n flex-direction: column;\n }\n\n .post-meta {\n font-size: 0.85rem;\n color: var(--text-light);\n margin-bottom: 0.5rem;\n }\n\n .post-title {\n font-size: 1.25rem;\n margin-bottom: 0.75rem;\n color: var(--primary-color);\n }\n\n .post-excerpt {\n color: var(--text-light);\n font-size: 0.95rem;\n margin-bottom: 1.5rem;\n flex: 1;\n }\n\n .read-more {\n color: var(--accent-color);\n font-weight: 600;\n font-size: 0.9rem;\n align-self: flex-start;\n }\n\n /* --- 文章详情视图 --- */\n .back-btn {\n display: inline-flex;\n align-items: center;\n margin-bottom: 1.5rem;\n color: var(--text-light);\n cursor: pointer;\n font-weight: 500;\n transition: var(--transition);\n }\n\n .back-btn:hover {\n color: var(--accent-color);\n }\n\n .back-btn::before {\n content: '←';\n margin-right: 5px;\n font-size: 1.2rem;\n }\n\n .article-header {\n margin-bottom: 2rem;\n text-align: center;\n }\n\n .article-title {\n font-size: 2.5rem;\n margin-bottom: 1rem;\n color: var(--primary-color);\n }\n\n .article-cover {\n width: 100%;\n height: 400px;\n object-fit: cover;\n border-radius: var(--border-radius);\n margin-bottom: 2rem;\n box-shadow: var(--shadow);\n }\n\n .article-content {\n background: var(--card-bg);\n padding: 3rem;\n border-radius: var(--border-radius);\n box-shadow: var(--shadow);\n font-size: 1.1rem;\n line-height: 1.8;\n }\n\n .article-content p {\n margin-bottom: 1.5rem;\n }\n\n .article-content h2 {\n margin-top: 2rem;\n margin-bottom: 1rem;\n color: var(--primary-color);\n }\n\n /* --- 底部 --- */\n footer {\n background-color: var(--primary-color);\n color: #fff;\n text-align: center;\n padding: 2rem;\n margin-top: auto;\n }\n\n /* --- 动画 --- */\n @keyframes fadeIn {\n from { opacity: 0; transform: translateY(10px); }\n to { opacity: 1; transform: translateY(0); }\n }\n\n /* --- 响应式调整 --- */\n @media (max-width: 768px) {\n .nav-container {\n flex-direction: column;\n gap: 1rem;\n }\n \n .nav-links a {\n margin: 0 10px;\n }\n\n .article-title {\n font-size: 1.8rem;\n }\n\n .article-cover {\n height: 250px;\n }\n\n .article-content {\n padding: 1.5rem;\n }\n }\n \u003c/style\u003e\n\u003c/head\u003e\n\u003cbody\u003e\n\n \u003c!-- 导航栏 --\u003e\n \u003cheader\u003e\n \u003cdiv class=\"nav-container\"\u003e\n \u003ca href=\"#\" class=\"logo\" onclick=\"app.showHome()\"\u003eMyBlog\u003c/a\u003e\n \u003cnav class=\"nav-links\"\u003e\n \u003ca href=\"#\" onclick=\"app.showHome()\"\u003e首页\u003c/a\u003e\n \u003ca href=\"#\"\u003e关于我\u003c/a\u003e\n \u003ca href=\"#\"\u003e联系\u003c/a\u003e\n \u003c/nav\u003e\n \u003c/div\u003e\n \u003c/header\u003e\n\n \u003c!-- 主内容区 --\u003e\n \u003cmain\u003e\n \u003c!-- 1. 文章列表视图 --\u003e\n \u003csection id=\"list-view\" class=\"view-section active\"\u003e\n \u003ch1 class=\"page-title\"\u003e最新文章\u003c/h1\u003e\n \u003cdiv class=\"post-grid\" id=\"post-container\"\u003e\n \u003c!-- 文章卡片将通过 JS 插入这里 --\u003e\n \u003c/div\u003e\n \u003c/section\u003e\n\n \u003c!-- 2. 文章详情视图 --\u003e\n \u003csection id=\"detail-view\" class=\"view-section\"\u003e\n \u003cdiv class=\"back-btn\" onclick=\"app.showHome()\"\u003e返回列表\u003c/div\u003e\n \n \u003carticle id=\"article-container\"\u003e\n \u003c!-- 文章详情将通过 JS 插入这里 --\u003e\n \u003c/article\u003e\n \u003c/section\u003e\n \u003c/main\u003e\n\n \u003c!-- 页脚 --\u003e\n \u003cfooter\u003e\n \u003cp\u003e\u0026copy; 2023 My Personal Blog. All rights reserved.\u003c/p\u003e\n \u003cp style=\"font-size: 0.8rem; margin-top: 0.5rem; opacity: 0.7;\"\u003eDesigned with Native HTML/CSS/JS\u003c/p\u003e\n \u003c/footer\u003e\n\n \u003cscript\u003e\n // --- 模拟数据 ---\n const postsData = [\n {\n id: 1,\n title: \"探索现代 Web 开发的边界\",\n date: \"2023-10-24\",\n image: \"https://picsum.photos/id/1/800/600\",\n excerpt: \"随着技术的飞速发展,前端开发变得越来越复杂。本文将探讨如何在保持代码简洁的同时构建高性能应用。\",\n content: `\n \u003cp\u003eWeb 开发领域正在经历一场前所未有的变革。从简单的静态页面到复杂的单页应用(SPA),再到如今的服务器端渲染(SSR)和边缘计算,我们手中的工具越来越强大,但同时也带来了更多的挑战。\u003c/p\u003e\n \u003ch2\u003e性能优化的重要性\u003c/h2\u003e\n \u003cp\u003e在移动设备普及的今天,性能不再是锦上添花,而是生存之本。用户对于加载时间的容忍度极低。我们需要关注核心 Web 指标(Core Web Vitals),如 LCP、FID 和 CLS。\u003c/p\u003e\n \u003cp\u003e优化不仅仅是压缩代码,更包括合理的资源加载策略、图片优化以及高效的渲染路径。原生 JavaScript 的性能往往优于庞大的框架,因此在某些场景下,回归原生可能是一个明智的选择。\u003c/p\u003e\n \u003ch2\u003e保持代码的可维护性\u003c/h2\u003e\n \u003cp\u003e无论使用什么技术栈,代码的可读性和可维护性始终是关键。良好的命名规范、组件化设计以及清晰的文档,能让团队协作更加顺畅。\u003c/p\u003e\n \u003cp\u003eLorem ipsum dolor sit amet, consectetur adipiscing elit. Sed do eiusmod tempor incididunt ut labore et dolore magna aliqua. Ut enim ad minim veniam, quis nostrud exercitation ullamco laboris nisi ut aliquip ex ea commodo consequat.\u003c/p\u003e\n `\n },\n {\n id: 2,\n title: \"极简主义设计的艺术\",\n date: \"2023-10-18\",\n image: \"https://picsum.photos/id/20/800/600\",\n excerpt: \"少即是多。在信息过载的时代,极简设计不仅是一种美学选择,更是一种功能性的必需。\",\n content: `\n \u003cp\u003e极简主义(Minimalism)不仅仅意味着“少”,它意味着“恰到好处”。在设计中,每一个元素都应该有其存在的理由。多余的装饰会分散用户的注意力,降低信息的传递效率。\u003c/p\u003e\n \u003ch2\u003e留白的力量\u003c/h2\u003e\n \u003cp\u003e留白(White Space)是极简设计的核心。它不是浪费空间,而是为了突出内容,给用户的眼睛提供休息的区域。合理的留白能提升阅读体验,让页面看起来更加高端和精致。\u003c/p\u003e\n \u003cp\u003eDuis aute irure dolor in reprehenderit in voluptate velit esse cillum dolore eu fugiat nulla pariatur. Excepteur sint occaecat cupidatat non proident, sunt in culpa qui officia deserunt mollit anim id est laborum.\u003c/p\u003e\n \u003ch2\u003e色彩与排版\u003c/h2\u003e\n \u003cp\u003e在极简设计中,色彩通常被限制在少数几种,通常是一个主色调加上中性色。排版则成为了视觉的主角,字体的选择、大小、行高都至关重要。\u003c/p\u003e\n `\n },\n {\n id: 3,\n title: \"JavaScript 异步编程指南\",\n date: \"2023-10-10\",\n image: \"https://picsum.photos/id/48/800/600\",\n excerpt: \"从回调地狱到 Promise,再到 Async/Await,理解 JavaScript 的异步机制是成为高级开发者的必经之路。\",\n content: `\n \u003cp\u003eJavaScript 是单线程语言,这意味着它一次只能执行一个任务。为了处理耗时操作(如网络请求、文件读取),异步编程应运而生。\u003c/p\u003e\n \u003ch2\u003ePromises 的崛起\u003c/h2\u003e\n \u003cp\u003ePromise 对象代表一个异步操作的最终完成(或失败)及其结果值。它解决了回调地狱的问题,让代码逻辑更加清晰。我们可以使用 .then() 和 .catch() 来处理结果和错误。\u003c/p\u003e\n \u003cp\u003eUt enim ad minim veniam, quis nostrud exercitation ullamco laboris nisi ut aliquip ex ea commodo consequat. Duis aute irure dolor in reprehenderit in voluptate velit esse cillum dolore eu fugiat nulla pariatur.\u003c/p\u003e\n \u003ch2\u003eAsync/Await 的优雅\u003c/h2\u003e\n \u003cp\u003eAsync/Await 是基于 Promise 的语法糖,它让异步代码看起来像同步代码一样。这使得错误处理变得更加直观,可以使用 try/catch 块来捕获异常。\u003c/p\u003e\n `\n },\n {\n id: 4,\n title: \"CSS Grid 布局实战\",\n date: \"2023-09-28\",\n image: \"https://picsum.photos/id/60/800/600\",\n excerpt: \"告别浮动和定位,CSS Grid 带来了二维布局的革命。本文将通过实战案例展示 Grid 的强大之处。\",\n content: `\n \u003cp\u003eCSS Grid Layout 是 CSS 中最强大的布局系统。与 Flexbox(一维布局)不同,Grid 允许我们在行和列上同时控制元素的位置。\u003c/p\u003e\n \u003ch2\u003e基本概念\u003c/h2\u003e\n \u003cp\u003e要使用 Grid,首先需要将容器设置为 display: grid。然后,我们可以使用 grid-template-columns 和 grid-template-rows 来定义网格结构。\u003c/p\u003e\n \u003cp\u003eSed ut perspiciatis unde omnis iste natus error sit voluptatem accusantium doloremque laudantium, totam rem aperiam, eaque ipsa quae ab illo inventore veritatis et quasi architecto beatae vitae dicta sunt explicabo.\u003c/p\u003e\n \u003ch2\u003e响应式网格\u003c/h2\u003e\n \u003cp\u003eGrid 非常适合响应式设计。通过使用 auto-fit 和 minmax() 函数,我们可以轻松创建能够根据屏幕宽度自动调整列数的布局,而无需编写大量的媒体查询。\u003c/p\u003e\n `\n }\n ];\n\n // --- 应用程序逻辑 ---\n const app = {\n // 初始化\n init: function() {\n this.renderPostList();\n },\n\n // 渲染文章列表\n renderPostList: function() {\n const container = document.getElementById('post-container');\n container.innerHTML = ''; // 清空容器\n\n postsData.forEach(post =\u003e {\n const card = document.createElement('div');\n card.className = 'post-card';\n card.onclick = () =\u003e this.showDetail(post.id); // 绑定点击事件\n\n card.innerHTML = `\n \u003cimg src=\"${post.image}\" alt=\"${post.title}\" class=\"post-card-image\" loading=\"lazy\"\u003e\n \u003cdiv class=\"post-card-content\"\u003e\n \u003cdiv class=\"post-meta\"\u003e${post.date}\u003c/div\u003e\n \u003ch3 class=\"post-title\"\u003e${post.title}\u003c/h3\u003e\n \u003cp class=\"post-excerpt\"\u003e${post.excerpt}\u003c/p\u003e\n \u003cspan class=\"read-more\"\u003e阅读全文 →\u003c/span\u003e\n \u003c/div\u003e\n `;\n container.appendChild(card);\n });\n },\n\n // 渲染文章详情\n showDetail: function(id) {\n const post = postsData.find(p =\u003e p.id === id);\n if (!post) return;\n\n const container = document.getElementById('article-container');\n \n // 构建详情 HTML\n container.innerHTML = `\n \u003cheader class=\"article-header\"\u003e\n \u003ch1 class=\"article-title\"\u003e${post.title}\u003c/h1\u003e\n \u003cdiv class=\"post-meta\" style=\"font-size: 1rem;\"\u003e发布于 ${post.date}\u003c/div\u003e\n \u003c/header\u003e\n \u003cimg src=\"${post.image}\" alt=\"${post.title}\" class=\"article-cover\"\u003e\n \u003cdiv class=\"article-content\"\u003e\n ${post.content}\n \u003c/div\u003e\n `;\n\n // 切换视图\n this.switchView('detail');\n // 滚动到顶部\n window.scrollTo(0, 0);\n },\n\n // 返回首页\n showHome: function() {\n this.switchView('list');\n window.scrollTo(0, 0);\n },\n\n // 视图切换逻辑\n switchView: function(viewName) {\n const listView = document.getElementById('list-view');\n const detailView = document.getElementById('detail-view');\n\n if (viewName === 'list') {\n listView.classList.add('active');\n detailView.classList.remove('active');\n } else {\n listView.classList.remove('active');\n detailView.classList.add('active');\n }\n }\n };\n\n // 启动应用\n document.addEventListener('DOMContentLoaded', () =\u003e {\n app.init();\n });\n \u003c/script\u003e\n\u003c/body\u003e\n\u003c/html\u003e\n```\n\n### 代码说明:\n\n1. **HTML 结构**:\n * 页面分为 `header`(导航)、`main`(内容)和 `footer`(页脚)。\n * `main` 标签内包含两个主要的 `section`:`#list-view`(文章列表)和 `#detail-view`(文章详情)。通过 CSS 类 `.active` 来控制哪个视图显示。\n2. **CSS 样式**:\n * 使用了 CSS 变量 (`:root`) 来管理颜色,方便统一修改主题。\n * 使用了 **CSS Grid** (`display: grid`) 来实现文章列表的响应式布局,自动适应屏幕宽度。\n * 使用了 **Flexbox** 来处理导航栏和卡片内部的布局。\n * 添加了简单的 `@keyframes` 动画,使视图切换更加平滑。\n * 包含了针对移动端的媒体查询 (`@media`),确保在手机上也美观。\n3. **JavaScript 逻辑**:\n * **数据模拟**: 创建了一个 `postsData` 数组,包含文章的 ID、标题、日期、图片 URL、摘要和详细内容。\n * **状态管理**: 定义了一个 `app` 对象来封装逻辑。\n * **渲染函数**:\n * `renderPostList()`: 遍历数据数组,动态生成 HTML 卡片并插入页面。\n * `showDetail(id)`: 根据 ID 查找对应文章,生成详情页 HTML,并切换到详情视图。\n * **视图切换**: `switchView()` 函数通过添加/移除 CSS 类来隐藏或显示不同的 section,实现了类似单页应用(SPA)的效果,无需刷新页面。" } ] ``` ## 四、Go-cache缓存优化 在上一节中,我们实现了基本的Agent工厂模式,每次调用 `GetCodeGenAgent` 都会创建一个新的Agent实例。但在实际生产环境中,这会带来严重的性能问题。本节将详细说明如何使用 **go-cache** 库优化Agent实例的管理。 ### 为什么需要缓存优化? #### 问题场景:无缓存时的性能瓶颈 假设我的网站每分钟有100个用户同时对话: ``` 每分钟的请求: 100个用户 × 每人发送1条消息 = 100次调用 GetCodeGenAgent 每次调用: 1. 创建 RedisMemoryStore(分配内存、初始化连接) 2. 创建 CodeGenAgent(分配内存、初始化字段) 3. 配置 Redis Key、TTL等参数 耗时: 创建 RedisMemoryStore:~1ms 创建 CodeGenAgent:~0.5ms 总耗时:~1.5ms 每分钟总耗时: 100次 × 1.5ms = 150ms 看起来不多?但考虑以下问题: ``` **问题1:内存泄漏** ``` 每次创建新的Agent实例: Agent实例大小:~2KB(包含字段、指针等) 每分钟创建: 100个实例 × 2KB = 200KB 每小时: 200KB × 60 = 12MB 每天: 12MB × 24 = 288MB 如果不释放,内存会持续增长! ``` **问题2:GC压力** ``` 频繁创建和销毁对象: → 增加垃圾回收器的负担 → 导致GC停顿时间变长 → 影响整体性能 ``` ### 解决方案:使用go-cache缓存Agent实例 **核心思想:** > 对于同一个应用的同一个代码生成类型,Agent实例是可以复用的。因为Agent本身是无状态的,状态存储在Redis中。 ### go-cache库介绍 **go-cache** 是一个纯Go实现的内存缓存库,特点: | 特性 | 说明 | | ------------------ | ----------------------- | | **自动过期** | 支持TTL,过期自动删除 | | **LRU淘汰** | 支持自定义淘汰策略 | | **线程安全** | 内置锁,并发安全 | | **简单易用** | API简洁,Set/Get/Delete | **安装:** ```bash go get github.com/patrickmn/go-cache ``` **基本用法:** ```go import "github.com/patrickmn/go-cache" // 创建缓存,默认过期时间30分钟,清理间隔10分钟 c := cache.New(30*time.Minute, 10*time.Minute) // 设置缓存 c.Set("key", value, cache.DefaultExpiration) // 获取缓存 if x, found := c.Get("key"); found { value := x.(MyType) } // 删除缓存 c.Delete("key") ``` ### 完整的缓存优化实现 下面是对于缓存每个逻辑步骤的详细讲解,最后我提供了完整的修改内容 #### 全局缓存和实例计数 ```go package agent import ( "github.com/patrickmn/go-cache" "github.com/redis/go-redis/v9" "strconv" "sync" "time" "yikou-ai-go-teach/internal/ai/llm" "yikou-ai-go-teach/internal/service" "yikou-ai-go-teach/internal/store" "yikou-ai-go-teach/pkg/enum" ) // MaxAgentInstances 最大Agent实例数量 const MaxAgentInstances = 1000 var ( // serviceCache 全局缓存,存储Agent实例 // 默认过期时间:30分钟 // 清理间隔:10分钟 serviceCache = cache.New(30*time.Minute, 10*time.Minute) // instanceCount 当前实例数量 instanceCount int // instanceCountMu 实例计数锁(并发安全) instanceCountMu sync.Mutex ) ``` #### 工厂结构体定义 ```go type CodeGenAgentFactory struct { chatModel *llm.ChatModelWrapper redisClient *redis.Client chatHistoryService service.IChatHistoryService } func NewCodeGenAgentFactory( chatModel *llm.ChatModelWrapper, redisClient *redis.Client, chatHistoryService service.IChatHistoryService, ) *CodeGenAgentFactory { // 注册淘汰回调,记录日志 serviceCache.OnEvicted(func(k string, v interface{}) { logger.Debugf("AI服务实例被移除,缓冲键: %v", k) }) return &CodeGenAgentFactory{ chatModel: chatModel, redisClient: redisClient, chatHistoryService: chatHistoryService, } } ``` #### 缓存Key构建 ```go // buildCacheKey 构建缓存Key // 格式:{appId}_{codeGenType} // 示例:100_HtmlCodeGen, 200_MultiFileGen func buildCacheKey(appId int64, codeGenType enum.CodeGenTypeEnum) string { return strconv.Itoa(int(appId)) + "_" + string(codeGenType) } ``` #### LRU淘汰策略 当缓存实例数达到上限时,需要淘汰最老的实例: ```go // evictOldest 淘汰最老的缓存项(LRU策略) func (c CodeGenAgentFactory) evictOldest() { items := serviceCache.Items() oldestKey := "" var oldestExpiration int64 // 遍历所有缓存项,找到过期时间最早的 for k, item := range items { if item.Expiration == 0 { continue // 永不过期的项,跳过 } if oldestKey == "" || item.Expiration < oldestExpiration { oldestExpiration = item.Expiration oldestKey = k } } // 删除最老的项 if oldestKey != "" { serviceCache.Delete(oldestKey) instanceCountMu.Lock() instanceCount-- instanceCountMu.Unlock() } } ``` **LRU(Least Recently Used)策略:** ``` 假设缓存已满(1000个实例): 当前缓存项: Key1: 过期时间 10:00 Key2: 过期时间 10:05 Key3: 过期时间 10:10 ... 淘汰策略: 找到过期时间最早的 → Key1 删除 Key1 释放一个位置 新实例: 创建新的Agent实例 放入缓存 ``` #### 核心方法:GetCodeGenAgent ```go func (c CodeGenAgentFactory) GetCodeGenAgent( appId int64, codeGenType enum.CodeGenTypeEnum, ) (*CodeGenAgent, error) { redisStore := store.NewRedisMemoryStore( c.redisClient, strconv.Itoa(int(appId)), 20, 24*time.Hour, ) // 1. 构建缓存Key key := buildCacheKey(appId, codeGenType) // 2. 尝试从缓存获取 if agent, found := serviceCache.Get(key); found { // 缓存命中,直接返回 return agent.(*CodeGenAgent), nil } // 3. 缓存未命中,检查实例数量 instanceCountMu.Lock() if instanceCount >= MaxAgentInstances { // 达到上限,淘汰最老的实例 c.evictOldest() } instanceCountMu.Unlock() // 4. 创建新的Agent实例 agent := NewCodeGenAgent(c.chatModel, codeGenType, redisStore) // 5. 放入缓存 serviceCache.Set(key, agent, cache.DefaultExpiration) // 6. 更新实例计数 instanceCountMu.Lock() instanceCount++ instanceCountMu.Unlock() return agent, nil } ``` ### 性能对比分析 #### 无缓存 vs 有缓存 **场景:同一应用,连续100次调用** ``` 无缓存: 每次调用: 创建 RedisMemoryStore: 1ms 创建 CodeGenAgent: 0.5ms 总耗时: 1.5ms 100次调用: 总耗时: 100 × 1.5ms = 150ms 创建实例数: 100个 内存占用: 100 × 2KB = 200KB 有缓存: 第1次调用: 缓存未命中 创建实例: 1.5ms 放入缓存: 0.1ms 总耗时: 1.6ms 第2-100次调用: 缓存命中 查缓存: 0.01ms 总耗时: 0.01ms 100次调用: 总耗时: 1.6ms + 99 × 0.01ms = 2.59ms 创建实例数: 1个 内存占用: 1 × 2KB = 2KB 性能提升: 耗时:150ms → 2.59ms(快58倍) 实例数:100 → 1(减少99%) 内存:200KB → 2KB(减少99%) ``` ### 并发安全性分析 #### 多个请求同时调用GetCodeGenAgent ``` 请求1: GetCodeGenAgent(100, HtmlCodeGen) 请求2: GetCodeGenAgent(100, HtmlCodeGen) ← 同时到达 请求3: GetCodeGenAgent(200, HtmlCodeGen) 可能的竞态条件: 请求1和请求2同时发现缓存未命中 → 都创建新的Agent实例 → 都尝试放入缓存 → 重复创建 ``` **解决方案:instanceCountMu互斥锁** ```go instanceCountMu.Lock() if instanceCount >= MaxAgentInstances { c.evictOldest() } instanceCountMu.Unlock() ``` **注意:这里的锁只保护实例计数,不保护缓存操作** go-cache内部已经实现了线程安全: ```go // go-cache源码(简化) func (c *cache) Set(k string, x interface{}, d time.Duration) { c.mu.Lock() // 内部锁 // ... 设置操作 c.mu.Unlock() } func (c *cache) Get(k string) (interface{}, bool) { c.mu.Lock() // 内部锁 // ... 获取操作 c.mu.Unlock() } ``` ### 完整代码 ```go package agent import ( "github.com/bytedance/gopkg/util/logger" "github.com/patrickmn/go-cache" "github.com/redis/go-redis/v9" "strconv" "sync" "time" "yikou-ai-go-teach/internal/ai/llm" "yikou-ai-go-teach/internal/service" "yikou-ai-go-teach/internal/store" "yikou-ai-go-teach/pkg/enum" ) const MaxAgentInstances = 1000 var ( serviceCache = cache.New(30*time.Minute, 10*time.Minute) instanceCount int instanceCountMu sync.Mutex ) type CodeGenAgentFactory struct { chatModel *llm.ChatModelWrapper redisClient *redis.Client chatHistoryService service.IChatHistoryService } func NewCodeGenAgentFactory( chatModel *llm.ChatModelWrapper, redisClient *redis.Client, chatHistoryService service.IChatHistoryService, ) *CodeGenAgentFactory { serviceCache.OnEvicted(func(k string, v interface{}) { logger.Debugf("AI服务实例被移除,缓冲键: %v", k) }) return &CodeGenAgentFactory{ chatModel: chatModel, redisClient: redisClient, chatHistoryService: chatHistoryService, } } func (c CodeGenAgentFactory) evictOldest() { items := serviceCache.Items() oldestKey := "" var oldestExpiration int64 for k, item := range items { if item.Expiration == 0 { continue } if oldestKey == "" || item.Expiration < oldestExpiration { oldestExpiration = item.Expiration oldestKey = k } } if oldestKey != "" { serviceCache.Delete(oldestKey) instanceCountMu.Lock() instanceCount-- instanceCountMu.Unlock() } } func buildCacheKey(appId int64, codeGenType enum.CodeGenTypeEnum) string { return strconv.Itoa(int(appId)) + "_" + string(codeGenType) } func (c CodeGenAgentFactory) GetCodeGenAgent(appId int64, codeGenType enum.CodeGenTypeEnum) (*CodeGenAgent, error) { redisStore := store.NewRedisMemoryStore(c.redisClient, strconv.Itoa(int(appId)), 20, 24*time.Hour) key := buildCacheKey(appId, codeGenType) // 查缓存 if agent, found := serviceCache.Get(key); found { return agent.(*CodeGenAgent), nil } // 检查实例数 instanceCountMu.Lock() if instanceCount >= MaxAgentInstances { c.evictOldest() } instanceCountMu.Unlock() // 创建新实例 agent := NewCodeGenAgent(c.chatModel, codeGenType, redisStore) // 放入缓存 serviceCache.Set(key, agent, cache.DefaultExpiration) // 更新计数 instanceCountMu.Lock() instanceCount++ instanceCountMu.Unlock() return agent, nil } ``` ## 五、加载对话历史到Eino智能体的对话记忆中 在前面的章节中,我们实现了对话历史的MySQL持久化和Eino对话记忆的Redis存储。但存在一个关键问题:**如果Redis数据丢失(重启、过期、故障),对话记忆如何恢复?** 本节将详细说明如何从MySQL加载对话历史到Eino智能体的对话记忆中,实现**容灾恢复**和**冷启动优化**。 ### 为什么需要加载历史到记忆? **问题场景:Redis数据丢失** ``` 场景1:TTL过期 24小时未使用应用 → Redis Key过期被删除 用户重新使用应用 → AI从零开始 → 丢失之前的对话背景 场景2:Redis故障 Redis服务宕机 → 无法读取对话记忆 降级处理 → AI无历史上下文 → 体验下降 ``` **解决方案:从MySQL恢复到Redis** ### Service接口新增方法 **文件位置:** `internal/service/chat_history_service.go` ```go type IChatHistoryService interface { AddChatMessage(ctx context.Context, appId int64, message string, messageType enum.ChatHistoryMessageTypeEnum, userId int64) error DeleteByAppId(ctx context.Context, appId int64) error ListAppChatHistoryByPage(ctx context.Context, appId int64, pageSize int32, lastCreateTime time.Time, loginUser *vo.UserVo) (*response.PageResponse[*model.ChatHistory], error) ListAllChatHistoryByPageForAdmin(ctx context.Context, pageNum int32, pageSize int32, queryRequest *api.YiKouChatHistoryQueryRequest) (*response.PageResponse[*model.ChatHistory], error) LoadChatHistoryToMemory(ctx context.Context, appId int64, memoryStore store.MemoryStore, maxCount int) (int, error) } ``` ### Logic层实现 **文件位置:** `internal/logic/chat_history_logic.go` ```go func (s *ChatHistoryService) LoadChatHistoryToMemory( ctx context.Context, appId int64, memoryStore store.MemoryStore, maxCount int, ) (int, error) { // 1. 查询摘要消息(如果有) historySummary, err := query.Use(s.db).ChatHistory. Where( query.ChatHistory.AppID.Eq(appId), query.ChatHistory.MessageType.Eq(string(enum.SummaryMessageType)), ). Order(query.ChatHistory.CreateTime.Desc()). Limit(maxCount). Find() var historyList []*model.ChatHistory // 2. 根据摘要情况决定加载策略 if err != nil && historySummary == nil { // 2.1 无摘要:加载最近的对话历史 historyList, err = query.Use(s.db).ChatHistory. Where(query.ChatHistory.AppID.Eq(appId)). Order(query.ChatHistory.CreateTime.Desc()). Limit(maxCount). Find() if err != nil { return 0, err } // 排除第一条(因为第一条是当前正在进行的对话) if len(historyList) > 1 { historyList = historyList[1:] } } else { // 2.2 有摘要:只加载摘要消息 historyList = historySummary } // 3. 清空MemoryStore(避免重复) err = memoryStore.ClearMessages(ctx) if err != nil { return 0, err } // 4. 按时间正序添加消息(从旧到新) loadedCount := 0 for i := len(historyList) - 1; i >= 0; i-- { history := historyList[i] // 根据消息类型创建不同的Message if history.MessageType == string(enum.UserMessageType) { err = memoryStore.AppendMessage(ctx, schema.UserMessage(history.Message)) if err != nil { return loadedCount, err } loadedCount++ } else if history.MessageType == string(enum.AIMessageType) { err = memoryStore.AppendMessage(ctx, schema.AssistantMessage(history.Message, nil)) if err != nil { return loadedCount, err } loadedCount++ } else if history.MessageType == string(enum.SummaryMessageType) { err = memoryStore.AppendMessage(ctx, schema.SystemMessage(history.Message)) if err != nil { return loadedCount, err } loadedCount++ } } return loadedCount, nil } ``` ### 修改Factory获取agent方法 **文件位置:** `internal/ai/agent/codegen_agent_factory.go` ```go func (c CodeGenAgentFactory) GetCodeGenAgent( appId int64, codeGenType enum.CodeGenTypeEnum, ) (*CodeGenAgent, error) { // 1. 创建RedisMemoryStore redisStore := store.NewRedisMemoryStore( c.redisClient, strconv.Itoa(int(appId)), 20, 24*time.Hour, ) // 2. 新增:从MySQL加载对话历史到Redis _, err := c.chatHistoryService.LoadChatHistoryToMemory( context.Background(), appId, redisStore, 20, ) if err != nil { return nil, err } if err != nil { return nil, err } // 3. 构建缓存Key key := buildCacheKey(appId, codeGenType) // 4. 尝试从缓存获取 if agent, found := serviceCache.Get(key); found { return agent.(*CodeGenAgent), nil } // 5. 检查实例数量 instanceCountMu.Lock() if instanceCount >= MaxAgentInstances { c.evictOldest() } instanceCountMu.Unlock() // 6. 创建CodeGenAgent agent := NewCodeGenAgent(c.chatModel, codeGenType, redisStore) // 7. 放入缓存 serviceCache.Set(key, agent, cache.DefaultExpiration) // 8. 更新计数 instanceCountMu.Lock() instanceCount++ instanceCountMu.Unlock() return agent, nil } ``` ### 重新测试 若Redis之前还保留着对话记忆,你可以直接删除键值对,然后重新询问智能体你还记得我刚刚要求你干什么吗,测试是否能回答出  可以看出来,加载对话历史的功能成功 ## 六、使用Redis优化用户登录功能 在对话历史模块中,我们使用Redis作为对话记忆的存储介质。为了保持技术栈的一致性,本节将用户登录功能也迁移到Redis,实现统一的会话管理方案。 ### 为什么使用Redis存储用户登录状态? #### 传统Session方案的问题 ```go // 全局map存储session var sessions = make(map[string]*User) func Login(user *User) string { sessionId := generateSessionId() sessions[sessionId] = user // 存储在内存中 return sessionId } ``` **问题:** - **单机限制**:无法支持多实例部署 - **重启丢失**:服务重启后所有用户需要重新登录 - **内存泄漏**:长时间运行可能导致内存溢出 - **无法共享**:多个服务实例无法共享session #### Redis方案的优势 1. **高性能**:Redis基于内存,读写速度极快(微秒级) 2. **自动过期**:TTL机制自动清理过期session,无需手动维护 3. **分布式支持**:多个服务实例共享同一个Redis,实现分布式session 4. **持久化**:Redis支持RDB/AOF持久化,重启不丢失数据 5. **高可用**:支持主从复制、哨兵、集群模式 ### Service 层修改 **文件位置:** `internal/logic/user_logic.go` #### UserService 结构体修改 注入 `redisClient` 依赖: ```go type UserService struct { db *gorm.DB redisClient *redis.Client // ← 新增:Redis客户端 } func NewUserService(db *gorm.DB, redisClient *redis.Client) *UserService { return &UserService{ db: db, redisClient: redisClient, } } ``` #### UserLogin 方法:用户登录 **功能说明:** 用户登录成功后,将用户信息存入Redis,并返回sessionId。 **完整代码:** ```go func (s *UserService) UserLogin(ctx context.Context, req *api.YiKouUserLoginRequest, c *app.RequestContext) (vo.UserVo, error) { // 1. 校验参数 if req.UserAccount == "" || req.UserPassword == "" { return vo.UserVo{}, errorutil.ParamsError } // 2. 校验用户是否存在 user, err := query.Use(s.db).User.Where(query.User.UserAccount.Eq(req.UserAccount)).First() if err != nil { return vo.UserVo{}, err } // 3. 校验密码是否正确 encryptPassword := s.GetEncryptPassword(ctx, req.UserPassword) if user.UserPassword != encryptPassword { return vo.UserVo{}, errorutil.ParamsError.WithMessage("密码错误") } // 4. 生成 sessionId sessionId := fmt.Sprintf("session:%d", time.Now().UnixNano()) // 关键步骤:将用户信息转换为json并存入Redis userJson, err := json.Marshal(user) if err != nil { return vo.UserVo{}, err } err = s.redisClient.Set(ctx, sessionId, string(userJson), 24*time.Hour).Err() if err != nil { return vo.UserVo{}, err } // 6. 保存sessionId到cookie c.SetCookie(constants.UserLoginState, sessionId, 86400, "/", "", protocol.CookieSameSiteLaxMode, false, true) // 7. 构建userVo对象 loginUserVo := vo.UserVo{ ID: user.ID, UserAccount: user.UserAccount, UserName: user.UserName, UserAvatar: user.UserAvatar, UserProfile: user.UserProfile, UserRole: user.UserRole, CreateTime: user.CreateTime, UpdateTime: user.UpdateTime, } return loginUserVo, nil } ``` #### GetLoginUserVo 方法:获取登录用户信息 **功能说明:** 从Redis中获取当前登录用户的详细信息。 **完整代码:** ```go func (s *UserService) GetLoginUserVo(ctx context.Context, c *app.RequestContext) (vo.UserVo, error) { // 1. 获取sessionId(从Cookie中) sessionId := c.Request.Header.Cookie(constants.UserLoginState) if sessionId == nil { return vo.UserVo{}, errorutil.ParamsError } // 2. URL解码sessionId decodedSessionId, err := url.QueryUnescape(string(sessionId)) if err != nil { return vo.UserVo{}, err } // 关键步骤:从Redis获取用户信息 userJson, err := s.redisClient.Get(ctx, decodedSessionId).Result() if err != nil { return vo.UserVo{}, errorutil.ParamsError.WithMessage("登录已过期,请重新登录") } // 4. 反序列化用户信息 var user model.User err = json.Unmarshal([]byte(userJson), &user) if err != nil { return vo.UserVo{}, err } // 5. 校验用户是否存在(双重校验) _, err = query.Use(s.db).User.Where(query.User.ID.Eq(user.ID), query.User.IsDelete.Eq(0)).First() if err != nil { return vo.UserVo{}, err } // 6. 构建 UserVo loginUserVo := vo.UserVo{ ID: user.ID, UserAccount: user.UserAccount, UserName: user.UserName, UserAvatar: user.UserAvatar, UserProfile: user.UserProfile, UserRole: user.UserRole, CreateTime: user.CreateTime, UpdateTime: user.UpdateTime, } return loginUserVo, nil } ``` #### Logout 方法:用户登出 **功能说明:** 从Redis中删除用户session,实现登出功能。 **完整代码:** ```go func (s *UserService) Logout(ctx context.Context, c *app.RequestContext) error { // 1. 获取sessionId sessionId := c.Request.Header.Cookie(constants.UserLoginState) if sessionId == nil { return errorutil.ParamsError.WithMessage("用户未登录") } // 2. URL解码sessionId decodedSessionId, err := url.QueryUnescape(string(sessionId)) if err != nil { return err } // 关键步骤:从Redis删除session _ = s.redisClient.Del(ctx, decodedSessionId).Err() // 4. 清除Cookie c.SetCookie(constants.UserLoginState, "", 0, "/", "", protocol.CookieSameSiteLaxMode, false, true) return nil } ``` ### Middleware修改 **文件位置:** `internal/middleware/auth.go` #### AuthMiddleware 函数修改 注入 `redisClient` 参数,从Redis获取用户信息进行鉴权。 **完整代码:** ```go // AuthMiddleware 鉴权中间件 func AuthMiddleware(roleEnum enum.UserRoleEnum, db *gorm.DB, redisClient *redis.Client) app.HandlerFunc { return func(ctx context.Context, c *app.RequestContext) { // 1. 校验权限 var decodeUser []byte if roleEnum != "" { // 2. 获取sessionId(从Cookie中) sessionId := c.Request.Header.Cookie(constants.UserLoginState) if sessionId == nil { c.JSON(200, errorutil.NotLoginError) c.Abort() return } // 3. URL解码sessionId decodedSessionId, err := url.QueryUnescape(string(sessionId)) if err != nil { c.JSON(200, errorutil.NotAuthError) c.Abort() return } // 关键步骤:从Redis获取用户信息 userJsonStr, err := redisClient.Get(ctx, decodedSessionId).Result() if err != nil { c.JSON(200, errorutil.NotLoginError.WithMessage("登录已过期,请重新登录")) c.Abort() return } decodeUser = []byte(userJsonStr) } // 5. 解析用户信息 var user model.User err := json.Unmarshal(decodeUser, &user) if err != nil { c.JSON(200, errorutil.SystemError.WithMessage(err.Error())) c.Abort() return } // 6. 校验用户权限等级是否符合要求 dbUser, err := query.Use(db).User.Where(query.User.ID.Eq(user.ID), query.User.IsDelete.Eq(0)).First() if err != nil { c.JSON(200, errorutil.NotAuthError) c.Abort() return } // 7. 校验角色权限 if roleEnum == enum.AdminRole && enum.UserRoleEnum(dbUser.UserRole) != roleEnum { c.JSON(200, errorutil.NotAuthError) c.Abort() return } c.Next(ctx) } } ``` ### Router 层修改 **文件位置:** `internal/router/router.go` #### RegisterRoutes 函数修改 在路由注册函数中注入 `redisClient` 参数,并传递给中间件。 **完整代码:** ```go // RegisterRoutes 注册路由 func RegisterRoutes(h *server.Hertz, url func(config *swagger.Config), db *gorm.DB, redisClient *redis.Client, userHandler *handler.UserHandler, appHandler *handler.AppHandler, chatHistoryHandler *handler.ChatHistoryHandler) { // 注册全局中间件 // 处理跨域问题 h.Use(cors.New(cors.Config{ AllowAllOrigins: true, AllowMethods: []string{"GET", "POST", "PUT", "DELETE", "OPTIONS"}, AllowHeaders: []string{"Origin", "Content-Type", "Authorization"}, ExposeHeaders: []string{"Content-Length"}, AllowCredentials: false, MaxAge: 12 * time.Hour, })) // 全局异常处理 h.Use(recovery.Recovery(recovery.WithRecoveryHandler(CustomRecoveryHandler))) // 测试接口 h.GET("/ping", handler.Ping) // swaggo文档 h.GET("/swagger/*any", swagger.WrapHandler(swaggerFiles.Handler, url)) userRoute := h.Group("/user") { userRoute.POST("/register", userHandler.UserRegister) userRoute.POST("/login", userHandler.UserLogin) userRoute.GET("/get/vo", userHandler.GetUserVo) // 需要登录的接口(传递redisClient) userRoute.GET("/get/login", middleware.AuthMiddleware(enum.UserRole, db, redisClient), userHandler.GetLoginUser) userRoute.POST("/logout", middleware.AuthMiddleware(enum.UserRole, db, redisClient), userHandler.Logout) // 需要管理员权限的接口(传递redisClient) userRoute.POST("/add", middleware.AuthMiddleware(enum.AdminRole, db, redisClient), userHandler.AddUser) userRoute.GET("/get", middleware.AuthMiddleware(enum.AdminRole, db, redisClient), userHandler.GetUser) userRoute.POST("/delete", middleware.AuthMiddleware(enum.AdminRole, db, redisClient), userHandler.DeleteUser) userRoute.POST("/update", middleware.AuthMiddleware(enum.AdminRole, db, redisClient), userHandler.UpdateUser) userRoute.POST("/list/page/vo", middleware.AuthMiddleware(enum.AdminRole, db, redisClient), userHandler.ListUserVoByPage) } appRoute := h.Group("/app") { appRoute.POST("/good/list/page/vo", appHandler.ListGoodApp) appRoute.GET("/get/vo", middleware.AuthMiddleware(enum.UserRole, db, redisClient), appHandler.GetAppVo) // 需要登录的接口(传递redisClient) appRoute.GET("/chat/gen/code", middleware.AuthMiddleware(enum.UserRole, db, redisClient), appHandler.ChatToGenCode) appRoute.POST("/my/list/page/vo", middleware.AuthMiddleware(enum.UserRole, db, redisClient), appHandler.ListMyApp) appRoute.POST("/add", middleware.AuthMiddleware(enum.UserRole, db, redisClient), appHandler.AddApp) appRoute.POST("/update", middleware.AuthMiddleware(enum.UserRole, db, redisClient), appHandler.UpdateApp) appRoute.POST("/delete", middleware.AuthMiddleware(enum.UserRole, db, redisClient), appHandler.DeleteApp) // 需要管理员权限的接口(传递redisClient) appRoute.POST("/admin/update", middleware.AuthMiddleware(enum.AdminRole, db, redisClient), appHandler.AdminUpdateApp) appRoute.POST("/admin/delete", middleware.AuthMiddleware(enum.AdminRole, db, redisClient), appHandler.AdminDeleteApp) appRoute.GET("/admin/get/vo", middleware.AuthMiddleware(enum.AdminRole, db, redisClient), appHandler.AdminGetAppVo) appRoute.POST("/admin/list/page/vo", middleware.AuthMiddleware(enum.AdminRole, db, redisClient), appHandler.AdminListApp) } // 聊天历史路由 chatHistoryRoute := h.Group("/chatHistory") { // 需要管理员权限的接口(传递redisClient) chatHistoryRoute.POST("/admin/list/page/vo", middleware.AuthMiddleware(enum.AdminRole, db, redisClient), chatHistoryHandler.ListAllChatHistoryByPageForAdmin) chatHistoryRoute.GET("/app/:appId", middleware.AuthMiddleware(enum.UserRole, db, redisClient), chatHistoryHandler.ListAppChatHistory) } } ``` ### Wire 依赖注入修改 **文件位置:** `wire/wire.go` ```go // initServer 初始化 Web 服务器 func initServer(cfg *config.Config, userHandler *handler.UserHandler, appHandler *handler.AppHandler, db *gorm.DB, redisClient *redis.Client, chatHistoryHandler *handler.ChatHistoryHandler) *server.Hertz { // 动态设置 Swagger 信息 docs.SwaggerInfo.Host = fmt.Sprintf("localhost:%d", cfg.Server.Port) docs.SwaggerInfo.BasePath = cfg.Server.ContextPath // 初始化swagger路径 swaggerPath := fmt.Sprintf("http://localhost:%d%s/swagger/doc.json", cfg.Server.Port, cfg.Server.ContextPath) url := swagger.URL(swaggerPath) // 创建 Hertz 服务器 h := server.Default( server.WithHostPorts(":"+strconv.Itoa(cfg.Server.Port)), server.WithBasePath(cfg.Server.ContextPath), ) // 注册路由 router.RegisterRoutes(h, url, db, redisClient, userHandler, appHandler, chatHistoryHandler) return h } ``` **在wire目录下执行生成命令** ```bash cd wire wire ``` 到这里,本章的教学内容就结束,这一章的内容量特别大,希望各位读者能好好消化。下一章我会增加难度,讲解如何实现智能体生成vue工程化项目代码。要是对该教程感兴趣的,可以star一下仓库 [https://github.com/FeiWuSama/yikou-ai-go](https://github.com/FeiWuSama/yikou-ai-go) 给予博主更多支持哦,谢谢各位看到这里的读者!
从零构建在线Excel:一个Java全栈工程师的实战记录
# 从零构建在线Excel:一个Java全栈工程师的实战记录 ## 我为什么要自己造这个轮子 说出来你可能不信,起因是公司内部一堆Excel文件满天飞。 财务部的预算表、运营部的数据看板、产品部的需求矩阵——每一次改一个数,就要在微信上重新传一遍文件。文件名从"最终版"进化到"最终最终版"再到"打死也不改了版",像极了程序员给变量起名。 市面上不是没有在线表格产品,腾讯文档、飞书表格都挺好用。但公司内网环境不允许直连外部服务,数据又不能出内网。私有化部署的那些方案,要么贵得离谱,要么定制成本太高。 于是我决定自己动手。一个全栈工程师的自我修养,不就是"没人做我来做"吗? 项目地址:https://github.com/DevYangJC/DataLoom **希望大家给给star,给我增加更新的动力,谢谢大家**   ## 不止是我用:这个项目给你的价值 要说清楚这件事——我不是在做一个"我的项目",我是在做一个"你也能用的零件"。 大多数技术教程里的项目,你照着写完就跑不起来了。要么跟作者的数据库强绑定,要么前端和后端耦合得像连体婴儿,要么硬编码了一堆作者公司才有的配置。说白了,那些代码离开作者的电脑就是个摆设。 DataLoom 从一开始就被设计成**可移植的**。什么意思?就是当你自己的项目需要一个在线表格功能时,你能把这个项目直接复制粘贴进去,改改配置就能跑,不用从零攻坚。 具体来说,我刻意做了这么几件事: **前端是一个独立的 SPA 应用。** 它不依赖特定的后端框架,跟后端只通过 REST API 通信。你后端是 Spring Boot、Go、Node,甚至 Python Flask,都无所谓——把 `excel-web-demo/src` 目录往你项目里一扔,配个 API 代理就行。前端不认后端是谁,只认 `/api/excel` 这个前缀。 **后端是一个独立的微服务。** 它有自己的端口(9191)、自己的数据库(H2),不跟你现有的业务代码搅在一起。你甚至不需要碰它的 Java 代码——启动一个 JAR 包,在线表格能力就有了。等业务量大了想替换掉 H2,改一行 `application.yml` 的数据库配置,MyBatis-Plus 自动适配,SQL 一行不用改。 **数据模型解耦干净。** 文档、Sheet、数据块三张表之间只用外键关联,不写存储过程、不依赖触发器、不用数据库专有特性。换成任何关系型数据库都只要建三张表,改改连接串就行。 **启动链路就是一个 shell 脚本的事。** 后端 `mvn spring-boot:run`,前端 `npm run dev`。如果打包成 Docker,就是一个 `docker-compose.yml`,两行 `services` 搞定。你的团队成员 clone 下来,两分钟之内就能在本地跑到"上传 → 编辑 → 导出"的完整闭环。 说白了,**DataLoom 不是你照着学的玩具项目,是你抄来就用的功能模块。** 你项目的管理后台缺一个数据看板?把一个 Excel 当模板上传进去,线上改数据、导出报表,直接搞定。你自己的 SaaS 产品需要给客户提供表格编辑能力?把这两个目录放进你的微服务集群,注册个域名,齐活。 后面讲的技术细节——分块存储、脏数据追踪、前端导出——都是在保证"能用"的前提下,做到"好用"。但"能用"这件事,在架构设计阶段就已经写死进去了。 ## 技术选型:少即是多 需求其实很明确:上传Excel → 在线编辑 → 导出Excel。听起来简单,但细节全是坑。 **前端**,Vue 3 + Vite + Element Plus。Vue 3的Composition API是这次选型里我最满意的决定——`<script setup>`语法写起来比Options API清爽太多了,逻辑拆成独立函数,不用再在`data`、`methods`、`computed`之间来回跳。Vite替代Webpack,冷启动和热更新都快了一个量级,改一行代码瞬间看到效果,开发体验上了不止一个台阶。 核心的表格渲染引擎,我锁定了[Luckysheet](https://github.com/dream-num/Luckysheet)。这是国内团队做的一个开源在线电子表格,长得跟Excel几乎一模一样。说实话,看到它的demo那天我差点没睡着——这不就是我要的东西吗?支持单元格编辑、公式计算、合并单元格、条件格式,甚至连图表都有。后来这个项目被字节跳动收购了,演变成了现在的Univer,但早期开源版本依然很好用。 **后端**,Spring Boot 2.1 + MyBatis-Plus,老牌组合,稳得一批。Java 8,不用解释。 关键的选择在**Excel解析和导出**这两块。解析选了Apache POI,老牌选手,虽然API丑得像上个世纪的东西,但胜在稳定,Excel 97到2007+通吃。导出我走了另一条路——前端用ExcelJS,后端用EasyExcel做补充。为什么?因为Luckysheet的数据在前端,前端的ExcelJS可以直接拿到每个单元格的样式信息(字体、颜色、边框),导出的效果几乎100%还原。如果走后端导出,光是把样式信息传到后端就够喝一壶的。 **数据库**,Demo阶段直接用H2嵌入式数据库,零配置启动。等你把代码clone下来,`mvn spring-boot:run`一行命令就能跑起来,MySQL都不用装。 ### 一图看全貌:现在的架构长什么样 ```mermaid flowchart TB subgraph 用户["👤 用户浏览器"] Upload["📤 上传 Excel 文件"] Edit["✏️ 在线编辑单元格"] Export["📥 导出 Excel"] end subgraph Frontend["🎨 Vue 3 + Vite 前端 (8080)"] Luckysheet["Luckysheet 表格引擎"] DirtyTracker["脏数据追踪 reactive{}"] ExcelJS["ExcelJS 导出引擎"] Router["Vue Router 路由"] end subgraph Backend["⚙️ Spring Boot 后端 (9191)"] Controller["ExcelFileController<br/>REST API"] Service["ExcelFileService<br/>业务逻辑"] Parser["POI 解析器<br/>WorkbookFactory"] ChunkStore["分块存储引擎<br/>每1000行一块"] end subgraph Storage["💾 数据层"] H2[("H2 嵌入式数据库<br/>excel_file / excel_sheet / chunk_data")] end Upload -->|"POST /api/excel/upload"| Controller Controller --> Parser Parser -->|"按Sheet逐行解析"| ChunkStore ChunkStore -->|"分批写入"| H2 Edit -->|"cellUpdated 事件"| Luckysheet Luckysheet -->|"markCellDirty()"| DirtyTracker DirtyTracker -->|"用户点保存<br/>POST /api/excel/batchUpdate"| Controller Controller --> Service Service -->|"定位 Chunk → 局部更新"| H2 Export -->|"用户点导出"| ExcelJS ExcelJS -->|"直接读 Luckysheet 数据"| Luckysheet Luckysheet -->|"GET /api/excel/{id}/data<br/>按块懒加载"| Controller Controller --> H2 Router -->|"文档列表"| Controller Controller -->|"GET /api/excel/list"| H2 style 用户 fill:#534AB7,color:#fff style Frontend fill:#4A90D9,color:#fff style Backend fill:#5CC9C1,color:#fff style Storage fill:#2C3E50,color:#fff ``` 这张图基本上就是 DataLoom 的全貌了。三个核心闭环: - **上传流**(紫色→蓝色→绿色→灰):文件从前端飞进后端,POI 拆解成 Luckysheet 格式,按 1000 行一块塞进 H2 - **编辑流**(蓝色闭环):Luckysheet 捕获每次编辑 → 脏数据追踪暂存 → 批量保存到后端 - **导出流**(蓝色闭环):ExcelJS 直接读前端 Luckysheet 数据生成 Blob 下载,不走网络 注意导出那条线——它根本不走后端。这就是为什么样式能做到 100% 还原的原因。后面会展开讲。 ## 分块存储:这个设计救了我的命 很多人做在线表格,第一反应就是把整个Excel的JSON存到数据库的一个字段里。50行的表格这么干没问题。5000行,勉强能撑。5万行呢?10万行呢? 一个10万行、20列的表格转成JSON大概有几十MB。把几十MB的JSON塞进数据库的一个字段里,MySQL直接给你脸色看——超长字段、查询慢、更新要全量替换,每一条都是死路。 我的方案是**分块存储**。每1000行切一块。用图说话: ```mermaid flowchart LR subgraph Excel["📊 原始 Excel 文件<br/>10万行 × 20列"] R0["行 0 ~ 999"] R1["行 1000 ~ 1999"] R2["行 2000 ~ 2999"] RD["..."] R99["行 99000 ~ 99999"] end subgraph DB["💾 excel_chunk 表"] C0[("Chunk #0<br/>chunk_index=0<br/>celldata_json<br/>~500KB")] C1[("Chunk #1<br/>chunk_index=1<br/>celldata_json<br/>~500KB")] C2[("Chunk #2<br/>chunk_index=2<br/>celldata_json<br/>~500KB")] CD["..."] C99[("Chunk #99<br/>chunk_index=99<br/>celldata_json<br/>~500KB")] end subgraph Edit["✏️ 编辑第 8888 行 C 列"] Locate["📍 8888 ÷ 1000 = Chunk #8"] Update["🔧 只更新 Chunk #8<br/>其余 99 块纹丝不动"] end R0 -->|"POI 解析"| C0 R1 -->|"POI 解析"| C1 R2 -->|"POI 解析"| C2 RD -->|"POI 解析"| CD R99 -->|"POI 解析"| C99 C8["Chunk #8"] -.->|"定位目标"| Locate Locate --> Update style Excel fill:#534AB7,color:#fff style DB fill:#2C3E50,color:#fff style Edit fill:#E74C3C,color:#fff ``` 传统做法是把整个 Excel 的 JSON 塞进数据库一个字段里。50 行的表格这么干没问题。5000 行勉强能撑。5 万行、10 万行?几十 MB 的 JSON 塞进去,查询慢、更新要全量替换,每一条都是死路。 分块之后,每个块只存 1000 行的单元格数据,JSON 大小控制在 500KB 左右。用户编辑第 8888 行的 C 列——8888 除以 1000 等于第 8 号块,API 只在这个块里找到那一行那一列,改了就完事。不用动其他 99 个块,IO 消耗约等于零。 这个设计还有一个额外好处:**懒加载**。打开一个 10 万行的表格,前端不用一次性把所有数据都拉下来。先加载文档的元信息(有哪些 Sheet、每个 Sheet 多少行),用户切换到某个 Sheet 时,再按块范围按需请求数据。滚动到哪加载到哪,体验跟本地 Excel 几乎没区别。 如果你也在做类似的东西,我建议别等到数据撑爆了再重构。分块存储这个决策,在架构阶段就定下来,后期改的成本太高了。 ## 上传解析:POI 的正确打开方式 上传 Excel 文件的流程,用一张时序图比文字直观得多: ```mermaid sequenceDiagram actor U as 👤 用户 participant FE as 🎨 Vue 前端 participant Ctrl as 🔧 ExcelFileController participant Svc as 📦 ExcelFileService participant POI as 📑 Apache POI participant DB as 💾 H2 数据库 U->>FE: 选择 Excel 文件 FE->>FE: el-upload 组件封装 FormData FE->>Ctrl: POST /api/excel/upload<br/>multipart/form-data Ctrl->>Ctrl: 生成 UUID 文件名<br/>保存到磁盘临时目录 Ctrl->>Svc: parseAndStore(filePath, uuidName) Svc->>POI: WorkbookFactory.create(inputStream) POI-->>Svc: Workbook 对象 Svc->>DB: INSERT excel_file 记录 loop 遍历每个 Sheet Svc->>DB: INSERT excel_sheet 记录 loop 每 1000 行一个 Chunk Svc->>POI: 逐行逐列读取单元格 POI-->>Svc: 原始 Cell 值 alt 日期类型 Svc->>Svc: DateUtil.isCellDateFormatted() ✅ else 公式类型 Svc->>POI: FormulaEvaluator.evaluate() POI-->>Svc: 计算结果值 else 数字/字符串 Svc->>Svc: 直接转换 end Svc->>Svc: 转成 Luckysheet celldata 格式 Svc->>DB: INSERT excel_chunk (celldata_json) end end Svc-->>Ctrl: 解析完成 Ctrl-->>FE: 200 OK + excelFileId FE->>FE: 跳转到编辑页 FE-->>U: 看到在线表格 🎉 ``` 1. 前端用 `<el-upload>` 组件把文件发到后端 2. 后端保存到磁盘,生成 UUID 文件名避免冲突 3. 用 Apache POI 的 `WorkbookFactory` 打开文件流 4. 遍历每个 Sheet → 遍历每一行 → 遍历每个单元格 5. 把单元格值转成 Luckysheet 能认的格式,按 1000 行分批写入数据库 第 5 步是重点。POI 解析出来的单元格类型五花八门——字符串、数字、日期、公式、布尔值、空白、错误。每种类型都要转换成 Luckysheet 的数据格式: ```json { "r": 0, "c": 1, "v": { "v": 8848, "m": "8848", "ct": { "fa": "General", "t": "n" } } } ``` 数字类型和日期类型是最容易搞混的。Excel里日期其实就是一个数字(从1900-01-01开始的天数),POI需要用`DateUtil.isCellDateFormatted()`来判断。我一开始没注意到这个细节,所有日期都变成了五位数,看着像身份证号,排查了半小时才发现是漏了日期检测。 公式的处理稍微复杂一点。POI读公式单元格时,`getCellType()`返回的是`FORMULA`类型,你需要额外用`FormulaEvaluator`去计算结果值。如果公式引用了其他Sheet的数据,`FormulaEvaluator`也可能算不出来(因为解析时可能还没加载到那个Sheet),这种情况就给个空值,让Luckysheet在前端自己算。 ## 在线编辑:脏数据追踪 Luckysheet 提供了非常完善的事件钩子。单元格内容变化有 `cellUpdated`,工具栏操作(改字体、加粗、合并单元格)有 `updated`。 但问题来了:Luckysheet 的 `cellUpdated` 只告诉你"第 3 行第 5 列变了",不会自动帮你把变化存到后端。你需要自己维护一个"脏数据"集合。 整个编辑→保存的生命周期,看这张图: ```mermaid stateDiagram-v2 [*] --> 加载完成: Luckysheet 初始化 加载完成 --> 等待编辑: 数据渲染完毕 等待编辑 --> 有脏数据: cellUpdated / updated 触发<br/>markCellDirty() 有脏数据 --> 等待编辑: 继续编辑<br/>累积更多脏数据 有脏数据 --> 保存中: 用户点击"保存"<br/>saveChanges() 保存中 --> 等待编辑: 保存成功 ✨<br/>清空 dirtyCells + ElMessage 保存中 --> 有脏数据: 保存失败 ❌<br/>保留脏数据,用户可重试 等待编辑 --> 危险操作: 用户切换 Sheet / 关闭页面 危险操作 --> 确认离开: hasUnsavedChanges = true<br/>弹窗"有未保存的修改" 确认离开 --> [*]: 用户确认放弃 确认离开 --> 保存中: 用户选择"先保存再离开" ``` 得益于 Vue 3 的 Composition API,我把脏数据追踪逻辑拆成了几个独立的函数,每个只做一件事,不用在一个巨大的组件对象里翻来翻去。核心是用 `reactive` 管理脏数据集合,key 是 `sheetId_row_col`: ```javascript // SheetEditor.vue <script setup> import { reactive } from 'vue' const dirtyCells = reactive({}) const hasUnsavedChanges = computed(() => Object.keys(dirtyCells).length > 0) function markCellDirty(r, c, newValue) { const currentSheet = window.luckysheet?.getSheet?.() if (!currentSheet) return const dbSheetId = sheetIdMap[currentSheet.index] dirtyCells[`${dbSheetId}_${r}_${c}`] = { sheetId: dbSheetId, r, c, v: newValue } } async function saveChanges() { const updates = Object.values(dirtyCells) if (updates.length === 0) { ElMessage.info('没有需要保存的修改') return } saving.value = true try { await batchUpdateCells(documentId.value, updates) Object.keys(dirtyCells).forEach(key => delete dirtyCells[key]) ElMessage.success(`保存成功,共 ${updates.length} 个单元格`) } finally { saving.value = false } } ``` 每次编辑触发`markCellDirty`往`dirtyCells`里塞数据,用户点保存时打包批量请求。 这里有一个坑:`updated`事件不会告诉你具体改了哪个单元格。它只是在工具栏操作(比如点击"加粗")后触发,你需要自己去拿当前选中的区域。我是通过`markCurrentSelectionDirty()`方法,先调用`luckysheet.getRange()`获取选中范围,然后把选中区域里所有有值的单元格都标记为脏数据。这个方法有点暴力,但胜在不会漏。 另外,Vue 3的`onBeforeUnmount`里我做了件以前容易忘的事——注销Luckysheet实例和手动绑定的DOM事件。`<script setup>`里没有`beforeDestroy`钩子了,但`onBeforeUnmount`语义更清晰,而且可以写多个,互不干扰。 ## 导出:为什么我把这件事交给了前端 说到 Excel 导出,你可能会想:后端有 EasyExcel,干嘛不用? 简单说:样式的锅。用图对比一下两种方案就清楚了: ```mermaid flowchart LR subgraph Backend["❌ 后端导出方案"] direction TB B1["Luckysheet 数据<br/>含样式信息"] -->|"序列化 + 网络传输<br/>几十 MB"| B2["后端接收"] B2 -->|"Apache POI / EasyExcel<br/>逐个单元格重建样式"| B3["生成 .xlsx 文件"] B3 -->|"再次网络传输"| B4["浏览器下载"] B5["⚠️ 样式信息传输成本高<br/>⚠️ 后端需完整重建样式引擎"] end subgraph Frontend["✅ 前端导出方案 (DataLoom 采用的)"] direction TB F1["Luckysheet 数据<br/>已在浏览器内存中"] -->|"零网络传输<br/>内存直接操作"| F2["ExcelJS 构建 Workbook"] F2 -->|"样式天然兼容<br/>无需转换"| F3["生成 Blob"] F3 -->|"FileSaver 触发下载"| F4["浏览器下载"] F5["✨ 网络开销:0<br/>✨ 样式还原:100%<br/>✨ 导出速度:秒级"] end style Backend fill:#E74C3C,color:#fff style Frontend fill:#27AE60,color:#fff ``` 后端用 EasyExcel 导出,你需要把每一个单元格的字体、字号、颜色、背景色、边框样式、对齐方式、数字格式——全都在后端重建一遍。这些信息都在前端的 Luckysheet 数据里,传到后端要经过序列化、网络传输、反序列化。一个 10 万行的表格,光样式数据的传输就能让人等到下班。 而前端的 ExcelJS 可以直接读取 Luckysheet 的数据结构(它俩的格式高度兼容),在前端内存里构建 Workbook 对象,然后输出为 Blob,通过 FileSaver 触发下载。全程不走网络,样式零丢失。 唯一的代价是:导出大文件时,浏览器可能会短暂卡顿。解决方法也简单——加个 loading 动画,告诉用户"正在生成文件,请稍候"。心理体验比硬等要好得多。 ## 四个 Phase:从"能用"到"好用"的路线图 先上一张全局路线图,看清楚每个阶段在做什么、依赖关系是什么: ```mermaid gantt title DataLoom 演进路线图 dateFormat YYYY-MM axisFormat %Y-%m section Phase 1 基础能力 ✅ 文件上传解析 :done, p1a, 2025-01, 2025-02 Luckysheet 集成 :done, p1b, 2025-02, 2025-03 分块存储 + 懒加载 :done, p1c, 2025-03, 2025-04 脏数据追踪 + 手动保存 :done, p1d, 2025-04, 2025-05 前端 ExcelJS 导出 :done, p1e, 2025-05, 2025-06 section Phase 2 实时协作 ⬜ WebSocket 服务搭建 :p2a, 2025-07, 2025-08 LWW 冲突解决 :p2b, after p2a, 2025-09 在线用户列表展示 :p2c, after p2a, 2025-09 编辑广播同步 :p2d, after p2b, 2025-10 section Phase 3 增强完善 ⬜ 操作日志系统 :p3a, 2025-10, 2025-11 撤销重做 :p3b, after p3a, 2025-11 分享链接生成 :p3c, 2025-10, 2025-11 三档权限控制 :p3d, 2025-11, 2025-12 定时快照 :p3e, after p3a, 2025-12 section Phase 4 性能优化 ⬜ POI 流式读写 SXSSF :p4a, 2026-01, 2026-02 Redis 分片缓存 :p4b, after p4a, 2026-02 并发压测 + 索引优化 :p4c, after p4b, 2026-03 ``` 目前的 V1 已经跑通了**文件上传解析 → 在线编辑 → 手动保存 → 前端导出**这个最基础的闭环。一个人用没问题,但离真正意义上的协作工具还很远。后面分四个阶段来补齐。 ### Phase 1(当前 · ✅ 已完成) 这就是你现在看到的版本——上传、解析、编辑、保存、导出。基础能力拉满,但本质上是单机版的体验搬到浏览器里了。适用于"一个人改一个表"的场景。 ### Phase 2:实时协作 协同编辑是整个项目里最难啃的骨头。核心思路是给 `excel-service-demo` 扩展一个独立的 `socket-service`,新增 `ExcelWebSocketServer`,让前端通过 WebSocket 把每次编辑动作实时广播出去。 冲突解决这块,不急着上 OT 或 CRDT 那种重型方案——先用 **LWW(Last Writer Wins,最后写入者获胜)**。说白了就是"谁后改谁说了算",实现简单,覆盖 90% 的协同场景。同一个单元格两个人同时改了不同的值,服务器按时间戳取最新的那个写进去。 配套要做的:在线用户列表。文档页展示当前有哪些人在编辑这个表,头像 + 名字,谁在线一目了然。这个不只是好看——用户知道有别人在改同一个文档,自然会避免冲突。 ### Phase 3:增强完善 这时候表已经能多人协作了,得把"可靠性"和"可分享性"补上: - **操作日志**:谁在什么时候改了哪个单元格,从什么值改成什么值。一条不多地记录。出了数据事故能追责,改错了能回滚。 - **撤销重做**:现在的浏览器刷新就没了,操作日志是撤销重做的数据源。跨会话、跨设备都能回到历史状态。 - **定时快照**:每隔一段时间自动保存一份全量的表格快照。服务器崩了不至于回到解放前。 - **分享链接**:生成一个链接发给同事,点开就能看/编辑。不只是"上传文件"这一种入口,分享才是表格流转的核心路径。 - **权限控制**:三档角色——OWNER(拥有者,能删能改权限)、EDITOR(编辑者,能改数据不能删文档)、VIEWER(查看者,只能看不能动)。权限不写在代码里,存数据库,前端按角色动态渲染按钮。 ### Phase 4:性能优化 功能全了,该修路了。 - **大文件优化**:现在上传用的 POI `WorkbookFactory` 是全部读到内存再解析的。换用 `SXSSF`(流式写入)和 `XSSFReader`(流式读取),100MB+ 的 Excel 也不会 OOM。 - **Redis 分片存储**:H2 换成 MySQL 之后,大 JSON 块不能继续这么存。用 Redis 做热数据缓存,大 JSON 按 1000 行分片存进 String 类型的 key,查哪个块读哪个块,比扫数据库快一个数量级。 - **并发压测**:用 JMeter 或 wrk 模拟 50、100、200 个并发用户同时编辑,找瓶颈、加索引、调连接池,最终给出一个"建议最大并发数"。 ### 做完四个 Phase 之后 V1 是一个人能用,Phase 4 跑完之后是一个团队能依赖。从"玩具"到"工具",差的就是这四个阶段里的工程化细节。每一步都有坑,但我已经隐约看到它们在哪了——剩下的就是时间问题。 ## 总结 从零构建一个在线Excel,难点不在"能不能做出来",而在于"数据大了怎么办"和"多个用户一起改怎么办"。分块存储解决了前者,协同编辑还在解决后者的路上。 如果你也想做类似的东西,我的建议是:先跑通最小闭环,再逐层加功能。上传→解析→显示→编辑→导出,这五个节点打通了,你手里就是一个能用的产品。后面的分块优化、协同编辑、UI打磨,都是在"能用"的基础上做到"好用"。 源码我放在GitHub上了,感兴趣的朋友可以去看看。里面包括完整的后端服务和前端页面,clone下来改改配置就能跑。 --- 这就是"从零构建在线Excel"的过程。不是PPT架构师讲的那种"我们只需要三步"的爽文路线,而是一个真实的Java全栈工程师,在各种细节和坑之间来回试探的过程。但说实话,当你看到自己写的系统成功打开一个10万行的Excel,并且在浏览器里流畅地编辑时——那种感觉,值了。
AI入门者-两周AI开发钻入牛角尖,请求各位老手指导
### 问题描述 最近两周多一直在尝试AI开发,但是一直效果不佳,来试试提问能不能得到更多的思路 ### 背景信息 #### 使用的工具是codex cli,模型是GPT-5.4 - 我手上有个耦合性很高的Spring MVC单体架构项目,存在不少的缓存自研、session自研,因为自研产品有些粗糙,为了后续的发展考虑,我想重构成成熟的组件以及模块分组去掉一些耦合。 - 于是我开始按自己想法安排: 1. 先让AI大致了解项目后,划分模块(比如cache模块、secret模块和各个业务模块) 2. 让ai细化功能点,排开发计划 3. 使用Superpower的tdd方式让ai开发 - 一开始效果还不错,文档虽然很长但感觉功能点都有,但好景不长,因为看着AI说的头头是道也没什么错误,我没去检查它写的代码,一直是让他继续下一步,然后不知不觉一个下午过去了,我突然发现开发似乎没什么进展,查看修改的代码我才注意到,它说的什么“收口”或者“修复”,大多都只是改动了一点点代码(比如做了个try),但是进行了多轮思考+测试。 - 中途还有不少问题,也是我的操作失误,比如:进行多轮会话后,Superpower技能的强制tdd和先文档后动手效果逐渐变弱,让我分不清到底哪句对话该显式使用技能;因为计划的说法存在约束不够紧的漏洞,导致AI理直气壮地说它做完了。 - -- - 其实后面我有点放弃了,烧了不少token却没啥成果,最后的倔强让我把视点转向了即将要做的需求:做一套新的账户体系和支付模块。 - 吸取上面重构的教训,我打算用新的技术栈实现,然后老系统通过http来请求新系统、老系统单点登录到新系统来实现互通。 - 依旧是老办法,先文档后开发,这次遇到的问题却是:在计划和边界已拟定的情况下,如果发现先前的边界设定可能不够,业务流程细节你以为AI了解了,但实际实现却发现它没有根本没关注这些细节,这时候想修正,已经有点难了。 ### 具体疑问 到如今使用AI开发也有半个月有余了,如今的我似乎进入了死胡同,感觉如果想使用AI开发达到理想效果,我似乎得具体到每个接口文档、业务流程图都要准备得一应俱全,让AI产生?可我又想不到使用怎样的标准、工作流,何况我还没接触到怎么测试,如何验收,所以我想问问各位的经验,各位是怎么开发的呢?又是怎么利用各项工具的?