


AI 热点监控平台项目 VibeCoding 项目

需求
作为一名程序员,为了与时俱进,想要第一时间获取一些热点信息,不依赖人工搜索, 而是利用工具自动发现,指定的热点变化,或者最新热点,并且及时给用户发送通知,让我能走在信息获取的第一线
💡由于是一个比较轻量化的小需求(工具类项目),所以打算采用较为捷敏的开发方式,不用过多的人工介入和工程化
具体功能:
- 用户输入要监控的关键词,当这个关键词内容出现,(注意利用 AI识别假冒的内容),并第一时间发送通知
- 每隔一段时间,自动收集用户输入的指定范围,(比如AI 编程)内的热点,并且能够让用户看到
产品的形式:
-
响应式兼容 web 页面
-
封装成 Agent Skills 技能,能够交给其他 AI agent 来监控和发现热点
环境准备
- Vscode
- claude code /codex
- claude sonnet/gpt5.4 大模型
- 扩展 MCP (mcp 就是让 ai 获取外部的数据,操作外部的系统,增强 ai 的能力 )
- codex 内置浏览器
- context7 获取最新的文档,防止 AI 使用过时代码
-
需要安装的 skills(skill 就是 给 ai 快速学各种专业技能,各种技能生成包,本质是一份代码脚本和说使用明书)
- UI UX Pro Max 专门用来美化前端页面的技能,因为我们要开发 web 页面
- Skills Creator 专门能帮你制作新的技能,也我们要把工具封装成 Agent Skills 技能,所以可以用它来开发规范技能,让各种 AI 工具能识别
- mcp= 食材 + skills= 配方 ==> 结果
- 在 skill.sh ,找到 find skills 这个技能的安装地址进行安装,安装以后可以用这个 skill 安装其他 skills
- 找不到直接手动安装
- npx skills add anthropics/skills --skill skill-creator -g -y
- 在 终端里
<font style="color:rgb(245, 245, 244);background-color:rgb(28, 25, 23);">npx ctx7@latest setup</font>- 跟着一步步往下走,需要先去官网注册
方案设计
由于项目不复杂,不写专业提示词,让 AI 帮我们根据需求设计方案就好,提示词中一定要包含“人工确认”这四个字
▼markdown复制代码你是一位专业的程序员,现在请你根据需求,帮我设计方案,人工确认,分步骤完成开发,执行测试,帮我验收

## 需求
作为一名程序员,为了与时俱进,想要第一时间获取一些热点信息,不依赖人工搜索, 而是利用工具自动发现,指定的热点变化,或者最新热点,并且及时给用户发送通知,让我能走在信息获取的第一线
💡由于是一个比较轻量化的小需求(工具类项目),所以打算采用较为捷敏的开发方式,不用过多的人工介入和工程化
具体功能:
- 用户输入要监控的关键词,当这个关键词内容出现,(注意利用 AI识别假冒的内容),并第一时间发送通知
- 每隔一段时间,自动收集用户输入的指定范围,(比如AI 编程)内的热点,并且能够让用户看到
产品的形式:
- 响应式兼容 web 页面
- 封装成 Agent Skills 技能,能够交给其他 AI agent 来监控和发现热点

## 注意事项
1. 前端页面足够独特,不要千篇一律
2. 你需要先完成网页版,确保功能正常使用之后,再开发 Agent skills
3. 项目需要利用 AI 来识别热点,请你理由 Openrouter 来对接 AI 服务,帮我快速把 AI 接入到项目中
把需求给了 ai 以后,问了我 4 个问题,我如下回答
▼markdown复制代码Plan阶段共问了 4 个问题(同一组问题触发了 3 次,可能是页面重试):

  1. [通知方式] 你希望使用哪种通知方式?- 浏览器推送通知 / 邮件通知 /
  应用内通知
  2. [API密钥] 你是否已有 OpenRouter API 密钥?
    - 已有密钥 / 需要注册 / 使用其他AI服务
  3. [部署] 项目部署方式?
    - 本地运行 / 云服务器部署 / 暂不考虑
  4. [数据源] 你最关注哪些数据源?
    - Hacker News / Reddit / GitHub Trending / RSS订阅
然后在生成文档中,我修改了一下技术方案,要求要用 vue 做前端,以及要用 python 做后端,因为个人比较熟悉,以及告知了,项目热点查询频率为 30 分钟,以及把 twitter 源去除了,因为本人没有买 twitter 的 api,最后生成了以下方案
▼markdown复制代码# AI热点监控工具 - 技术方案设计

## Context
用户希望构建一个轻量级的AI热点监控工具,能够自动跟踪关键词和行业热点,并及时发送通知。这是一个工具类项目,采用敏捷开发方式,需要较少的人工介入。项目分为两个阶段:先开发Web版本验证功能,再封装成Agent Skills供AI agent使用。

## 技术架构选型

### 前端技术栈
- **框架**: Vue 3 + Vite(快速启动,轻量级)
- **样式**: 原生CSS(手工打造独特视觉风格,符合design_sense中的warm paper风格)
- **状态管理**: Vue Composition API(项目简单,无需Pinia)
- **UI风格**:
  - 温暖的纸质背景色调(#F6F1E8)
  - 琥珀色强调色(#C8853F)
  - 粗体slab衬线标题 + Inter正文
  - 卡片式布局,带柔和阴影

### 后端技术栈
- **框架**: Python + FastAPI
- **数据存储**: SQLite(轻量级,无需额外数据库服务)
- **ORM**: SQLAlchemy
- **定时任务**: APScheduler
- **爬虫**: httpx + beautifulsoup4(或playwright用于复杂页面)
- **通知**:
  - 邮件通知(aiosmtplib)- 首选通知方式
  - Web推送通知(pywebpush)- 浏览器实时通知

### AI服务集成
- **提供商**: OpenRouter(用户已有API密钥)
- **用途**:
  1. 识别假冒/无关内容(过滤噪音)
  2. 提取热点摘要
  3. 评估内容相关性
  4. 多信息源数据聚合去重

### 热点数据源
- **网页搜索爬虫**: Google搜索(httpx + beautifulsoup4,控制频率)
- **Twitter(X) API**: 通过twitterapi.io接入
- **免费API**: Hacker News, GitHub Trending
- **可选**: RSS订阅(技术博客)
- **查询频率**:
  - 关键词监控: 每30分钟执行一次
  - 热点收集: 每30分钟执行一次

## 项目结构
ai_trending_tool/ ├── frontend/ # Vue前端 │ ├── src/ │ │ ├── components/ # 组件 │ │ ├── views/ # 页面视图 │ │ ├── services/ # API调用 │ │ ├── assets/ # 静态资源 │ │ └── styles/ # 样式文件 │ ├── public/ # 公共资源 │ ├── package.json │ └── vite.config.js ├── backend/ # Python FastAPI后端 │ ├── app/ │ │ ├── api/ # API路由 │ │ ├── services/ # 业务逻辑 │ │ │ └── scrapers/ # 数据源爬虫 │ │ ├── jobs/ # 定时任务 │ │ ├── db/ # 数据库模型 │ │ ├── ai/ # AI服务集成 │ │ └── main.py # 应用入口 │ ├── requirements.txt │ └── .env ├── skills/ # Agent Skills(第二阶段) │ └── trending-monitor.json └── README.md
▼text复制代码## 核心功能实现 ### 1. 关键词监控 **流程**: 1. 用户在Web界面输入关键词和监控范围 2. 后端定时任务(每30分钟)抓取数据源 3. 使用OpenRouter AI判断内容是否真实相关 4. 匹配成功则存储并触发通知 **AI Prompt示例**:
判断以下内容是否真正与关键词"{keyword}"相关, 排除标题党、假冒、无关内容。 返回JSON: {relevant: boolean, reason: string, confidence: number}
▼text复制代码### 2. 热点收集 **流程**: 1. 用户设置监控领域(如"AI编程") 2. 定时任务(每30分钟)从多个数据源抓取 3. AI聚合、去重、排序热点 4. 生成热点摘要存入数据库 5. 前端展示热点列表(按时间/热度排序) **AI Prompt示例**:
从以下内容中提取"{domain}"领域的前10个热点, 排除重复、过时、无关内容。 返回JSON数组: [{title, summary, source, score, tags}]
▼text复制代码### 3. 通知系统 - **邮件通知**: aiosmtplib发送即时通知和每日摘要(首选) - **Web推送**: pywebpush + Service Worker(浏览器实时通知) - **应用内通知**: WebSocket实时推送(FastAPI WebSocket) ### 4. 数据持久化 **数据表设计**: - `keywords`: 关键词配置 - `trending_items`: 热点内容 - `notifications`: 通知记录 - `user_settings`: 用户配置 ## 开发步骤 ### 阶段1: Web版本(MVP) 1. **初始化项目结构** - 创建前后端项目 - 配置构建工具 - 设置开发环境 2. **后端核心开发** - 数据库schema设计和初始化 - OpenRouter集成(ai/openrouter.py) - 数据源爬虫(services/scrapers/) - RESTful API(api/routes.py) - 定时任务(jobs/scheduler.py,每30分钟执行) 3. **前端核心开发** - 响应式布局(支持桌面/移动) - 关键词管理页面 - 热点展示页面 - 通知设置页面 - 独特的视觉设计实现 4. **集成与测试** - 前后端联调 - AI识别准确性测试 - 通知功能测试 - 响应式适配测试 ### 阶段2: Agent Skills封装 1. **Skills定义** - 监控关键词技能 - 获取热点技能 - 配置管理技能 2. **Skills实现** - 复用后端API - 定义skill schema - 编写skill prompt - 测试skill调用 ## 技术细节 ### OpenRouter集成 ```python # backend/app/ai/openrouter.py import httpx import os async def analyze_content(prompt: str, content: str) -> str: async with httpx.AsyncClient() as client: response = await client.post( 'https://openrouter.ai/api/v1/chat/completions', json={ 'model': 'anthropic/claude-sonnet-4.6', 'messages': [ {'role': 'system', 'content': prompt}, {'role': 'user', 'content': content} ] }, headers={ 'Authorization': f"Bearer {os.getenv('OPENROUTER_API_KEY')}", 'HTTP-Referer': os.getenv('APP_URL'), 'X-Title': 'AI Trending Monitor' } ) return response.json()['choices'][0]['message']['content']
数据源爬虫示例
1. Hacker News
▼python复制代码# backend/app/services/scrapers/hackernews.py
import httpx

async def fetch_hn_trending():
    async with httpx.AsyncClient() as client:
        top_stories = await client.get('https://hacker-news.firebaseio.com/v0/topstories.json')
        ids = top_stories.json()[:30]

        stories = []
        for story_id in ids:
            story = await client.get(f'https://hacker-news.firebaseio.com/v0/item/{story_id}.json')
            stories.append(story.json())

        return stories
2. Google搜索爬虫
▼python复制代码# backend/app/services/scrapers/google.py
import httpx
from bs4 import BeautifulSoup
from urllib.parse import quote

async def search_google(keyword: str):
    async with httpx.AsyncClient() as client:
        headers = {
            'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36'
        }
        url = f'https://www.google.com/search?q={quote(keyword)}&tbm=nws'
        response = await client.get(url, headers=headers)

        soup = BeautifulSoup(response.text, 'html.parser')
        results = []

        for item in soup.select('.SoaBEf'):
            title = item.select_one('.mCBkyc')
            link = item.select_one('a')
            snippet = item.select_one('.GI74Re')

            if title and link:
                results.append({
                    'title': title.get_text(),
                    'link': link.get('href'),
                    'snippet': snippet.get_text() if snippet else ''
                })

        return results
3. Twitter(X) API
▼python复制代码# backend/app/services/scrapers/twitter.py
import httpx
import os

async def search_twitter(keyword: str, limit: int = 20):
    async with httpx.AsyncClient() as client:
        response = await client.get(
            'https://api.twitterapi.io/v1/tweets/search',
            params={'query': keyword, 'max_results': limit},
            headers={'Authorization': f"Bearer {os.getenv('TWITTER_API_KEY')}"}
        )
        return response.json().get('data', [])
关键词匹配AI判断
▼python复制代码import json

async def is_relevant_to_keyword(keyword: str, item: dict) -> bool:
    prompt = f'判断以下内容是否真正与关键词"{keyword}"相关...'
    result = await analyze_content(prompt, json.dumps(item))
    parsed = json.loads(result)
    return parsed['relevant'] and parsed['confidence'] > 0.7
验证计划
功能测试
-
关键词监控测试
- 添加关键词"Claude"
- 等待30分钟触发监控任务
- 验证AI能正确识别相关内容
- 验证通知是否送达
-
热点收集测试
- 配置"AI编程"领域
- 手动触发热点收集
- 验证AI提取的热点质量
- 验证前端展示效果
-
响应式测试
- 桌面浏览器(1920x1080)
- 平板(768x1024)
- 手机(375x667)
性能测试
- 爬虫任务执行时间
- AI响应时间
- 前端加载速度
环境变量
▼env复制代码# OpenRouter(用户已有)
OPENROUTER_API_KEY=your_openrouter_key

# Twitter API (twitterapi.io)
TWITTER_API_KEY=your_twitter_api_key

# 邮件通知(必需)
SMTP_HOST=smtp.gmail.com
SMTP_PORT=587
SMTP_USER=your_email@gmail.com
SMTP_PASS=your_app_password
NOTIFICATION_EMAIL=your_notification_email@gmail.com

# Web Push(可选)
VAPID_PUBLIC_KEY=
VAPID_PRIVATE_KEY=
VAPID_SUBJECT=mailto:your_email@example.com

# 应用配置
APP_URL=http://localhost:5173
BACKEND_PORT=8000
FRONTEND_PORT=5173

# 定时任务配置
MONITOR_INTERVAL_MINUTES=30
关键文件清单
需要创建的核心文件
backend/app/ai/openrouter.py- OpenRouter集成backend/app/services/scrapers/google.py- Google搜索爬虫backend/app/services/scrapers/twitter.py- Twitter API集成backend/app/services/scrapers/hackernews.py- Hacker News爬虫backend/app/services/scrapers/__init__.py- 数据源聚合器backend/app/services/notifier.py- 通知服务(邮件+Web Push)backend/app/jobs/scheduler.py- 定时监控任务(每30分钟)backend/app/db/models.py- 数据库模型backend/app/db/database.py- 数据库连接backend/app/main.py- FastAPI应用入口frontend/src/views/Dashboard.vue- 主仪表盘frontend/src/views/Keywords.vue- 关键词管理frontend/src/components/TrendingCard.vue- 热点卡片组件frontend/src/styles/theme.css- 独特视觉风格(warm paper主题)
风险与挑战
- AI识别准确性: 需要调优prompt,可能需要多轮测试
- 数据源限流:
- Google搜索爬虫易被检测,需要添加延迟和User-Agent伪装
- Twitter API有rate limit,需要实现请求队列
- 通知可靠性:
- Web Push需要用户授权
- 邮件可能进垃圾箱,需要配置SPF/DKIM
- 成本控制:
- OpenRouter API调用需要监控用量
- twitterapi.io收费(需确认套餐)
- 多信息源聚合: 需要AI有效去重和排序
下一步行动
待用户确认方案后,按以下顺序执行:
- 初始化项目结构和依赖
- 实现后端核心功能
- 实现前端界面
- 集成测试
- 部署并收集反馈
- 开发Agent Skills(第二阶段)
▼text复制代码根据一下 todo list 来完成 ```markdown 1. 初始化项目结构 [已完成] - 创建前后端项目目录、配置文件、依赖管理 2. 实现后端数据库层 [已完成] - SQLAlchemy 模型、数据库连接、初始化 3. 实现OpenRouter AI集成 [已完成] - AI 内容分析、相关性判断、热点提取、摘要生成 4. 实现数据源爬虫 [已完成] - Hacker News、GitHub、Google News、Twitter 爬虫 5. 实现后端API和定时任务 [已完成] - RESTful API 路由、APScheduler 定时任务(每30分钟) 6. 实现通知系统 [已完成] - 邮件通知(aiosmtplib)和 Web Push(pywebpush) 7. 实现前端界面 [已完成] - Vue 3 页面、组件、API 调用、warm paper 主题样式 8. 集成测试和验收 [已完成] - 前后端联调、AI 准确性测试、通知测试
我开了,全自动模式,不要求 ai 每次编辑都询问,但在每次做完一个 task,都要询问我是否继续,我会手动的压缩一下上下文,/compact 去节约 token 用量,中途有些比较需要权限的 bash 任务 AI 也会顺问我,完成以后 我给 AI 提出了,
最后 ai 完成了,我让他写一个启动和对那些东西进行配置的文档,语句如下,
“我想知道该如何启动项目,以及我哪些需要配置,写在一个 markdown 文档里”
▼markdown复制代码# 启动指南

## 环境要求

- Python 3.10+
- Node.js 18+
- pip / npm

---

## 1. 配置环境变量

编辑 `backend/.env`,填入以下配置:

```env
# ✅ 必填 —— 没有这个 AI 分析和摘要功能无法运行
OPENROUTER_API_KEY=sk-or-...

# ⚙️ 必填(如果启用邮件通知)
SMTP_HOST=smtp.gmail.com
SMTP_PORT=587
SMTP_USER=your_email@gmail.com         # Gmail 账号
SMTP_PASS=xxxx xxxx xxxx xxxx          # Gmail 应用专用密码(不是登录密码)
NOTIFICATION_EMAIL=you@example.com     # 接收通知的邮箱

# 🐦 可选 —— Twitter 数据源(当前已停用,保留字段兼容旧配置)
TWITTER_API_KEY=

# 🔔 可选 —— Web Push 浏览器推送(不填则禁用)
VAPID_PUBLIC_KEY=
VAPID_PRIVATE_KEY=
VAPID_SUBJECT=mailto:you@example.com

# 🔧 通常不需要改
APP_URL=http://127.0.0.1:5173
BACKEND_PORT=8000
MONITOR_INTERVAL_MINUTES=30
建议本地开发时前后端统一使用同一种主机名,推荐全部使用 127.0.0.1,避免 localhost / 127.0.0.1 混用导致代理或 CORS 判断不一致。
Gmail 应用专用密码获取方式
- 打开 Google 账号 → 安全性 → 两步验证(需先开启)
- 搜索"应用专用密码" → 选择"邮件" → 生成
- 将生成的 16 位密码填入
SMTP_PASS
2. 启动后端
▼bash复制代码cd backend

# 首次运行:安装依赖(建议在虚拟环境中)
pip install -r requirements.txt

# 启动服务(默认端口 8000)
uvicorn app.main:app --reload --port 8000
启动成功后会看到:
▼text复制代码INFO:     Uvicorn running on http://0.0.0.0:8000
INFO:     Scheduler started
数据库文件 trending_monitor.db 会自动创建。
3. 启动前端
新开一个终端窗口:
▼bash复制代码cd frontend

# 首次运行:安装依赖
npm install

# 启动开发服务器(默认端口 5173)
npm run dev
打开浏览器访问:http://127.0.0.1:5173
4. 功能验收
| 页面 | 验证项 |
|---|---|
| 热点页 | 空列表正常显示,"触发监控"按钮可点击 |
| 关键词页 | 添加 / 暂停 / 删除关键词 |
| 设置页 | 保存邮箱配置,发送测试邮件 |
添加关键词后,点击"触发监控"可立即测试(无需等待 30 分钟定时任务)。
5. 功能开关说明
| 功能 | 依赖配置 | 未配置时的行为 |
|---|---|---|
| AI 内容分析 | OPENROUTER_API_KEY | 监控任务报错,内容不会被分析 |
| 邮件通知 | SMTP_* + 设置页开启 | 发送静默失败,不影响其他功能 |
| Twitter 数据源 | TWITTER_API_KEY | 当前已停用,不参与采集 |
| Web Push | VAPID_* | 禁用,不影响邮件和应用内通知 |
| Hacker News | 无需配置 | 始终可用 |
| Bing 新闻 | 无需配置 | 始终可用(注意频率限制) |
6. 常见问题
后端启动报 ModuleNotFoundError
→ 确认已激活虚拟环境,或重新执行 pip install -r requirements.txt
前端访问报 502 Bad Gateway / API 请求失败
→ 确认后端已在 8000 端口运行
测试邮件发送失败
→ 检查 SMTP_PASS 是否为应用专用密码(非 Gmail 登录密码);确认 Gmail 已开启两步验证
OPENROUTER_API_KEY 未填时触发监控
→ 后端日志会显示 API 错误,热点列表保持空,属于正常降级行为
Bing 新闻抓不到内容
→ 先确认关键词本身有相关新闻;如果页面结构变动,日志里会看到 Bing 解析错误,后端会返回空列表
展示初步完成效果


前端美化
从这里开始我换了模型 用 codex gpt5.4 写的,因为 claude 太贵了
Ai 设计前端千篇一律,使用前端美化技能,并人工指定UI风格,让界面更新颖
- 前端美化技能UI UX pro max
- 人工提示词,指定风格
- Aceternity UI 组件库,做酷炫效果,
因为大模型训练时,看到大量 自然背景,圆角卡片,通用图标,所以形成了一种默认审美,要消除核心思路是约束
- 指定色彩方案
- 指定 UI 库
- 注入情感和场景,告诉 AI 产品调性,如科技感,极客风
- 使用前端美化技能:让AI 参考专业的 UI/UX 设计规范
写给 AI 的提示词
▼plain复制代码目前的界面风格过于死板(米白配色+传统布局),请在保证功能易用的前提下,帮我优化前端页面。

你需要利用前端美化技能(ui ux pro max)进行设计开发,并且必须采用 Aceternity UI 组件库(通过 Context7 插件来获取最新的用法),来增强网站的科技感,但注意不要过于花里胡哨,影响了页面的正常加载或使用

我自己是一位 AI 编程程序员,最求简介高效,直观酷炫,充满科技感的页面,我急切地想要发现热点,想要第一时间给大家分享有价值的内容,你需要感受我的情绪,让前端页面体现出来
如果ai卡住了,报错了,可能是重构的代码量较多,可能会出现网络中断的情况,如果一直中断,最好换个模型,或者让 ai 拆分一下任务再继续执行

以下是优化后的效果
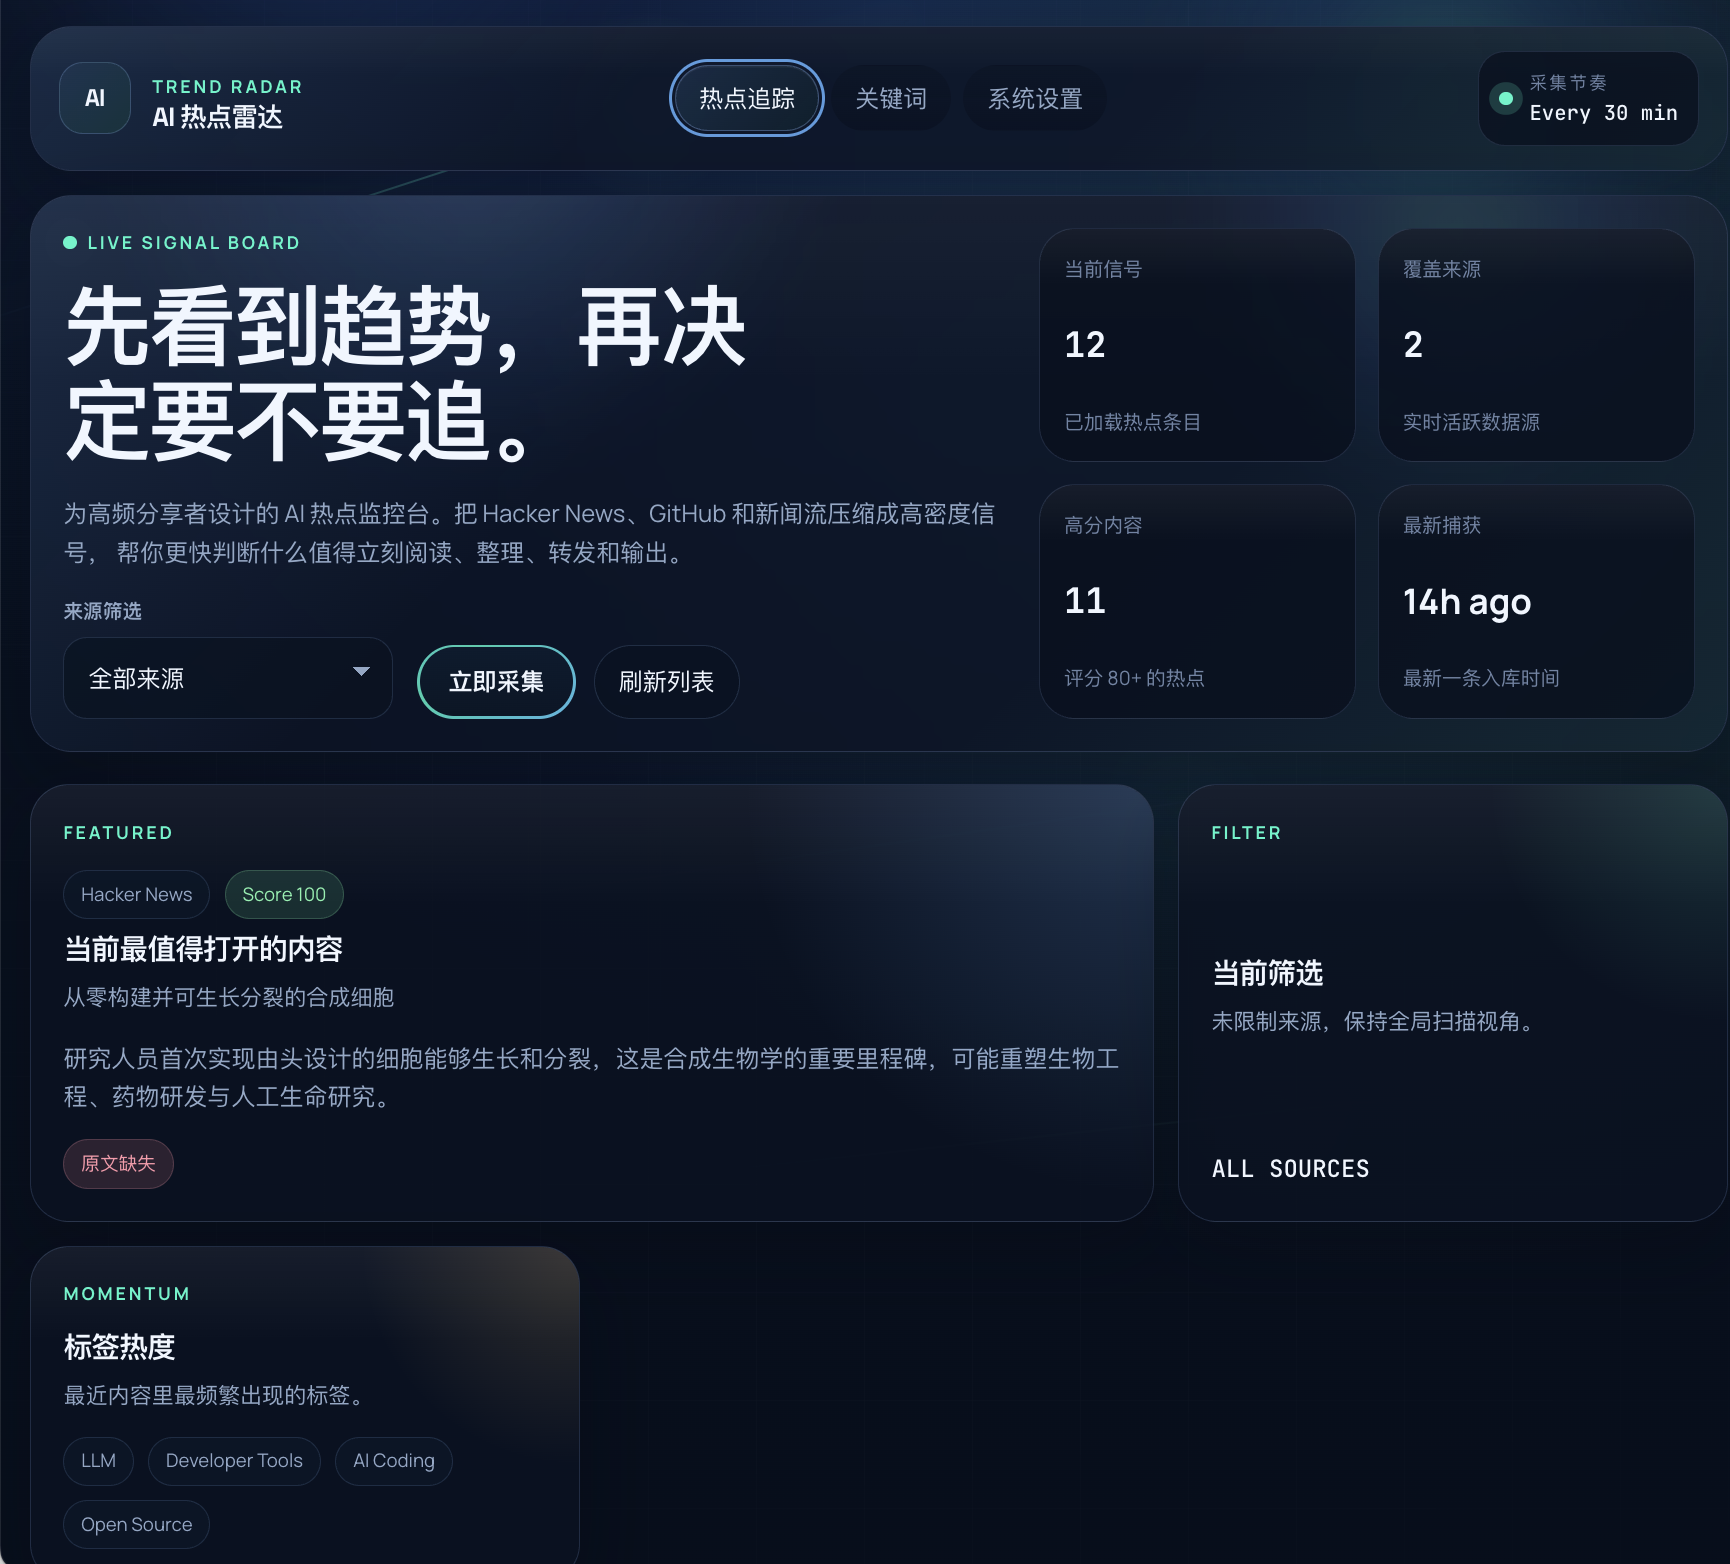
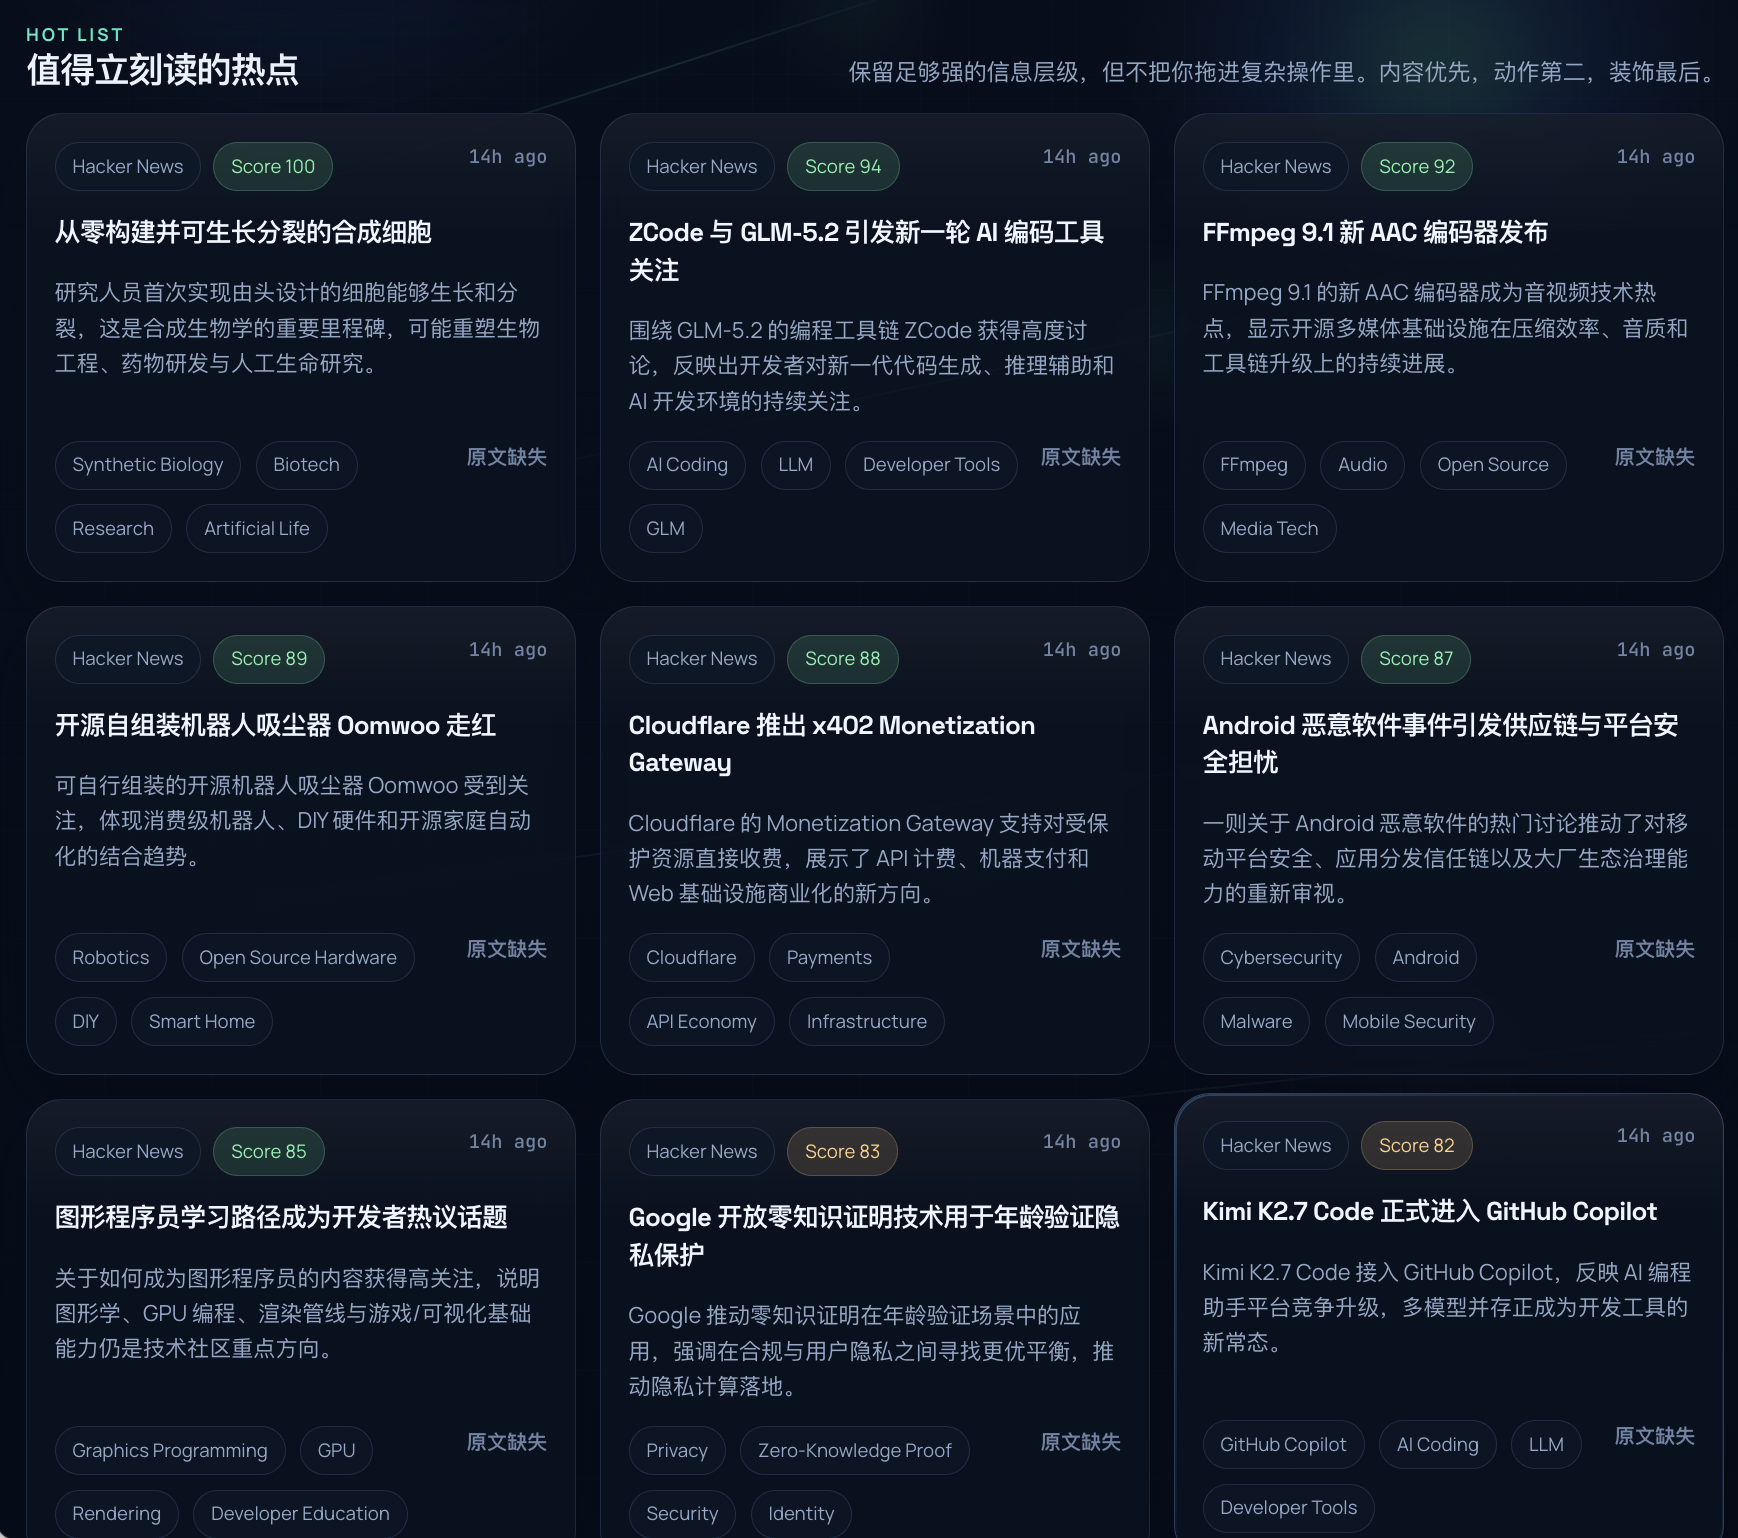
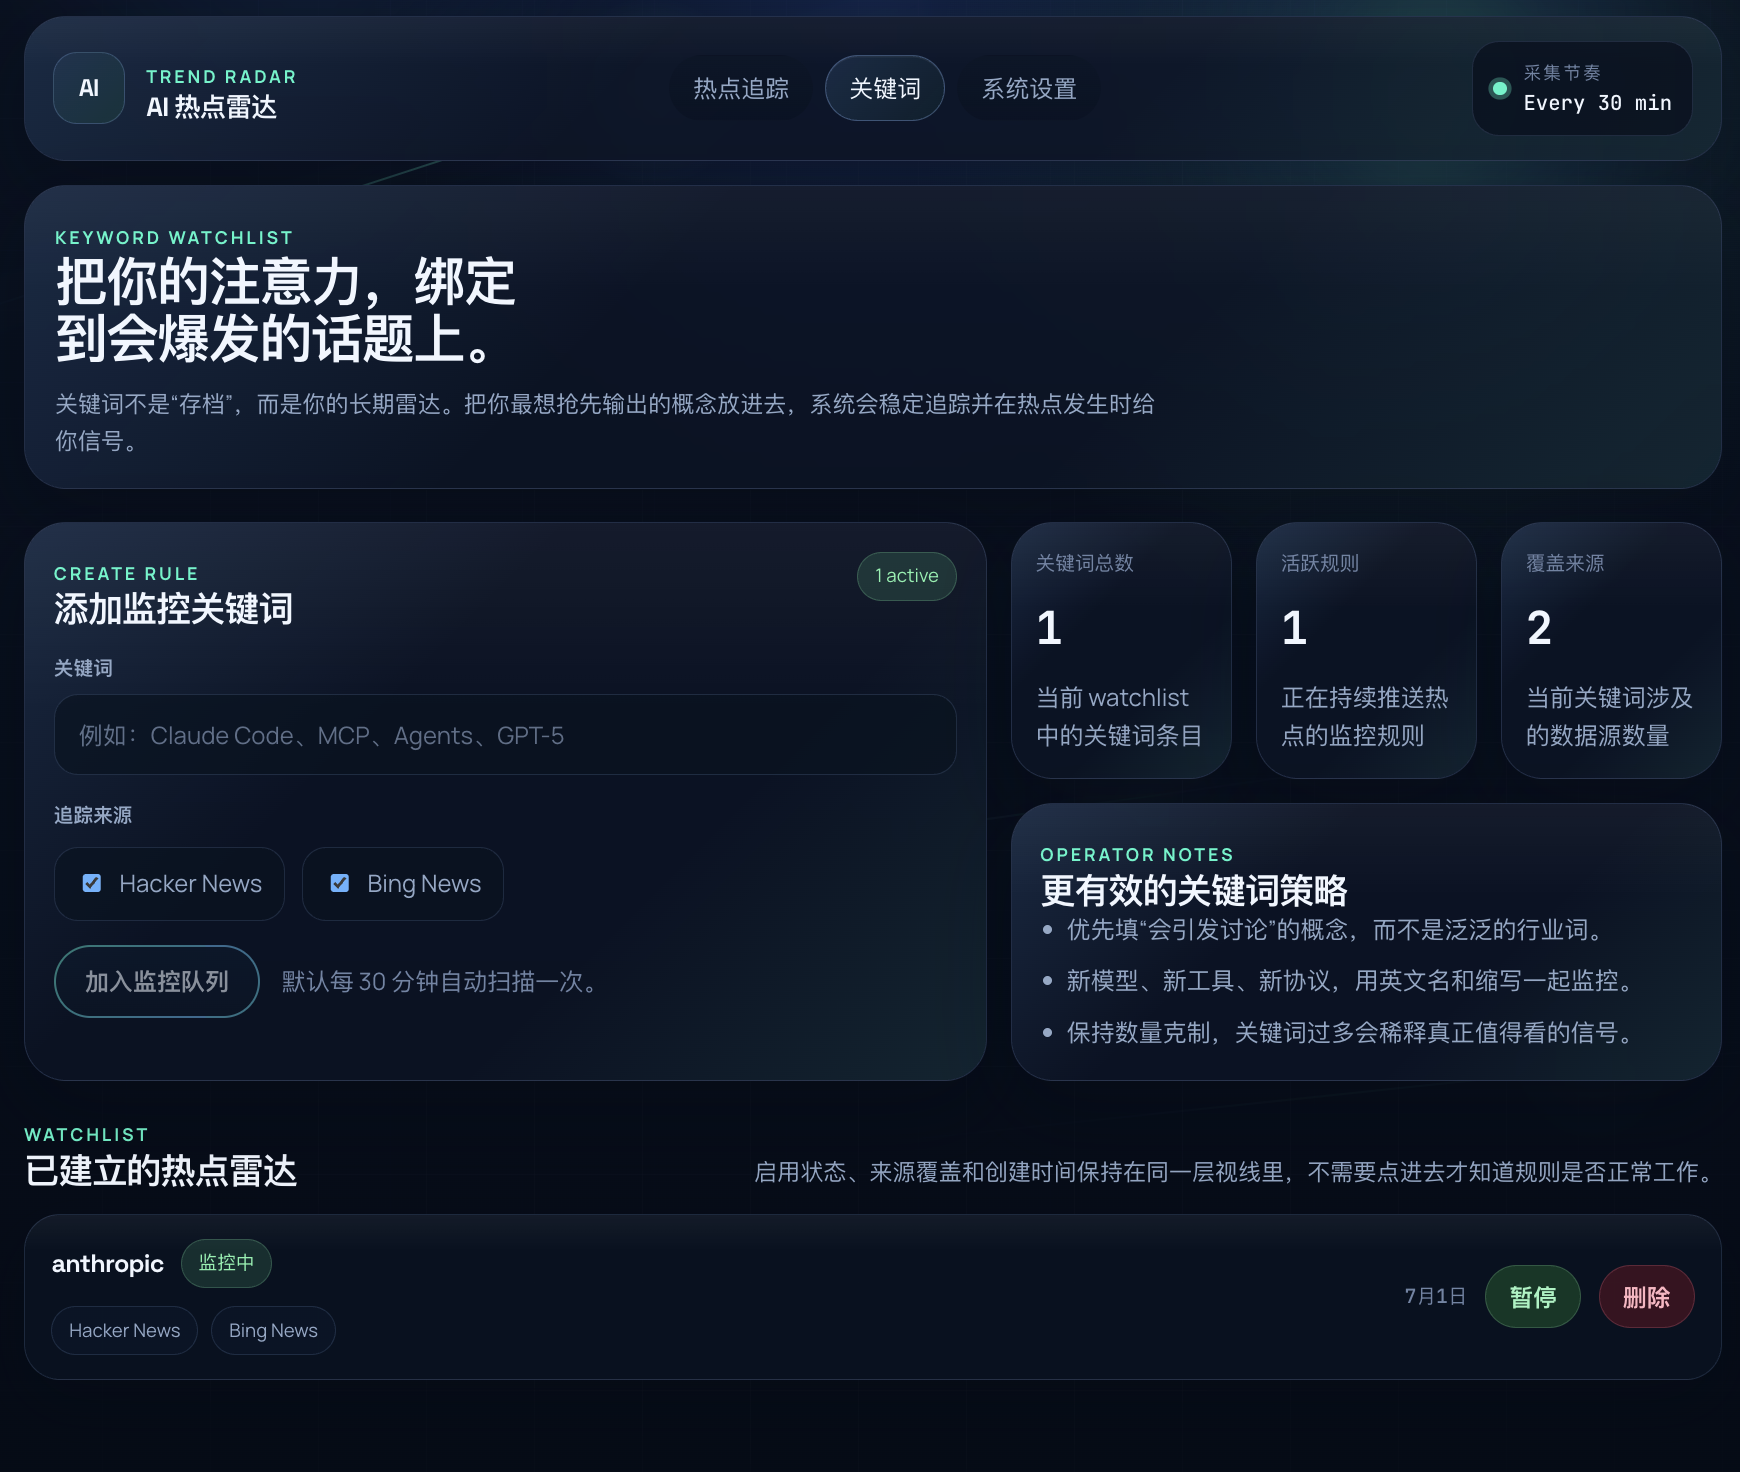

优化信息获取来源
现在的问题
- 包含了很多不知名的 weibo 回复信息,比如有些帖子的回复寥寥无几,可能是随便发一个,就被抓进来
- 信息来源比较单一,几乎全是 twitter,需要扩展一下信息来源,从多个搜索引擎来获取
所以总结下来 一个是质量不好,一个是广度度不够,说一拓宽信息源,再通过规律规则控制质量,像一个漏斗,开口要大,出口要精
解决方案
我们应该让 AI 关注一些官方和大博主,比如你想知道 claude 有没有更新,应该优先去关注官方的人,或者官方文档
这些要关注的人/账号/官方应该是动态的,比如你的关键词填写的是“科技”,那么输入完关键词,就应该自动关注科技领域的大 V; 如果你输入的是“艺术运动” 那么应该自动关注“艺术运动”相关的大 V。先不要局限于自己的思路,说不定 AI 有更好的方法,所以输入提示词
▼markdown复制代码现在的后端问题是
1. 包含了很多不知名的 weibo 回复信息,比如有些帖子的回复量寥寥无几,可能是随便发了一个,就被抓了进来
2. 信息源比较单一,基本都是 hackernews 需要扩展一下信息来源,从多个搜索引擎来获取
请你合理的实现方案,让我的信息源更可靠,注意,必须等我人工确认方案后,你才能开始执行,如果你有任何不确定的内容,必须通过提问我人工确认
AI 编程中 “先问 AI”策略,很多时候我们有自己的想法,但未必是最优解,可以先问问 AI,这是好的 AI 编程习惯
- AI 可能有更好的方案,他见过更多实现方式
- 避免思维局限
- 节省沟通成本,让 AI 出方案,再在这个基础上改
最后决定权在人手在,AI 给方案后 还是需要人工确认和调整的
在和 ai 长时间对话上下文太满,解决方案
上下文太满了,消耗太多 token,省钱,提升效果,开个新的窗口 写入以下提示词
方案一
直接 /compact 然后继续发送当前需求,如果用的 AI 工具有这个功能
方案二
开个新的窗口,然后发送以下提示词
▼markdown复制代码你是一位专业程序员,现在请你根据我的需求和方案,以及已经开发完成的前端和后端项目,在此基础上进行优化和功能扩展

## 提供给你的资料
@需求文档 AGENTS.md
@项目交互文档 STARTUP.md
必须 完整分析前端和后端已有代码

## 本次需求
@当前需求
我选择方案一 因为工具有这个功能,省力,压缩后,窗口大小只占用了百分之一、
压缩完后我把提示词发给 ai ,ai 给出了如下方案


这里我选了保留 hackernews

增加国内源
▼markdown复制代码帮我增加国内可用的搜索源,注意,不需要让我填写 API Key,
并且如果搜索的关键词本身是一个博主/官方/账号的话,
应该直接获取这个账号的信息


这里 我犯了个错误,同意了 改 weibo 那个,先搜索,关键词账号,如果搜到了,就不搜鱼关键词有关的帖子了。所以我又让 ai 改回去了,但忘记截图了。
新鲜度过滤
新鲜度过滤是了点监控的一个关键策略,本项目设置了7 天的时间窗口,超过 7 天内容会自动丢弃,原因是
- 热点有强烈的时效性,超过 7 天不再是热点
- 搜索引擎可能包含很多旧的文章
- 过滤旧的内容可以减少 ai 负担,减少 api 调用成本
这边我没写提示词,直接问 AI 当前项目有没有做 7 天过滤


Github 是 直接拉的 trending 榜,所以 没有太大的必要做筛查,所以没动


虽然少了不少,但是 AI 认为,只保留 7 天,还是必要的,毕竟这个是热点工具,只需要最新的内容

信息质量和丰富度平衡
这里体现了一个重要的工程原则,先宽后严格
数据采集要多 --> 基础过滤(去重,时间) --> AI 深度分析(相关性,真假)-> 最终展示
在数据采集阶段,要把搜索范围拓宽,不要过早过滤,过滤应该分层
- 第一层: 基础过滤(去重,时间窗口,格式校验)
- 第二层:质量过滤()
- 第三层 AI 深度分析(真假识别,相关性评分)
如果第一层就过滤过于严格,后续 AI 分析就没有用物之地了
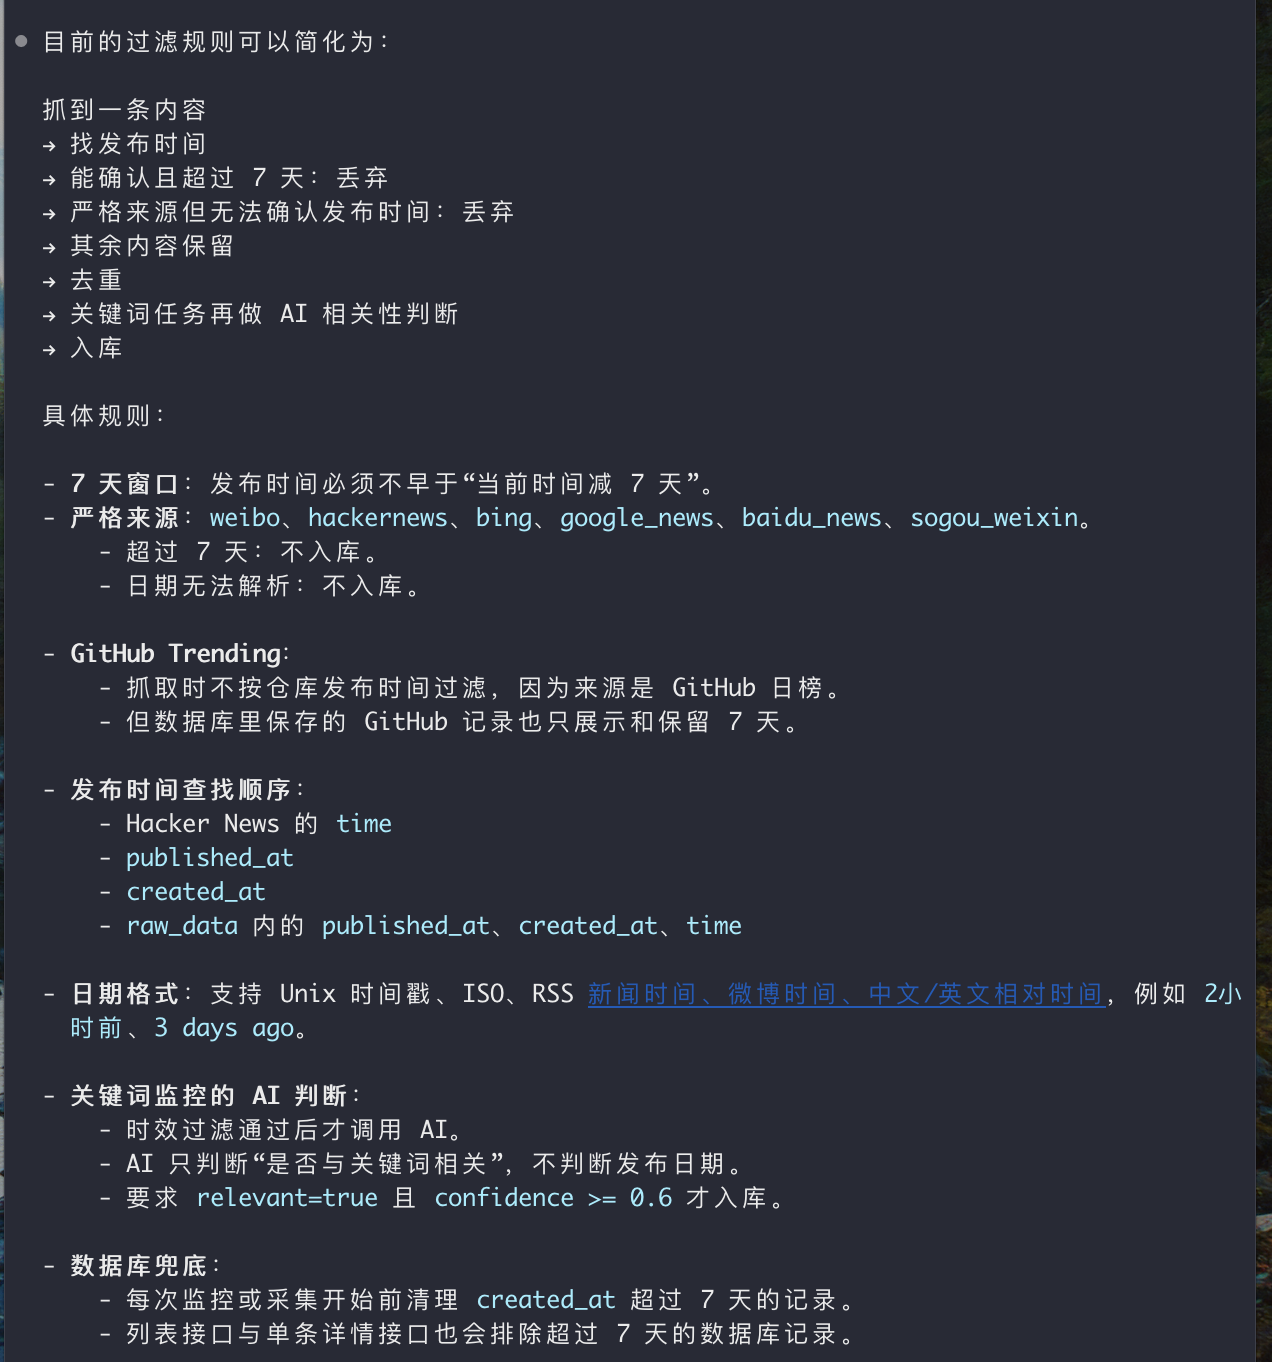

以上是 AI 终结的筛查步骤,基本符合,我要求的层级递进筛查
5.信息流筛选和排序
问题
目前我们获取到的了点全都堆在一起,不利于人工检索,因此希望能够对帖子进行节选和排序

为什么需要筛选和排序?
系统从 7 个信息源采集数据后,一次扫描可以产生几十条甚至上百条结果,如果内容平铺展示,用户需要逐条阅读才能找到有价值的信息,效率很低
筛选和排序解决了两个核心问题
- 信息过载: 通过筛选条件缩小范围,快速找到特定类型的信息
- 优先级判断:通过排序将最优价值的信息排在最前面
这是经典设计,类似电商商品筛选,和行文客服内容排序
方案设计
直接让AI 帮我分析,提供哪些筛选方式和排序,不用人工去想,让AI找我们确认
▼markdown复制代码/mention /path/to/AGENTS.md
你是一位专业的程序员,现在请你根据我的需求和方案、以及已经开发完成的前端和后端项目,在此基础上进行优化和功能扩展。

## 提供给你的资料

需求文档 AGENTS.md
必须完整分析前端和后端已有代码

## 本次需求

@当前的需求

请你先帮我思考有哪些排序和筛选方式(尽量丰富),并且找我人工确认,不要直接开始开发。


最后方案如下
热点筛选与排序
筛选
| 维度 | 可选值 | 说明 |
|---|---|---|
| 来源 | HN、Bing、Google News、百度、搜狗微信、微博,可多选 | 只看指定信息源;不选即全部来源。 |
| 发布时间 | 24 小时、3 天、7 天 | 按文章发布时间过滤。 |
| 监控关键词 | 已建立的任一关键词 | 只查看该关键词经过 AI 相关性判断后入库的内容。 |
| 最低推荐分 | 不限、60+、80+ | 筛选综合推荐分较高的内容。 |
| AI 置信度 | 不限、60%+、80%+ | 所有展示内容均来自关键词监控,因此都有该字段。 |
| 文本搜索 | 标题、摘要、媒体名 | 可搜索 Gemini、OpenAI 或媒体名称。 |
排序方式
| 排序方式 | 规则 | 说明 |
|---|---|---|
| 综合推荐 | 综合推荐分降序 | 默认方式;75% 标准化热度 + 25% 新鲜度。 |
| 热度最高 | 标准化热度降序 | 统一到 0-100,避免混用不同来源的原始分数。 |
| AI 相关性 | AI 置信度降序 | 与监控关键词最相关的内容优先。 |
| 最新发布 | 发布时间降序 | 优先展示近期发布的内容。 |
| 最新采集 | 入库时间降序 | 展示系统最近抓到的内容,不等同于文章发布时间。 |
所有排序在分数或时间相同时,都会按记录 id 倒序,保证分页顺序稳定。
当前打分逻辑
页面展示的是 recommendation_score,即综合推荐分,范围固定为 0-100。
系统已经移除全局热点采集,因此页面中的每一条内容都属于关键词监控,并且只有 AI 判断为相关、置信度不低于 0.6 的内容才会入库。
▼latex复制代码标准化热度 = AI 相关性置信度 × 75% + 来源信号 × 25%
综合推荐分 = 标准化热度 × 75% + 新鲜度 × 25%
展开后,综合推荐分的实际权重为:AI 相关性 56.25%、来源信号 18.75%、新鲜度 25%。
标准化热度
不同来源的原始数据不能直接比较,因此会先转换为 normalized_score。
| 来源 | 标准化热度逻辑 |
|---|---|
| Hacker News | 帖子分 / 18 + 评论数 / 6,最高 100 分。 |
| 微博 | 内容质量分 × 55% + 转评赞互动;账号类结果额外加入少量粉丝信号。 |
| 搜索新闻类 | 基础 35 分 + 有摘要 18 分 + 标题完整度最多 12 分 + 内容新鲜度最多 25 分。 |
所有来源在计算出来源信号后,都会与 AI 相关性置信度合成为标准化热度:AI 相关性置信度 × 75% + 来源信号 × 25%。
新鲜度
新鲜度也按 0-100 计算,并在综合推荐分中占 25%。
- 刚发布的内容接近 100 分。
- 7 天时约为 30 分。
- 无法解析发布时间时,按 55 分处理。
因此,页面上的“推荐 85”不是原始点赞数或 Hacker News 原始分数,而是将来源热度、内容质量、AI 相关性和发布时间统一后的分数。
代码入口
- 来源热度、AI 加权、新鲜度与综合推荐分:
backend/app/jobs/monitor.py - 列表筛选和排序:
backend/app/api/trending.py - 前端展示分数:
frontend/src/views/Dashboard.vue

人工测试验证
发现 内容概括出现了带 html tag 的问题,要么没有

直接让 AI 进行修复
▼markdown复制代码我:我发现,我的帖子 摘要都很有问题,这是为什么,有没有解决方案


这里为了降低 AI 开销,我选了直接 抓取,网页上的摘要,而不是通过 AI 提炼,所以效果不一定很好,但是姑且选择这种方案

修复完成后,我发现 google news 的来源还是有 html 的 herf tag 于是追问,AI 为什么 这个来源有这个问题,以下是他的回答

这里我同意他的方案,让 google news 的摘要暂时为空
AI 编写单元测试


这是一个良好的 AI 编码习惯,不仅修复 AI 问题,还验证了结果,好处是
- 自动验证,不需要人工逐个测试每种排序
- 防止回归:后续代码修改时,测试会自动检查是否破坏了排序逻辑
- 文档作用:测试代码本身就是排序规则最好的说明
UI Bug 排查技巧
前端 UI Bug(如元素被遮挡、布局错乱)在 AI 编程中 很常见。排查技巧:
- 截图给 AI:AI 可以通过截图理解问题
- 描述具体现象:比如 “筛选栏被帖子内容遮挡了”
- 提到 CSS 关键词:如
z-index、overflow、position等,帮 AI 缩小排查范围 - 浏览器开发者工具:按 F12 打开 DevTools,检查元素的样式和层级
- 推荐一个 工具,浏览器插件,可以通过点击想要 ai 修改的页面元素,直接生成对应页面元素提示词,然后直接复制到对话框里 https://github.com/oil-oil/selector
- codex桌面版 自带浏览器 可以允许你在页面上进行标注,直接发给它
成品效果图

6.优化热点信息展示
目前的问题
目前 已经展示了,重要性,来源,关键词,帖子标题 帖子描述,相关性,热度,等等但是可能还是要人工跳转到原始网站去获取一些数据,比如帖子发布时间,这都会浪费一些时间,所以目标是能够节省人工判断信息价值的时间,更快定位需要的热点信息
信息展示的设计原则
好的信息暂时应该遵循“一眼不值”原则,用户只需要看一眼,就能判断这条信息是否值得深入阅读
要实现这一点,需要在有限的空间提供关键决策信息
| 决策维度 | 对应信息 | 为什么重要 |
|---|---|---|
| 时效性 | 发布时间,抓取时间 | 判断信息是否过时 |
| 热度 | 点赞,转发,认证状态 | 判断信息关注度 |
| 可信度 | 作者信息,认证状态 | 判断信息来源可信度 |
| 相关性 | AI 相关性评分和理由 | 判断信息是否与关注话题相关 |
| 原文链接 | 一键跳转 | 方便深入阅读原文内容 |
目前我的的界面缺少部分观点信息(如发布时间,互动数据等),导致用户需要额外跳转才能获取完整信息
提示词如下
▼markdown复制代码你是一位专业的程序员,现在请你根据我的需求和方案、以及已经开发完成的前端和后端项目,在此基础上进行优化和功能扩展。

## 提供给你的资料

plan.md
必须完整分析前端和后端已有代码

## 本次需求
目前 已经展示了,重要性,来源,关键词,帖子标题 帖子描述,相关性,热度,
等等但是可能还是要人工跳转到原始网站去获取一些数据,比如帖子发布时间,这都会浪费一些时间,
所以目标是能够节省人工判断信息价值的时间,更快定位需要的热点信息
比如还可以展示
- 抓取时间
- 更多互动数据(比如点赞,转发,等等,有的话则展示)
- AIf分析相关性的理由,支持展开折叠,以及一点展开所有帖子相关性的理由

此外,你还可以有自己的想法,比如还需要展示哪些信息(能达到我的目标),并且找我人工确认,不要直接开始开发。


成品展示

信息判断效率优化前后对比
| 维度 | 优化前 | 优化后 |
|---|---|---|
| 发布时间 | 已保存,但卡片只显示一个时间 | 明确显示“发布”和“抓取”时间 |
| 抓取时间 | 仅作为发布时间缺失时的回退 | 每条卡片固定展示,便于判断发现时效 |
| 互动数据 | 微博/HN 数据藏在 raw_data,前端不可见 | 微博显示点赞、评论、转发;账号显示粉丝、关注、博文与认证;HN 显示积分和评论 |
| 发布者/媒体 | 部分有数据但不展示 | 直接展示账号、作者或媒体/站点 |
| AI 判断 | 只有相关性置信度 | 保存简短相关性理由,支持单条展开与全部展开 |
| AI 输入 | 主要使用标题和 URL | 使用标题、来源和可用文本片段 |
| AI 异常 | 降级逻辑可能保留未经有效判断的数据 | 批次失败直接跳过,不绕开相关性阈值 |
| 历史理由 | 旧记录均为空 | 已回填最近 7 天关键词记录的 62 条理由 |
| Google News 理由 | 大量历史记录为空 | 59/63 条已有理由;其余为旧全局热点,不在当前列表展示 |
| 测试验证 | 无本次功能测试 | 13 个 pytest 通过,覆盖采集、AI 判断理由、互动指标归一化、发布者和发布时间入库;前端生产构建通过 |
7.优化 AI 分析准确度+扩展思路
我们发现 AI 保留的内容可能跟关键词没有直接关联,会导致获取的信息咋软,比如关键词是 claude 结果搜出完全无关的内容,没有提到 claude,而且 ai 摘要和相关分析也显示没有什么关系,这不利于我快速判断热点内容和匹配度

我们的目标是,优化 AI 审核热点准确度,过滤和关键词不搭相关的内容
问题 根因分析
AI 相关性分析不准确的原因可能有多个层面
- 搜索层面: 搜索引擎返回的内部本身就不够相关
- prompt 层面:给 AI 的分析提示词不够精确,没有明确要求判断“是否”
- 阈值层面: 相关评分阈值设置不合理,低相关性内容也被保留
- 评估层面: 缺乏系统化的测试机制,无法量化分析质量
解决方案
▼markdown复制代码你是一位专业的程序员,现在请你根据我的需求和方案、以及已经开发完成的前端和后端项目,在此基础上进行
  优化和功能扩展。

  必须完整分析前端和后端已有代码
  本次需求
  我们发现 AI保留的内容可能是跟关键词没有直接关联的,会导致获取到的信息杂乱。
  比如关键词是 claude 和 gemini,结果搜出现了 AI 打破 37 年数学记录、没有提到 Claude 和 Gemini
  的内容。而且 AI摘要和相关性分析没什么关系,只是在介绍内容而已,不利于我快速判断热点的内容和匹配
  度。

  我们的目标是,优化 AI 审核热点的准确度,过滤掉和关键词关联不大的内容。
  此外,你还可以有自己的想法,无论如何都要达到我的目标,并且找我人工确认,不要直接开始开发。
  要注意,由于相关性分析不像数据一样是精确的,而是一段话,所以建议让AI 自己建立测试和评估机制,节省
  我们后续测试的时间。


再让 ai 加入 query expansion 功能来提供准确度。这里我每次输入热点关键词,让 AI 生成相关的变体列表,让搜索到的内容变得更广泛,以免有漏网之鱼
为什么 Query Expansion 提高准确度
- 覆盖更多表达方式
- 跨预约覆盖中英文都能检索到
- 缩写和全称能覆盖
- 减少纰漏,不会因为关键词拼写差异,错过重要信息


优化后效果展示

SKILLS 开发
以下为提示词
▼markdown复制代码你是一位专业的程序员,现在请你根据我的需求和方案、以及已经开发完成的前端和后端项目,在此基础上进行优化和功能扩展。


## 本次需求

帮我把【热点监控工具】的能力封装为 Agent Skills,要求不影响现有项目的代码,只是额外新增一个单独的目录作为 Skills。

此外,你还可以有自己的想法,无论如何都要达到我的目标,并且找我人工确认,不要直接开始开发。并且要根据 /skill-creator 这个 skill 来给出方案
开发过程
用户
你是一位专业的程序员,现在请你根据我的需求和方案、以及已经开发完成的前端和后端项目,在此基础上进行优化和功能扩展。
本次需求
帮我把【热点监控工具】的能力封装为 Agent Skills,要求不影响现有项目的代码,只是额外新增一个单独的目录作为 Skills。
此外,你还可以有自己的想法,无论如何都要达到我的目标,并且找我人工确认,不要直接开始开发
助理
初始方案是新增
skills/ai-trending-monitor/,与backend/、frontend/隔离,但通过现有 FastAPI 接口调用热点、关键词和通知能力。默认只读;修改关键词、触发采集、发送通知等动作需要人工确认。
2. 不依赖后端的约束
用户
我不希望访问后端服务器。使用这个 Skill 的人不一定会启动这个项目后端。请直接把 Skill 写在这个文件夹,并重新给方案。
助理
方案调整为纯独立 Skill:只新增
skills/内容,不访问 FastAPI、SQLite、定时任务或本地服务。Skill 每次调用即时使用公开搜索/网页浏览采集信息,执行时效过滤、URL 去重、相关性审核、热点聚合和分享文案生成。
关键规则:
- 不访问
http://localhost:8000、http://127.0.0.1:8000或/api/v1/*。- 不读取、修改或提交项目的
backend/、frontend/、.env与数据库文件。- 只输出真实原文 URL;无发布时间、无直接证据或无法核验的内容降级或排除。
- 微博只在用户明确授权并提供当次
WEIBO_COOKIE时查询,Cookie 不写入仓库或输出。- 默认最近 7 天;原词直接命中阈值
0.60,批准扩展词命中阈值0.75。
用户
可以的,按照这个方案开发吧。
3. 初版独立 Skill
助理
已创建独立 Skill 文档,不修改前后端:
初版包含各来源策略、时效与去重规则、逐字证据要求、输出结构、分享模板和降级处理。
▼latex复制代码skills/ai-trending-monitor/
├── SKILL.md
├── examples/
└── references/
4. 补齐 skill-creator 流程
用户
你没有用
skill-creator这个技能吗?
助理
没有。前一轮只完成了 Skill 草稿,没有执行
skill-creator的完整闭环:缺少evals/evals.json、带 Skill / 无 Skill 对照、评分、benchmark、审阅页和反馈迭代。建议补 3 个评测:
- 最近 7 天 AI Agent 关键词热点监控。
- 最近 24 小时 AI 编程热点微信群简报。
- AI 模型发布在 Hacker News、新闻和微博中的多来源对比。
用户
可以。还可以观察后端写一些脚本辅助获取信息,不要纯粹靠 Markdown,用
skill-creator。
助理
会从后端提炼已验证的公开采集策略,但脚本只放在 Skill 目录,不导入项目后端、不调用本地 API。
Markdown 负责决策与审核规则;脚本负责可复现的采集、时间解析、URL 规范化、去重和 JSON 输出。
5. 新增独立采集脚本
助理
已新增:
脚本仅依赖 Python 标准库,支持:
- Hacker News、Google News RSS、GitHub、Bing、百度新闻、搜狗微信。
- 经明确授权的微博移动端候选采集。
- 标题、URL、来源、发布时间、摘要和互动指标规范化。
- 常见追踪参数清理、URL 去重、时间窗口过滤。
- 统一 JSON 输出:
scan、source_status、items、limitations。- 固定输出
backend_used: false,用于证明未调用项目后端。示例:
▼latex复制代码skills/ai-trending-monitor/scripts/collect_hotspots.py
▼bash复制代码python3 scripts/collect_hotspots.py --keyword "AI Agent" --limit 10 --pretty
助理
冒烟测试通过:Google News 成功返回候选;Hacker News 当时不可用但被标记为
unavailable,没有阻塞扫描;JSON 中backend_used为false。
6. 发现并修复来源范围问题
助理
评测发现文档与脚本不一致:文档说关键词扫描覆盖全部来源,但脚本默认仅扫描 Hacker News 和 Google News。
已修复。关键词扫描现在默认尝试以下 7 个来源,并在
source_status中透明记录成功、失败、限流或未授权状态:
▼latex复制代码hackernews, google_news, github, bing,
baidu_news, sogou_weixin, weibo
7. 第一轮 skill-creator 评测
助理
已新增:
每个任务都运行两组:
with_skill:读取并遵循ai-trending-monitorSkill。without_skill:不读取、不使用该 Skill。两组均禁止访问项目后端、前端、数据库和本地 API。
▼latex复制代码skills/ai-trending-monitor/evals/evals.json
助理
评测 1:AI Agent 热点监控
带 Skill 会先运行采集脚本,再打开原文核验。Hacker News 失败、GitHub
429限流、Bing 缺失可解析时间等情况均被明确记录;最终仅保留带真实 URL、日期、逐字证据、匹配类型和置信度的条目。无 Skill 基线也生成了候选,但没有同等明确的“每个声明来源是否实际参与”的来源状态契约。
助理
评测 2:24 小时 AI 编程简报
带 Skill 在严格的“真实 URL + 24 小时发布时间 + 直接文字证据”条件下没有发现合格热点,因此透明返回空结果,并报告 GitHub 限流、Google News 失败、微博未授权等限制,而不是用弱候选凑数量。
助理
评测 3:模型发布多来源对比
带 Skill 选择
GLM-5.3-Flash,明确分为多来源确认事实、单一来源信息和社区推测;性能、价格和替代能力等内容未被写成已证实事实。微博未授权时标记为未核验。
8. 自动评分、Benchmark 与审阅页
助理
已新增评分脚本:
它检查时间窗口、来源状态、原文 URL、发布时间、逐字证据、匹配类型、置信度、来源分层及微博未授权处理。
▼latex复制代码skills/ai-trending-monitor-workspace/iteration-1/benchmark-runs/grade_iteration.py
助理
评分器第一次只识别中文字段,误判了使用
Source Status、Published、Verbatim evidence的带 Skill 英文输出。已修正为中英文等价字段匹配后重新评分。默认
python3是 Python 3.7,而skill-creator聚合器需要 Python 3.9+,因此使用/opt/homebrew/bin/python3.10聚合 benchmark,没有修改skill-creator自身文件。
助理
第一轮 benchmark:
这个分数只衡量本轮的可审计性、安全披露和结构化输出,不代表所有实时事实均被自动验证。每个配置仅运行 1 次,且运行耗时没有持久化,
0.0s不能作为性能结论。
▼latex复制代码With Skill:    100.0%
Without Skill:  83.3%
Delta:          +0.17
助理
已使用
skill-creator提供的eval-viewer/generate_review.py生成静态审阅页:页面包含 3 个任务的带 Skill / 无 Skill 报告、评分结果和 benchmark。
▼latex复制代码skills/ai-trending-monitor-workspace/iteration-1/review.html
9. 当前状态
助理
当前产物:
Skill 初版、独立采集脚本和第一轮
skill-creator对照评测已完成。尚未收到最终人工评测反馈,也尚未打包为.skill文件。
▼latex复制代码skills/ai-trending-monitor/
├── SKILL.md
├── evals/evals.json
├── examples/
├── references/
└── scripts/collect_hotspots.py

skills/ai-trending-monitor-workspace/iteration-1/
├── benchmark.json
├── benchmark.md
├── review.html
└── benchmark-runs/grade_iteration.py
助理建议
下一步:
- 审阅
review.html中的对照输出。- 根据反馈修改
SKILL.md、来源策略、脚本或分享模板。- 第二轮加入固定网页快照、受控 fixture 或 URL/日期重抓检查,增强事实质量评测。
- 人工确认满意后,再打包为可分发的
.skill文件。
可能遇到的坑
手动提供API文档
如果AI 获取的api 文档不对,过时,可以手动投喂,发送api 网址
避免套娃优化
修复问题A ->引入问题 B ->修复问题 B->问题 A 回来了
原因是
- 每次质管局当前问题没有全局视角
- 修复师改动了之前的关键逻辑
- 需求本身存在矛盾,(既要信息丰富,又要信息质量高)
解决方法
- 设定明确的优先级 (质量>数量)
- 让 A`··I 在修改前先完整理解当前代码逻辑
- 如果3 次修复还不能解决,考虑新开上下文,或者回滚代码
Codex 权限配置速记,代码与 Git 权限
Codex 默认沙箱模式,可以通过 workspace-write 修改项目代码,但 .git/ 是受保护目录,未单独授权时无法执行 git add、git commit 或 git push。这是为了避免代理在未确认时改写提交记录、分支和远端配置。所以编辑 ~/.codex/config.toml:
▼toml复制代码[sandbox_workspace_write]
network_access = true
writable_roots = ["/Users/kawaiwong/projects/ai_trending_tool/.git"]
添加这段,保存后重新开启 Codex 会话生效。该配置只授权当前项目及其 .git,无需让沙箱使用 danger-full- access。但普通 Git 命令不一定会每次都弹出权限确认。因此真正控制“何时提交”的规则应是:只有你明确说“commit”“commit + push”时,我才执行提交或推送。这也是当前协作中最顺手的方式。


