


C
快来分享你的内容吧~
 10-03 04:21
 03-22 21:12·后端开发拆分和细节 本题我的思路如下 !image.png 这属于一个总体的思路,比较的宏观。如果拆分不够细微,是写不出来代码的查看全文加油鸭:思路清晰、善于复盘!能意识到“排序降维”和“包含关系”已是关键突破,继续拆解必成~211分享
- 2025-12-16·C++后端感觉有点迷茫,本人双非本2硕,现在研二不知道拿什么当成找工作的东西,一直是学c++的,刚写完muduo库,但是朋友劝我转java/go,不知道时间来不来得及,转的话沉没成本有点高,不知道怎么办了😔,兄弟们能不能给点建议编程导航_小y:可以问一下师兄师姐,他们主要从事的方向和 Offer 情况,C++ 的岗位需求的确是小于 Java、Go 的。可以看看编程学习路线:https://codefather.cn/course/codestudy ,而后跟着编程导航项目学习建议https://www.codefather.cn/post/1797431216467001345 实操。时间完全来记得,而且换语言并不是代表之前白学了,很多271分享
- 2025-11-23·后端开发
- 2025-04-29·C++后端整个面试流程是完全围绕简历开始的,所以八股文一个也没问。查看全文编程导航_小y:正在参加春招求职总结活动,赢取大额红包和鱼厂周边:https://codefather.cn/post/gift3510分享



米哈游2027校招|游戏引擎开发·C++/动画/物理
工作地点在上海,面向2027届(2026年9月—2027年8月毕业)的全职校招岗位~ 岗位:游戏研发-游戏引擎开发 工作职责 1.引擎模块开发与维护:参与游戏引擎核心子系统(如动画系统、物理模拟、资源管线、工具链等)的开发、功能拓展与性能优化 2.跨平台与性能工程:协助解决引擎在Windows、Android、iOS等多平台的适配性、稳定性及性能问题 3.技术方案研究与落地:在导师指导下,了解业界先进的引擎架构与解决方案,并在项目中评估与应用 任职要求 1. 扎实的计算机基础、良好的数学功底和C++编程能力 2. 在渲染 、动画、 物理 、文件 、资源复杂系统、工具链任意一个方向有深入了解 3. 至少熟悉一个OS系统(Windows/ iOS /Android/ PlayStation) 4. 良好的沟通协作能力,自驱动的学习能力和分析解决问题能力,责任心强 面向对象 2027届(2026.9-2027.8之间毕业) 校招/实习内推码:606VG 岗位链接:https://jobs.mihoyo.com?isRecommendation=true&recommendationCode=606VG#/campus/position/8959 附图中另一类内推码供其他对应招聘类型岗位使用,本岗位请按上述类型投递。 有任何问题欢迎留言咨询哈~    
# 自对弈强化学习的潜伏威胁盲区——value 标签前缀重分配
# 自对弈强化学习的潜伏威胁盲区——value 标签前缀重分配 > **适用范围声明**:本文讨论的结论适用于**MCTS + 价值网络**架构的 > 棋类自对弈强化学习(五子棋、围棋等)。纯传统搜索引擎(如带专门 > VCF/VCT 算杀模块的 NNUE 系)有显式算杀器,不存在本文讨论的 > 标签机制问题;非完美信息博弈同样不适用。 > > **与 sims 数无关**:本文结论覆盖所有搜索预算配置。修复前的 > 对抗测试中,一条累计约 2 万轮、对弈仅用 200 sims 的成熟参考管线 > 能稳定防杀,而一条已训练 6000 轮、对弈用 3600 sims 的新管线却 > 反复失守 > ——18 倍的搜索预算差距说明:**这项能力不生活在搜索里,它生活在 > 训练标签里**。高 sims 只是暂时掩盖 value 头的缺陷,永远替代不了它。 ## 1. 核心论点 **自对弈管线的 policy 标签重构(prior + Q 层次重分配)只做一半是不够的——value 标签必须从同一个分层循环里产出。** 这不是"效果更好"的优化项,是**潜伏威胁嗅觉的唯一来源**:value 标签 若继续使用访问量加权的树内 Q,潜伏杀点的信号会被访问占比稀释、 被平均化抹平,value 头永远学不会"看到对手行棋节点就预感危险", 模型对强算杀对手的失守就是结构性的、训练再久也补不回来。 这个约束**与轮次数和 sims 数都无关**:标签信号被稀释 10 倍以上, 轮次堆上去只能学出弱化版;搜索预算堆上去根本不会往杀点分配模拟。 ## 2. 现象:防杀失灵的两个不对称 实测现象(新管线对强算杀 AI 的对抗测试,3600 sims): ``` 对手的杀点落子之前: 模型自己下了一步 → 树里完全搜不到对手存在 10~20 步杀 (3600 sims 的搜索预算如同不存在) 对手的杀点落子之后: 模型立刻判断对面胜率 99% (一次网络前向就完成了) ``` 两个不对称背后是两种截然不同的认知任务: - **下之前**需要的是**前瞻推理**——沿一条正确路径连续展开约 20 层, 每层覆盖对手所有应点,暴力搜索空间是天文数字。MCTS 能算深杀 只有一个前提:value 头在杀路的早期节点上就给出强烈的负值信号, 引导搜索沿这条路分配模拟。 - **下之后**只是**模式识别**——威胁从"逻辑上存在"变成"棋盘上的 具体子力结构"(冲四、双威胁点已成型),CNN 感受野内一眼可见, 且自对弈数据里"威胁成型 → 最终获胜"的样本极多。 于是链条在源头断了,两个信号源同时哑火: ``` 信号源 1:policy 先验 杀点在棋盘上只是"一个普通空点" → policy 先验给得很低 → 3600 sims 按先验分配 → 该点只分到几次甚至 0 次模拟 → 搜索预算无效堆砌 信号源 2:value 头 "对手已有隐形杀路、但威胁点还没落子"的局面 与普通中盘局面在棋盘特征上差别很小 → 单次前向分辨不出 → 搜索在正确路径的入口处得不到引导 ``` **最硬的证据是搜索预算的对照**:参考管线对弈只用 200 sims 就能 防杀,新管线 3600 sims 反而防不住。这说明参考管线的能力不来自 搜索深度,只能来自 value 头在子节点展开时的单次前向"嗅杀"—— 而嗅杀是训练标签教出来的。 ## 3. 两种 value 标签:访问量加权 Q vs 前缀 max 重分配 ### 3.1 访问量加权树 Q(出问题的那条路) 对每个被收集的内部节点,value 标签直接取树内统计: ``` value(N) = Σ_c visits_c × (-val_c) / Σ_c visits_c ``` 即所有已访问子节点价值的**访问量加权平均**(取反为父节点视角)。 ### 3.2 前缀 max 重分配(正确的路) 把节点的网络干净先验当作"初始概率预算",在已访问子节点间按 prior 降序逐层差分切分,每层增量 (prior\[i] − prior\[i+1])×(i+1) 分配给层内(前 i+1 个走法中)Q 最高者,同时把该层的前缀 max 价值 以**同一权重**累入 value 标签: ``` for i in 已访问子节点(按 prior 降序): cnt_i = prior[i] − prior[i+1] # 该层预算(末层保留全部) cur_i = max(前 i+1 个子节点取反 Q) # 层内最优(前缀 max) policy[最优者] += cnt_i × (i+1) # policy 标签 value += cur_i × cnt_i × (i+1) # value 标签(同源权重) value /= Σ已访问 prior # 归一化 ``` ### 3.3 核心差异:极端信号是"平均掉"还是"全额保留" 一个手算例子(30 sims 量级的树,父节点为**对手行棋**局面): ``` 子节点 A:prior=0.7(正常回应),Q=+0.2(父视角),访问 7 次 子节点 B:prior=0.2(潜伏杀点),Q=+0.99(父视角),访问 3 次 访问量加权 Q(旧标签): (7×0.2 + 3×0.99) / 10 = 0.437 → 杀点信号被访问占比(0.3)稀释,再被高 prior 的平庸回应平均掉 前缀 max 重分配(新标签): i=0 层:cnt=0.5,前缀{A},cur=0.2,权重 0.5×1 i=1 层:cnt=0.2,前缀{A,B},cur=0.99,权重 0.2×2 value = (0.2×0.5 + 0.99×0.4) / 0.9 ≈ 0.551 → 杀点权重 0.4/0.9 ≈ 0.44,远超其 0.3 的访问占比, 且"max"结构保证极端值不被任何平庸回应平均掉 ``` 更尖锐的对比:若杀点只被访问 1 次(30 sims 树里的常态), 访问量加权 Q 里它的权重是 **1/30 ≈ 3%**,信号基本消失; 前缀 max 里只要它 prior 靠前,包含它的层级的 cur 就**全额** 等于它的极端价值,权重由 prior 层级决定而非访问次数决定。 这就是"只有半套"的代价:policy 侧做了层次重分配,value 侧仍是 旧 Q——同一份自对弈数据,policy 标签在教"杀点很危险", value 标签却在说"这局面还行"。 ## 4. 为什么自对弈数据本身补不上这块 一个自然的反驳:轮次够多、数据够多,Q 标签里那点稀释信号 总能学出来吧?问题在于自对弈闭环会系统性地**饥饿**这类样本: ``` 30 sims 的自对弈里,双方都看不见长杀 ↓ 潜伏威胁节点上的树内 Q 没有信号(谁都不往那搜) ↓ 对局在长杀真正成型之前,就以短杀或意外结束 ↓ "该我走、对手已有隐形杀路、且被正确标注为必败" 的样本在数据里极其稀疏 ↓ value 头对潜伏威胁的学习信号:稀疏样本 × 稀释权重 ↓ 闭环正反馈:模型看不见 → 不生成相关局面 → 更看不见 ``` 这与"物化 D4"的闭环偏置是同构的:**数据生成端缺失的东西, 训练端的技巧补不齐**。前缀 max 重分配之所以有效,恰恰因为它 不需要额外数据——它把树里**已经存在但被埋没**的信息 (杀点被访问过哪怕一次的极端价值)以正确的权重暴露给训练。 ## 5. 数学保证:telescoping 与凸组合 value 标签的归一化分母不需要单独计算。对任意按 prior 降序排列的 已访问子节点序列,层次差分权重满足恒等式: ``` Σ_i cnt_i × (i+1) = Σ_i (prior[i] − prior[i+1]) × (i+1) + prior[n−1] × n = Σ_j prior[j] (telescoping,j 取所有已访问子节点) = sum_used ``` 因此 value = Σ cur\_i × w\_i / sum\_used 中权重和恰为 1,标签是 子节点取反 Q 的**凸组合**,恒在 \[−1, 1]——与网络 tanh 输出域 严格对齐,训练目标永远不会越界。 实现上还有一个与参考实现的已知浮点差异:参考实现在每层先除 sum\_used 再累加,本文实现先累加最后除一次——数学等价(分配律), 舍入路径不同,数值对照在 1e-12 相对容差内一致(见 §7)。 ## 6. 防杀能力的完整闭环 标签修好之后,整条链路是这样的: ``` 训练时(自对弈,30 sims): 对手行棋节点 N 被收集,杀点作为 N 的高 prior 子节点 被访问过至少一次 → 前缀 max 把杀点的极端价值全额写入 N 的 value 标签 → value 头学会条件反射: "对手行棋 + 危险点在其 policy 高排位" → 直接输出悲观值 对弈时(任何 sims 数): 我方每个候选走法展开后的子节点(对手行棋局面) 被 value 头一次前向评估 → 留杀走法的子节点得分极差 → select 打差 → 自动避开 → 根本不需要搜索"看见"那条 20 步杀路 对手仍硬下出杀点时: 威胁成型 → 模式识别(本就是 value 头的强项)→ 立刻 99% ``` 注意闭环的两端都**不需要显式算杀**:搜索不用算出整条杀路, value 头也不用——它只需要把"危险点已出现在对手的候选集里" 翻译成一个悲观数。这正是 CNN 单次前向能做到的事。 ## 7. 实现状态与正确性验证 需要先划清一条界线:**§2 的现象观察来自修复前的对抗测试(问题 诊断依据),修复本身的效果尚未经过训练验证**——§6 的防杀闭环是 基于标签机制的推演,最终是否兑现,以训练后的对抗实测为准。 目前已完成的验证限于**实现正确性**: - **数值对照**:标签生成函数与参考管线原版实现做了对照——参照 实现按原版分层循环的语义独立编写,30 组随机树状态(含先验相等、零预算 层、单子节点、未访问子节点)下 policy 与 value 均在 1e-12 容差 内一致;另有 7 个手算期望用例覆盖前缀 max 语义、凸组合区间、 单子节点退化为树内 Q 等边界; - **退路完备**:重分配关闭时精确退回旧行为(访问分布 + 树内 Q); 无已访问子节点的叶子退回树内 Q;根节点**保留蒙特卡洛终局 return**——比参考管线的自举根标签更无偏,这一处不退回; - **性能**:改动位于搜索结束后的数据收集层(每手一次的冷路径), 分层循环本来就在为 policy 标签运行,value 只是同循环多两次 浮点累加,增量开销趋近于零,与搜索热路径(cpp 后端)无关; - **轮次背景**:参考管线累计约 2 万轮,新管线已训练 6000 轮—— 轮次只差 3 倍余,搜索预算却反向差 18 倍,防杀能力完全倒挂。 如果纯粹是轮次(数据量)问题,新管线 18 倍的搜索深度理应部分 弥补 value 头的不足;实际上搜索对潜伏杀点完全无效(先验低 + value 无信号,模拟根本不往杀点分配)。能同时解释两个方向差距 的变量只有标签机制——潜伏杀点信号被稀释一个数量级,是结构性 问题,也更没有理由让标签继续带病训练。 ## 8. 对后续训练的建议 1. **现有权重可直接续训**,无需重置——标签管线变更不改变网络结构; 2. **预期初期波动**:新标签分布比树内 Q 更极端(前缀 max 保留 极端值),续训最初几轮 val value 可能先升后降,这是标签迁移 而非退化,观察 3\~5 轮趋势再下判断;滑动平均的 best 判据会 自然适应新的标签水平; 3. **效果验收指标**:拿新 checkpoint 重测强算杀对手,观察 "对手落杀点之前"的胜率预判是否提前变差——这是 value 头 嗅杀能力的直接观测量,比任何离线 loss 都可靠; 4. **不要回头堆 sims**:3600 sims 防不住的,36000 也防不住—— 搜索预算的分配由 policy 先验驱动,杀点先验低的前提下, 预算是无效堆砌。 ## 9. 一句话总结 **潜伏威胁的识别不靠搜索靠标签——访问量加权的树 Q 会把杀点信号 稀释到噪声水平,只有让 value 标签与 policy 标签同源、走同一条 "prior 层级差分 + 前缀 max"的重分配之路,极端价值才能以正确的 权重抵达 value 头,模型才能在对手落子之前就闻到杀气。**
前沿讨论:人工智能在C/C++中的应用
人工智能简介 人工智能是计算机科学的一个分支,它试图理解智能的实质,并生产出一种新的能以人类智能相似方式做出反应的智能机器。人工智能的研究包括机器人、语言识别、图像识别、自然语言处理等多个领域。 C/C++在AI中的优势 1. 性能:C/C++提供了接近硬件的控制,这使得它们在执行速度和资源管理方面具有显著优势,这对于需要快速处理大量数据的AI应用至关重要。 2. 灵活性:C/C++允许程序员直接管理内存,这对于优化算法和数据结构非常有用。 3. 广泛的库支持:存在大量的C/C++库和框架,如OpenCV、TensorFlow C++ API等,它们为AI开发提供了强大的支持。 C/C++实现AI算法 1.机器学习 在机器学习领域,C/C++可以用来构建高效的算法模型。例如,使用C++实现的梯度下降算法可以用于训练神经网络。此外,C++的多线程能力也使得并行处理成为可能,从而加速了训练过程。 2.深度学习 深度学习是AI的一个子集,它使用多层神经网络来模拟人类学习的过程。C++可以用来构建和优化这些网络,如卷积神经网络(CNN)和循环神经网络(RNN)。TensorFlow和PyTorch等深度学习框架提供了C++接口,使得开发者能够利用C++的强大功能。 3.计算机视觉 计算机视觉是AI中的一个重要领域,它使计算机能够理解和解释视觉信息。C/C++在这一领域的应用包括图像处理、特征提取和模式识别。OpenCV是一个开源的计算机视觉库,它提供了大量的C/C++接口,用于图像和视频分析。 顺便吆喝一下,技术大厂,前后端测试捞人,近三周条件放宽!无论本科、还是学院派出身,如果当下你比较愁工作机会的话,可以看看>>>[机会](https://jsj.top/f/o38ijj) 以下是一个简单的C++代码示例,展示了如何实现一个基本的前馈神经网络: #include <iostream> #include <vector> #include <cmath> // 激活函数 double sigmoid(double x) { return 1.0 / (1.0 + exp(-x)); } // 神经网络类 class NeuralNetwork { public: std::vector<std::vector<double>> weights; std::vector<std::vector<double>> bias; NeuralNetwork(int inputSize, int hiddenSize, int outputSize) { // 初始化权重和偏置 weights.push_back(std::vector<double>(hiddenSize, 0.1)); weights.push_back(std::vector<double>(outputSize, 0.1)); bias.push_back(std::vector<double>(hiddenSize, 0.1)); bias.push_back(std::vector<double>(outputSize, 0.1)); } std::vector<double> forward(const std::vector<double>& input) { std::vector<double> hiddenLayer(inputSize); std::vector<double> outputLayer(hiddenSize); // 计算隐藏层 for (int i = 0; i < hiddenSize; ++i) { double sum = 0.0; for (int j = 0; j < inputSize; ++j) { sum += input[j] * weights[0]; } sum += bias[0]; hiddenLayer = sigmoid(sum); } // 计算输出层 for (int i = 0; i < outputSize; ++i) { double sum = 0.0; for (int j = 0; j < hiddenSize; ++j) { sum += hiddenLayer[j] * weights[1]; } sum += bias[1]; outputLayer = sigmoid(sum); } return outputLayer; } }; int main() { NeuralNetwork nn(2, 3, 1); // 2个输入,3个隐藏层神经元,1个输出 std::vector<double> input = {0.5, 0.2}; std::vector<double> output = nn.forward(input); std::cout << "Output: "; for (double val : output) { std::cout << val << " "; } std::cout << std::endl; return 0; } 人工智能(AI)的发展是一个全球性的进程,它正在深刻地改变着我们的生活和工作方式。 在专用人工智能领域,已经取得了突破性进展,例如在围棋、图像识别和人脸识别等方面。然而,通用人工智能领域仍处于起步阶段,目前的人工智能系统在信息感知、机器学习等“浅层智能”方面进步显著,但在概念抽象和推理决策等“深层智能”方面的能力还很薄弱 。 人工智能的创新生态布局已成为产业发展的高地,全球科技产业巨头都在积极推动人工智能技术生态的研发布局,全力抢占人工智能相关产业的制高点 。同时,人工智能的社会影响日益凸显,它在智能交通、智能家居、智能医疗等民生领域产生积极正面影响,但同时也带来了个人信息和隐私保护、知识产权、歧视和偏见、交通法规、科技伦理等问题,这些问题需要抓紧提供解决方案 。 总体来看,人工智能的发展是一个复杂而多维的过程,它不仅涉及到技术的进步,还包括社会、经济、法律和伦理等多个方面。随着技术的不断进步和政策的支持,人工智能有望在未来发挥更大的作用,推动社会向更加智能和高效的方向发展。
做题总结day2(拆分和细节,数学,模拟)
## 还没写完,明天再写 > [拆分和细节](https://leetcode.cn/problems/merge-intervals/solutions/203562/he-bing-qu-jian-by-leetcode-solution/) > 本题我的思路如下 >  这属于一个总体的思路,比较的宏观。如果拆分不够细微,是写不出来代码的 ```cpp//伪代码,写博客时时间不太够了 int left_n = 区间_n[0], right_n = 区间_n[1] // 1. 如何判断区间相交? //先想到:排序之前,区间都是乱的,需要处理的情况非常复杂。因此需要左端点升序排序 sort; bool isOverlap(int &left_n, int &right_n){ 判断right_1和left_2的大小 left_2大 return false right_1大 return true } //我的思路很差。。。没有应用好昨天总结的特殊case包含于普通case 接下来只需要判断right_1和right_2的大小,把合并区间的right更新成较大值 ```
感觉有点迷茫,本人双非本2硕,现在研二不知道拿什么当成找工作的东西,一直是学c++的,刚写完muduo库,但是朋友劝我转java/go,不知道时间来不来得及,转的话沉没成本有点高,不知道怎么办了😔,兄弟们能不能给点建议
社招-京东零售-App开发工程师岗-动态化方向(共四面)
## JD(招C++技术栈) > 岗位职责及目标: > 1. 负责全端动态化的规划和落地; > 2. 负责动态化容器、底层引擎软件架构设计及开发工作; > 3. 负责动态化容器、底层引擎的性能和内存优化; > 4. 负责动态化引擎在跨Android、iOS、鸿蒙多平台的模块设计和编码实现。 > 任职要求 > 1. 全日制本科及以上学历,计算机或相关专业; > 2. 熟悉动态化框架的架构设计和落地实现,有相关的成功经验; > 3. 精通 Android、iOS、CSS Flexbox 等布局方案; > 4. 熟悉一种原生动态化框架方案,以 JSON、XML 等 DSL 进行布局的方案; > 5. 精通移动端 Java/Kotlin,Objective-C/Swift 等平台 Native 语言编程,熟悉 C/C++ 编程者优先; > 6. 熟悉 JSC、V8、QuickJS、Hermes 任一 JS 引擎; > 7. 有良好的团队沟通、协调能力和责任心; > 8. 具备较强的自驱力和学习能力。 > 符合京东价值观:客户为先、创新、拼搏、担当、感恩、诚信。 ## 2025.11.19 一面(同伴面) 1. 介绍每个项目,面试官针对项目提问 2. 你的技术栈是什么(自我介绍里没说) 3. Java,JvaScipt,OC,Swift知道吗(和部门业务相关) 4. 算法题:字符串反转怎么实现,有几种方法可以实现?如果是对一个包含英文单词的字符串进行反转呢?(单词字符串不需要反转,只反转单词即可),有几种方法可以实现? 5. 结构体大小,有函数的结构体的大小,有shared_ptr 指针的结构体大小分别是多少? 6. 结构体前面用 alignas(64) 修饰是什么含义,对齐应该写多少合适? 7. 结构体里的变量内存布局? 8. struct 里边重写一个operator = 操作符,我们可以在结构体之外重写 operator = 操作符吗 9. std::variant 和 std::any 的区别。(注:C++17引入) 10. std::tuple (C++11 开始引入) 11. 子类 CC 继承 父类 AA,AA* aa = new CC()类初始化顺序是什么样的,成员变量初始化顺序是什么样的,构造函数的初始化列表和在构造函数里面进行的初始化,先后顺序怎样的。 12. 什么是完美转发? 13. 函数传参中传变量,传指向这个变量的指针,传引用有什么区别? 14. 常量引用会有什么限制?真的不能改吗,还是说有办法改? 15. 看过汇编代码吗? 16. C++ 中有栈内存和堆内存,在使用场景上,速度上有什么分别,或者说写代码时我们如何考量使用哪一个? 17. rust知道吗 18. vector底层数据结构,vector和 list的区别, C++ 编译器下 vector 扩容规则是啥样的 19. 实现一个生产者消费者模型。生产者生产5个东西,然后消费者开始消费这5个,消费者5个消费完了,然后生产者再生产5个,消费者再消费五个,就是这样不断的来回。 20. 一个方法里边操作一个静态变量,这个静态变量是在别处被定义的,这个方法被并发调用,如果仅仅需要保证改变量的内存可见性,我有哪些做法? 21. 互斥锁,lock_guard, 条件变量的使用 22. 是否了解模板元编程 23. 对 RAII 的理解 24. C++里面没有 GC机制,怎么能避免内存泄漏,还有尽量减少内存开销 25. 智能指针的循环引用怎么解决? 26. 平常写代码会用到哪些AI工具 27. 说下 MCP 协议 28. AI大语言模型的上游,中游,下游是指什么,你了解多少? 29. Agent 是什么,智能体是什么 30. 反问 > 下午三点面试,面到4点多,接着hr面,说是为了加快面试流程。当天晚上约了二面。 ## 2025.11.21 二面(面试官是我的+1) 1. 问项目中的一些细节 2. 场景题: 消息队列中如何控制消息是一个一个给出去的。现在有一个队列里边放多个任务(执行任务的过程可以理解为是执行函数的过程),怎么能够保证队列中的任务是一个一个被消费掉的。 3. 算法题: Leetcode 543. 求二叉树的直径 > 之前没有刷过这道题,没写出来。 > 问递归深度过深,栈溢出怎么办,答可以采用迭代法。 > 要求分别使用递归法和迭代法实现。 > 官方给的解题思路挺巧妙的,但是代码不是很友好。 > 这里给出我自己的题解,已AC,供参考: > https://leetcode.cn/problems/diameter-of-binary-tree/solutions/139683/er-cha-shu-de-zhi-jing-by-leetcode-solution/comments/3176713/ > 4. 反问 此时已经快到面试尾声,前面答的不是很好,惭愧。 - 问题1:请面试官介绍下组内业务 这个问题是激发面试官自我表达的欲望,人们都愿意分享自己熟悉的领域的事务。让面试环节有来有往。 - 问题2:如果我入职,您期待我在入职后半年,一年的时间分别具备什么样的能力,达成什么样的业绩,有什么样的产出。 > 因为特意搜过这个岗位(端动态化)的一些公众号文章,以及我自己对于JD拆的很细,让AI帮我总结了许多资料,所以面试官说到的一些业务内容和挑战我大概知道在说什么。 > 当他提到要解决什么样的问题的时候我也会联想自己过去做过什么事情,表达我有相关的经验,我有能力解决你说的这些问题。 > > 感觉得聊了半小时左右。能接住面试官的话,并针对性的做一些提问或着给出自己的理解和看法。 Tips: 反问实际上仍然是一个展示个人能力的机会。即使前面没答好,也不要放弃,试着展示自己的稳定性,对这个岗位极大的兴趣和匹配度。 ## 2025.11.26 三面(面试官是我的+2) > 两个面试官(猜测一个是 hr, 一个是 老板),面试时间40min > 前五个问题都是围绕我的项目相关的,看看就行。 > 大家专一地准备自己项目中涉及到的技术点就好。 1. 客制化内核会带来什么样的效果呢?比如说有什么样的一些提升吗? 2. 后续我们希望你在coding上能有更多的能力体现,有没有那种开发的项目?在你的技术点上体现的比较多的项目,我们讨论下? 3. 了解memory tag 吗 4. 如何定位野指针,有什么工具或者机制可以做。 5. 介绍下ASAN机制 6. 上一家工作中coding代码量大概有多少? 7. gap期间在做什么? 8. 离职时候的职级和绩效 9. AI 方面你了解什么,用过什么,做过什么 10. 反问 ## 2025.12.1 交叉面 > 跨部门的同事面,面之前网上搜了下这一面主要考察跨部门协调、沟通能力。所以提前准备了一些跨部门合作沟通解决问题的部门在项目介绍的时候去说。 问的所有问题都是围绕着项目展开的,这里我个人的工作项目对大家没有参考意义就不放出来了。 面试反问环节大家还是要精心准备两个问题。 ## 2025.12.2 进入收集薪资环节。四轮面试已通过。 > 祝看到这里的大家都好运!
华为OD C++面经
1、指针和引用 2、虚函数和纯虚函数 3、构造函数和析构函数的调用顺序 4、深拷贝和浅拷贝 5、new和malloc 6、介绍一下常用的stl和实现原理 7、介绍一下常用数据结构和排序算法 8、讲一下类型转换 9、udp和tcp的区别 10、同步和互斥 11、进程调用算法 12、进程和线程
学习方向求建议
普通一本计算机科班大四,准备考研二战,感觉考研压力不是很大,想学一下技术,12.24号研究生考完试就去找工作。但还不知道学什么更有前途一点。 ps:考的目标学校的话是个普通的211计算机技术吧。
江苏省蓝桥杯C++研究生组游寄(后续)
## 前情提要 [江苏省蓝桥杯C++研究生组游寄](https://www.codefather.cn/post/1910997813103140866) ## update C++研究生组87 / 310,省二下游,无缘国赛,希望明年最后一次能有希望进国赛看看 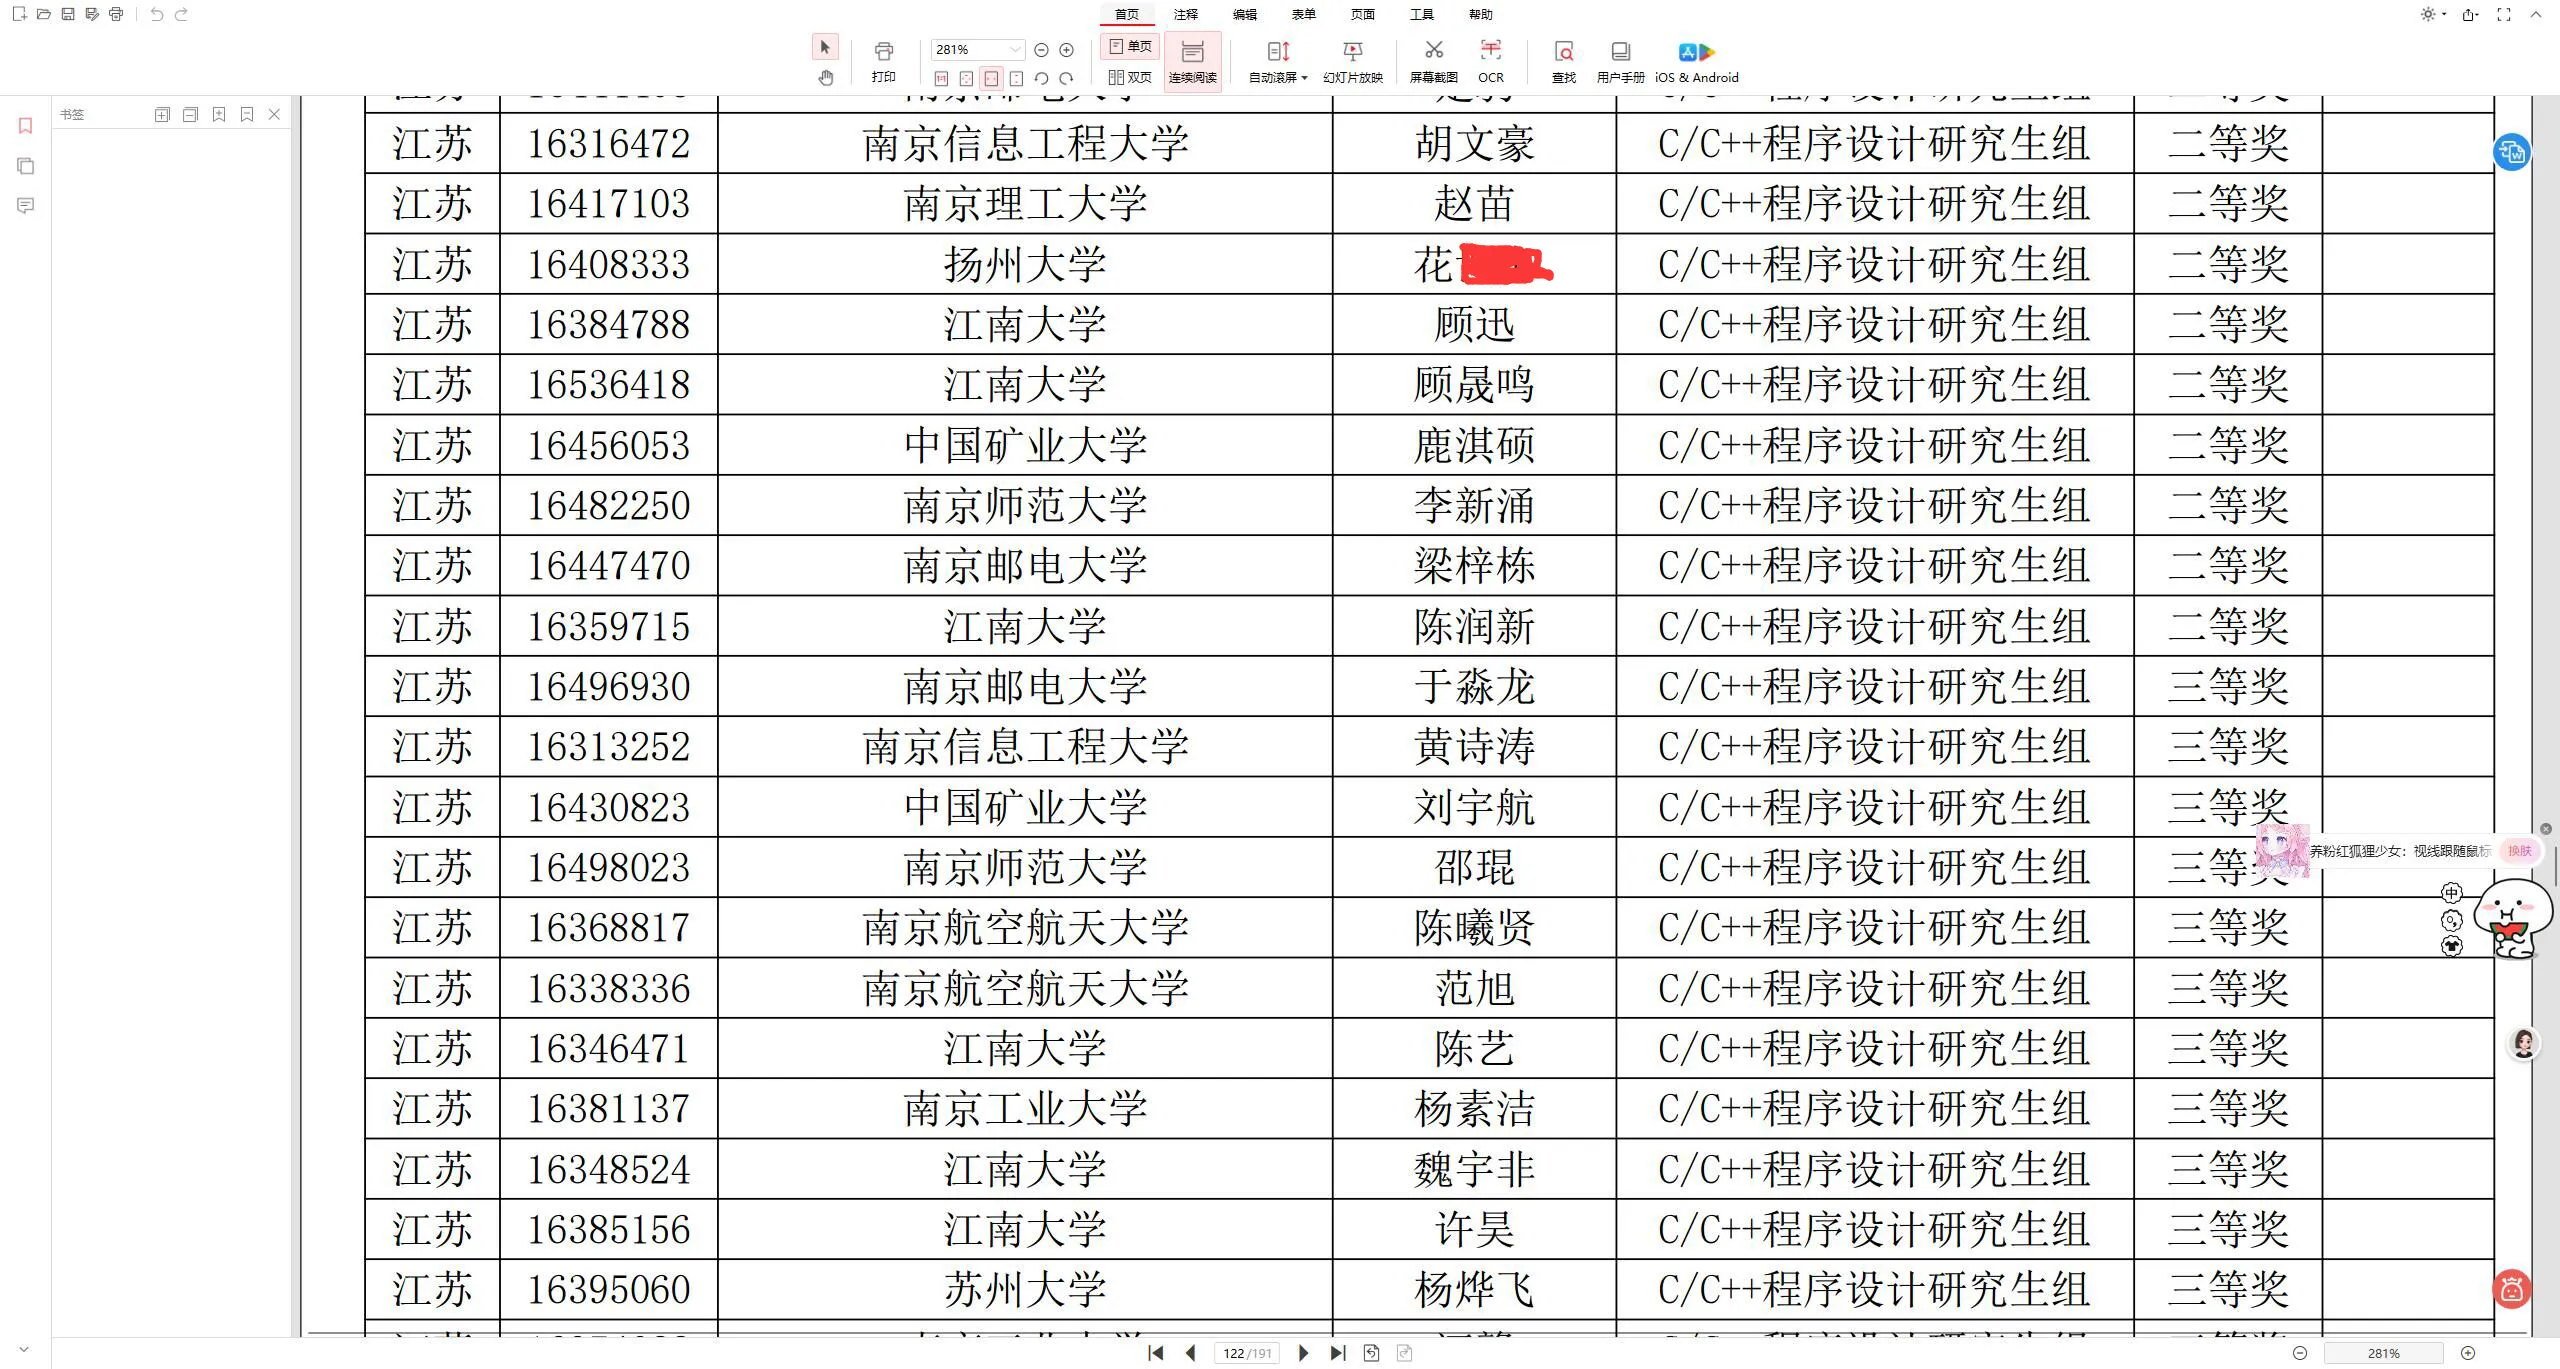 
腾讯云智一面面经
整个面试流程是完全围绕简历开始的,所以八股文一个也没问。 1. passt是什么?怎么知道passt的TCP入口流量延迟久的?如何修这个BUG? 过程太多了,见博客吧https://www.cnblogs.com/Afeather/p/18807067 2. LSM树是什么?xor过滤器的实现是什么?xor过滤器的内存消耗如何?为什么bloom过滤器可以非常小,但是却还是选择让它消耗较大的空间? LSM树自己查吧。这个只能回答如果空间给的太小了,那么过滤效果就不好了。自行查bloom过滤器吧,维基就有。 3. 虚拟音频驱动的实现是怎么做的?共享内存为什么不用锁?机器很多,如何做兼容性适配的? 虚拟机跑的是windows,实体机是linux,这个锁没法做啊,只能用串口之类的模拟锁。适配只能一台一台机子适配。 4. 如何C++实现一个定时器?有哪些方法? 基本是用`set<time_ms_t, Timer*>`,poll带了个超时参数,还可以用timer_fd,转换signal也可以。 5. 你的日志库的架构是什么,有没有可能出现日志丢失的情况?SSD建议一次写入的大小是多少? 架构是多个生产者和单个消费者,产生日志的时候会做condition_variable的提醒。丢日志这个没答好,应该说flush()会强制转交给OS的。至于SSD这个写大小,我说不需要在意,因为写入数据少的时候速度不需要考虑,多的时候自然就超过建议写入大小了。 6. 有哪些哈希函数,有时候怎么选择哈希函数? 懵了。只知道murmur hash这一类尽可能分散化值的哈希,加速计算的[fastrange](https://github.com/FastFilter/fastfilter_cpp/blob/master/src/bloom/bloom.h ),redis的hash slot。 怎么选只能具体问题具体分析